
Ogni giorno, da più di vent’anni, miliardi di email vengono lette da un classificatore che crede a una cosa palesemente falsa: che le parole di un messaggio non abbiano niente a che fare l’una con l’altra. Che «conto» e «corrente» compaiano insieme per puro caso, che «offerta» non renda più probabile «imperdibile». Su questa ipotesi ingenua — naive, appunto — si regge uno dei classificatori più longevi del machine learning. E la parte interessante non è che funzioni nonostante l’ipotesi sbagliata: è perché funziona.
Analisi discriminante e naive Bayes — due modi di classificare descrivendo — sono spiegati nel libro.
Leggi «Classificare descrivendo: analisi discriminante e naive Bayes» nel libro →
Un’idea più vecchia del computer
Il motore matematico è il teorema di Bayes, pubblicato postumo nel 1763: una regola per aggiornare una convinzione alla luce di nuove prove. L’applicazione alla classificazione automatica di testi arriva molto dopo ma comunque prima di quanto si pensi: già nei primi anni Sessanta si sperimentava l’indicizzazione automatica di documenti con classificatori bayesiani. Da qui i «60 anni» del titolo.
La consacrazione popolare arriva nel 2002, quando Paul Graham pubblica il saggio A Plan for Spam: propone di filtrare la posta indesiderata non con regole scritte a mano («blocca chi scrive VIAGRA in maiuscolo»), ma facendo imparare al filtro le probabilità delle parole dallo spam reale ricevuto da ciascun utente. L’idea viene adottata in fretta da client di posta e strumenti open source, e per anni il filtro bayesiano è lo standard di fatto contro lo spam.
Il ragionamento del filtro
Mettiamola così: sei un postino che negli anni ha visto passare migliaia di lettere, e hai imparato che certe buste — carta patinata, scritte dorate, «HAI VINTO» in stampatello — finiscono quasi sempre nel cestino del destinatario. Non sai leggere il contenuto nel suo insieme: riconosci indizi, e ogni indizio sposta la tua convinzione un po’ più in là.
Naive Bayes fa esattamente questo con le parole. Vuole calcolare la probabilità che un messaggio sia spam date le parole che contiene: P(spam | parole). Il teorema di Bayes gli permette di ribaltare il problema in quantità che si possono contare su un archivio di email già etichettate:
P(spam)— quanto spam arriva in generale (il «tasso base»: se il 40% della posta è spazzatura, si parte da lì);P(parola | spam)— quanto spesso una parola compare nei messaggi spam;P(parola | ham)— quanto spesso compare nei messaggi legittimi.
Il training, quindi, è poco più di una tabella di frequenze: si contano le parole nei due mucchi e si normalizza. Niente gradiente, niente iterazioni: una passata sui dati e il modello è pronto. È anche per questo che per decenni ha girato bene su hardware modesto, dal server aziendale al client di posta sul portatile.
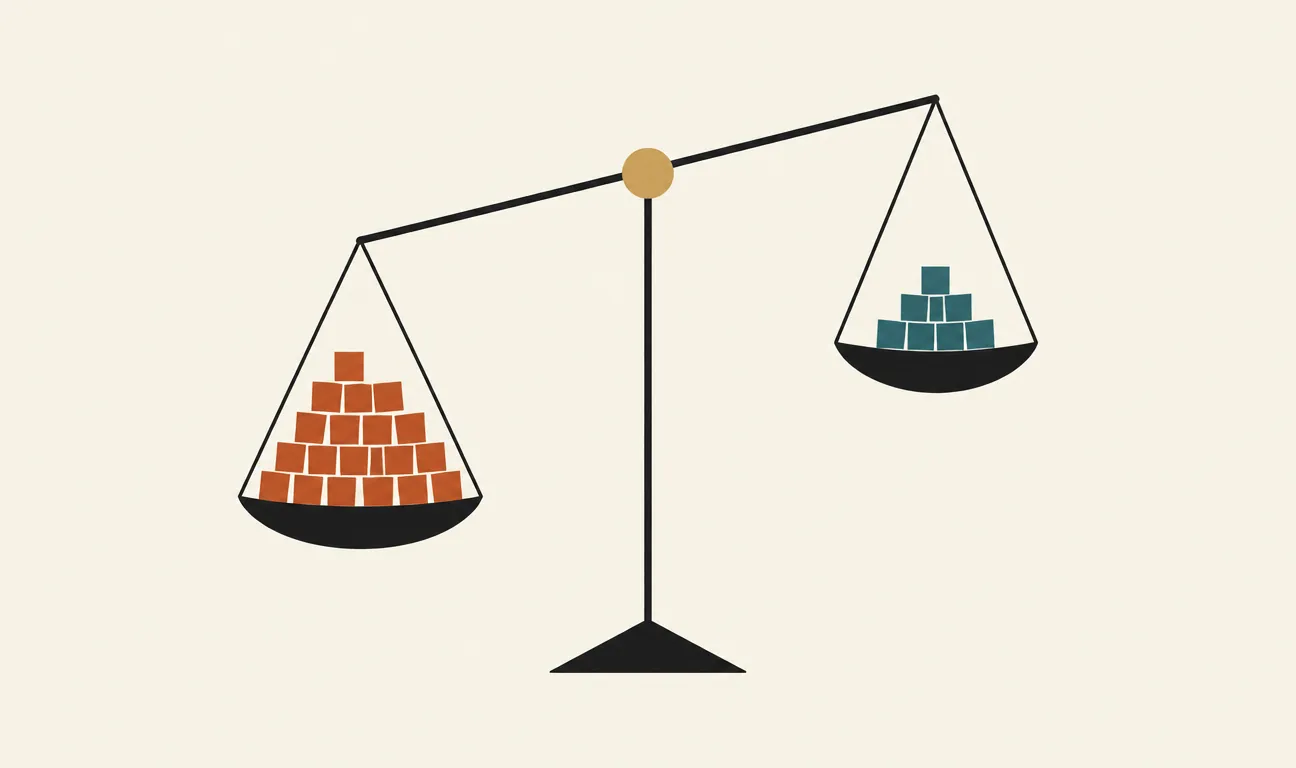
Ogni parola sposta il verdetto: quelle tipiche dello spam (terracotta) spingono in su la probabilità, quelle della posta legittima (teal) la tirano giù. Il teorema di Bayes combina tutti gli indizi in un numero solo.
Perché «naive»: la scorciatoia sull’indipendenza
Il passaggio delicato è combinare gli indizi. In teoria servirebbe P(parole | spam) per l’intera frase: la probabilità di osservare esattamente quella combinazione di parole in un messaggio spam. Ma le combinazioni possibili sono astronomicamente più numerose delle email mai scritte: nessun archivio basterebbe a stimarle.
Qui entra l’ipotesi ingenua: si assume che, una volta nota la classe, ogni parola sia indipendente dalle altre. Così la probabilità della frase diventa il semplice prodotto delle probabilità delle singole parole. Da un problema impossibile a una moltiplicazione — al prezzo di un’assunzione che sappiamo essere falsa: in un testo vero le parole si tirano a vicenda, «conto» chiama «corrente», «offerta» chiama «limitata».
Naive Bayes è la dimostrazione che un modello può avere torto sui dettagli e ragione sul verdetto.
Perché funziona lo stesso
Ed è qui che il classificatore diventa istruttivo. L’ipotesi di indipendenza distorce le probabilità: il modello tende a essere troppo sicuro di sé, perché conta due volte indizi che in realtà sono lo stesso indizio ripetuto. Se «offerta» e «imperdibile» viaggiano sempre insieme, sommarle come prove separate gonfia il punteggio.
Ma per classificare non serve la probabilità esatta: serve solo sapere quale classe vince il confronto. Se la stima corretta sarebbe 75% spam e il modello dice 97%, il numero è sbagliato ma la decisione — cestinare — è identica. La distorsione spesso gonfia entrambe le ipotesi in modo simile, e l’ordine tra le due si conserva. È come un termometro starato che segna sempre tre gradi in più: inutile per misurare la febbre con precisione, perfettamente affidabile per dire se oggi fa più caldo di ieri.
C’è poi un dettaglio tecnico diventato lezione generale: se una parola non è mai apparsa nello spam del training, la sua probabilità stimata è zero, e un prodotto con dentro uno zero azzera tutto. Basterebbe una parola nuova per «assolvere» qualunque messaggio. La cura si chiama smoothing di Laplace: si aggiunge un conteggio fittizio a ogni parola, come dire «non l’ho mai visto, ma non giuro che sia impossibile». Un piccolo atto di umiltà statistica che ogni modello dovrebbe imparare.
Il duello coevolutivo con gli spammer
Il filtro bayesiano ha anche innescato una corsa agli armamenti istruttiva. Gli spammer hanno reagito con il «Bayesian poisoning»: infarcire i messaggi di parole innocue — brani di romanzi, notizie, elenchi di termini qualunque — per diluire gli indizi incriminanti e confondere le frequenze. Oppure nascondere il testo dentro immagini, dove il conteggio delle parole non arriva. I filtri hanno risposto combinando il punteggio bayesiano con altri segnali: reputazione del mittente, analisi dei link, autenticazione del dominio.
È un pattern che ritroviamo identico oggi con i modelli linguistici: ogni classificatore messo a guardia di qualcosa genera avversari che imparano ad aggirarlo, e la difesa smette presto di essere un singolo modello per diventare un sistema a strati. Il filtro antispam è stato il primo grande caso di machine learning adversarial di massa, vent’anni prima che il termine diventasse di moda.
Perché ti riguarda
Se lavori con il machine learning, Naive Bayes è una baseline che costa pochi minuti e mette in imbarazzo modelli molto più cari: su classificazione di testi brevi (spam, sentiment, smistamento di ticket) resta competitivo, si addestra in una passata e si spiega a chiunque. Se invece l’AI la usi e basta, questo classificatore sessantenne ti insegna tre cose che valgono anche per i sistemi di oggi: i modelli possono funzionare bene per ragioni diverse da quelle per cui li abbiamo progettati; un’ipotesi falsa ma ben scelta batte un modello perfetto ma incalcolabile; e ogni sistema automatico messo a filtrare comportamenti umani finisce dentro una partita a scacchi con chi vuole aggirarlo. La prossima volta che una email sparisce nella cartella spam, ricordati che a deciderlo potrebbe essere ancora, in parte, un teorema del Settecento.
I commenti sono riservati agli iscritti.
Accedi per commentare