Ti trasferisci in una città che non conosci e devi capire se il ristorante sotto casa merita. Non hai recensioni, non hai una guida. Cosa fai? Guardi chi ci entra: se i cinque avventori più vicini al tavolo accanto sono habitué del quartiere che ordinano senza aprire il menù, ti fidi. Se sono turisti spaesati con la mappa in mano, cambi strada. Hai appena eseguito, a mente, l’algoritmo k-nearest neighbors.
k-NN è uno dei classificatori più antichi del machine learning ed è anche uno dei pochi che si può spiegare per intero in una frase: un punto nuovo appartiene alla classe più frequente tra i suoi k vicini più prossimi. Niente pesi da ottimizzare, niente discesa del gradiente, niente funzione di costo. In questo tutorial lo usiamo davvero, con codice eseguibile, e vediamo dove brilla e dove crolla.
Un algoritmo che non si allena
Quasi tutti i modelli che incontrerai — regressione logistica, alberi, reti neurali — hanno una fase di training in cui comprimono i dati in parametri: coefficienti, soglie, matrici di pesi. k-NN no. Il suo «training» consiste nel memorizzare il dataset così com’è. Tutto il lavoro avviene al momento della predizione: dato un punto nuovo, calcola la distanza da tutti i punti noti, prende i k più vicini, e fa votare le loro etichette.
Per questo si dice che k-NN è un algoritmo lazy (pigro): rimanda ogni decisione all’ultimo momento. È come uno studente che non riassume gli appunti ma fotografa ogni pagina del libro: nessuna fatica prima dell’esame, tantissima durante.
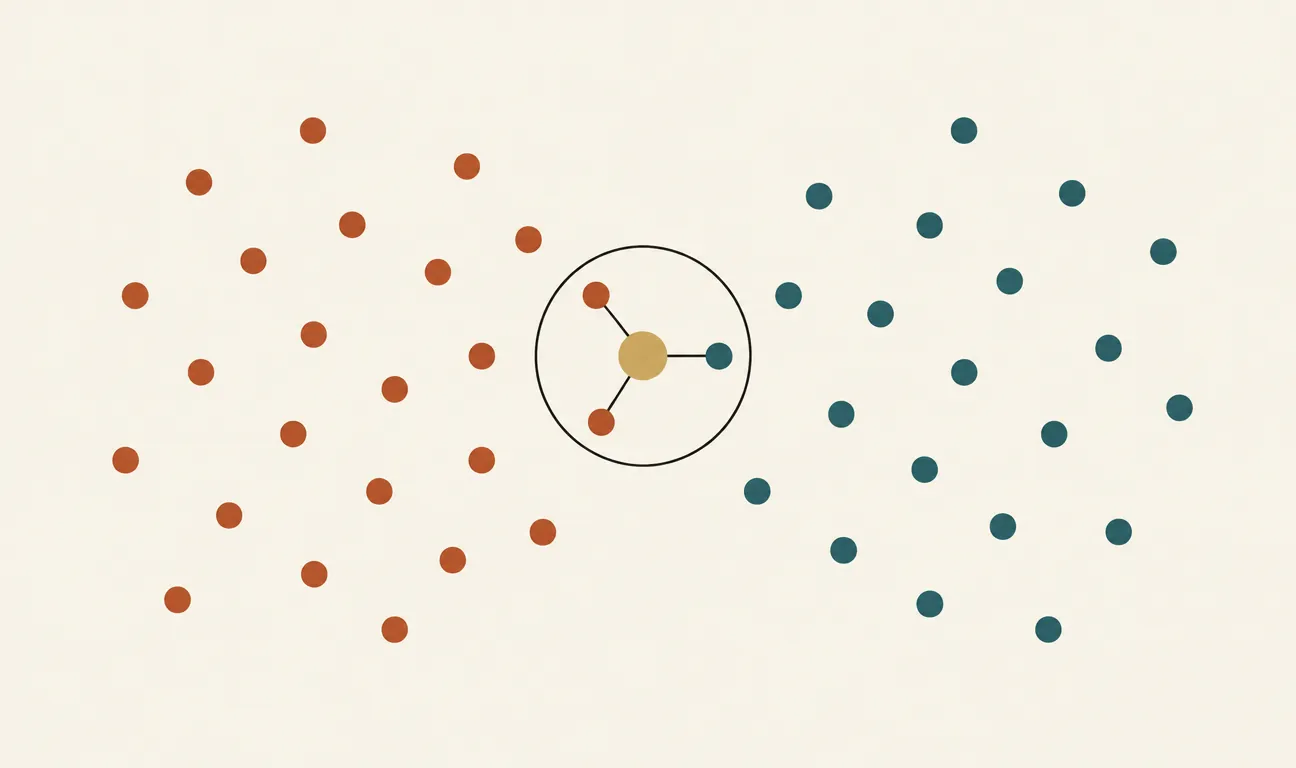
Il punto ocra è da classificare: dei suoi 5 vicini più prossimi, 3 sono terracotta e 2 teal. La maggioranza vince: classe A.
Il primo modello in dieci righe
Usiamo scikit-learn e un dataset classico, quello dei vini: 178 bottiglie descritte da 13 misure chimiche (alcol, flavonoidi, intensità del colore…), da assegnare a una di tre cantine. Il codice è eseguibile così com’è.
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
from sklearn.metrics import accuracy_score

X, y = load_wine(return_X_y=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

knn = KNeighborsClassifier(n_neighbors=5)
knn.fit(X_train, y_train)          # "fit" = memorizza, nient'altro

y_pred = knn.predict(X_test)
print(f"Accuratezza: {accuracy_score(y_test, y_pred):.2%}")
Il risultato si aggira attorno al 70-75% di accuratezza. Non male per dieci righe, ma nemmeno brillante: circa una bottiglia su quattro finisce nella cantina sbagliata. Il colpevole non è k: è la distanza. Ci arriviamo tra un attimo.
Scegliere k: il termostato del modello
Il parametro k regola quanto il modello è «nervoso». Con k=1 ogni punto nuovo copia l’etichetta del singolo vicino più prossimo: basta un dato rumoroso o mal etichettato per sbagliare, come giudicare un quartiere dall’unica persona che incontri per strada. Con k molto grande — al limite, grande quanto l’intero dataset — il modello risponde sempre con la classe più numerosa, ignorando dove si trova il punto. È il compromesso bias-varianza in forma pura: k piccolo, varianza alta; k grande, bias alto.
k-NN non ha una fase di apprendimento, ma ha comunque qualcosa da imparare: quanto lontano guardare prima di decidere.
La scelta si fa empiricamente, con la cross-validation:
from sklearn.model_selection import cross_val_score

for k in [1, 3, 5, 7, 11, 15, 21]:
    scores = cross_val_score(
        KNeighborsClassifier(n_neighbors=k),
        X_train, y_train, cv=5
    )
    print(f"k={k:2d}  accuratezza media: {scores.mean():.2%} "
          f"(± {scores.std():.2%})")
Due accorgimenti pratici: usa k dispari nei problemi a due classi, così eviti i pareggi nel voto; e diffida dei valori di k che vincono per pochi decimi di punto — a parità sostanziale, il k più grande dà un modello più stabile.
Esiste anche una via di mezzo tra il voto secco e la media indiscriminata: il voto pesato. Passando weights="distance" al costruttore, ogni vicino conta in proporzione inversa alla sua distanza — chi è più vicino ha più voce in capitolo, chi sta al bordo del vicinato sussurra appena. È come chiedere consiglio a cinque amici ma fidarsi di più di quello che conosce meglio il problema: spesso guadagni un punto o due di accuratezza senza toccare nient’altro.
La distanza è tutto (e la scala la distorce)
k-NN si fonda su un’ipotesi silenziosa: che la distanza euclidea tra due punti rifletta una vera somiglianza. Ma la distanza euclidea somma le differenze su tutte le feature, e le feature con numeri grandi dominano quelle con numeri piccoli. Nel dataset dei vini, la prolina si misura in centinaia, mentre i flavonoidi stanno tra 0,3 e 5. Risultato: la distanza è di fatto solo la differenza di prolina, e le altre dodici misure quasi non contano. È come confrontare due persone sommando la differenza di altezza in millimetri e quella di età in anni: vincerebbero sempre i millimetri.
La cura è standardizzare, cioè riportare ogni feature a media zero e deviazione standard uno:
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

pipe = make_pipeline(
    StandardScaler(),
    KNeighborsClassifier(n_neighbors=5)
)
pipe.fit(X_train, y_train)
print(f"Accuratezza con scaling: "
      f"{accuracy_score(y_test, pipe.predict(X_test)):.2%}")
Lo stesso identico algoritmo, con le feature standardizzate, sfiora il 95% di accuratezza sul test set. È uno dei salti di qualità più economici di tutto il machine learning: nessun modello nuovo, solo unità di misura rese confrontabili. Nota anche l’uso della Pipeline: lo scaler viene calcolato solo sui dati di training, evitando che informazioni del test set contaminino il modello.
Quando usarlo, quando lasciar perdere
k-NN dà il meglio quando il dataset è piccolo o medio (migliaia di punti, non milioni), le feature sono poche e sensate, e serve una baseline onesta da battere prima di tirare fuori modelli più pesanti. È anche naturalmente multiclasse e si adatta a nuovi dati senza riaddestramento: aggiungi punti alla memoria e hai finito.
I suoi limiti sono altrettanto netti. Predire costa: ogni classificazione richiede il confronto con tutti i punti memorizzati, e su dataset grandi diventa lento (strutture come i k-d tree aiutano, ma solo in bassa dimensione). E in alta dimensione soffre la maledizione della dimensionalità: quando le feature sono centinaia, le distanze tra punti tendono a somigliarsi tutte, e il concetto stesso di «vicino» perde significato — come cercare il ristorante giusto in una città dove ogni locale dista esattamente venti minuti da casa tua.
Perché ti riguarda
k-NN è più di un esercizio da manuale. Primo, è la baseline perfetta: se il tuo modello sofisticato non batte un k-NN standardizzato, hai un problema nei dati, non nell’architettura. Secondo, l’idea di «classificare per somiglianza nello spazio delle feature» è la stessa che oggi fa funzionare la ricerca semantica e i sistemi RAG: un vector database che recupera i documenti più simili alla tua domanda sta facendo, in sostanza, un nearest-neighbor su embedding. Capire k-NN su tredici misure chimiche è il modo più concreto per capire cosa succede, ogni giorno, dentro sistemi con miliardi di vettori.
I commenti sono riservati agli iscritti.
Accedi per commentare