Ogni volta che una mail finisce nello spam, che una banca approva un prestito online o che un modello di visione decide «gatto» invece di «cane», da qualche parte un numero qualsiasi — positivo, negativo, grande, piccolo — è stato schiacciato nell’intervallo tra 0 e 1 e trattato come una probabilità. La funzione che fa questo lavoro si chiama sigmoide, e il modello che la usa per classificare si chiama regressione logistica. Il nome inganna due volte: non è una regressione nel senso comune (classifica, non stima quantità) e non ha niente di logistico. Ma è, ancora oggi, il classificatore più usato al mondo.
Regressione lineare e logistica, dalla retta di best fit alla probabilità, sono derivate per intero nel libro.
Leggi «Apprendimento supervisionato: regressione e classificazione» nel libro →
Perché la retta non basta
Prendiamo un problema binario concreto: prevedere se uno studente passerà un esame in base alle ore di studio. L’esito è 0 (bocciato) o 1 (promosso). Verrebbe voglia di riciclare la regressione lineare: esito = w · ore + b, e interpretare l’output come probabilità di promozione. Ma la retta non conosce limiti: con abbastanza ore di studio prevede una probabilità del 140%, e con poche ore una del −30%. Numeri senza senso, e non solo esteticamente: un modello che produce probabilità impossibili non si può calibrare, confrontare, né usare per decidere.
Serve una funzione che prenda il punteggio lineare — che può valere qualsiasi cosa — e lo comprima dolcemente tra 0 e 1, senza mai uscirne. Quella funzione è la sigmoide: σ(z) = 1 / (1 + e^(−z)).
La sigmoide: uno schiacciasassi gentile
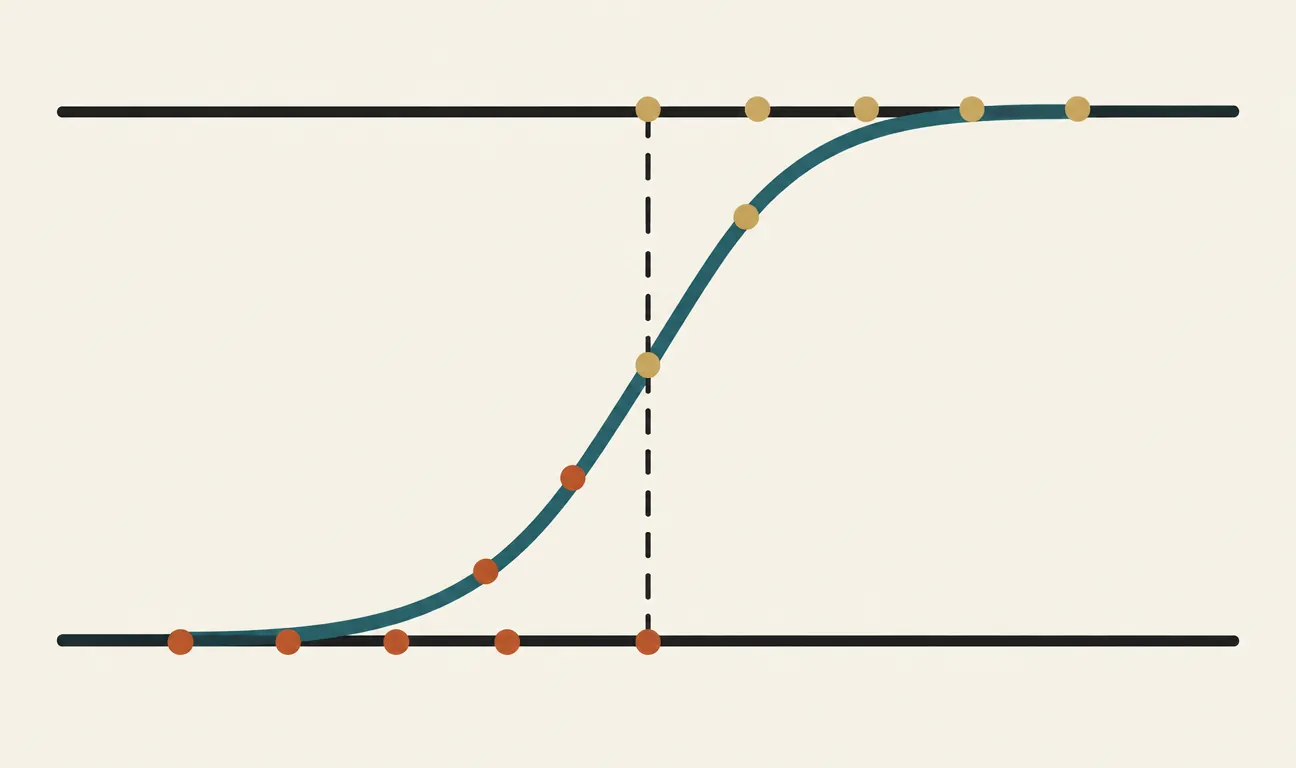
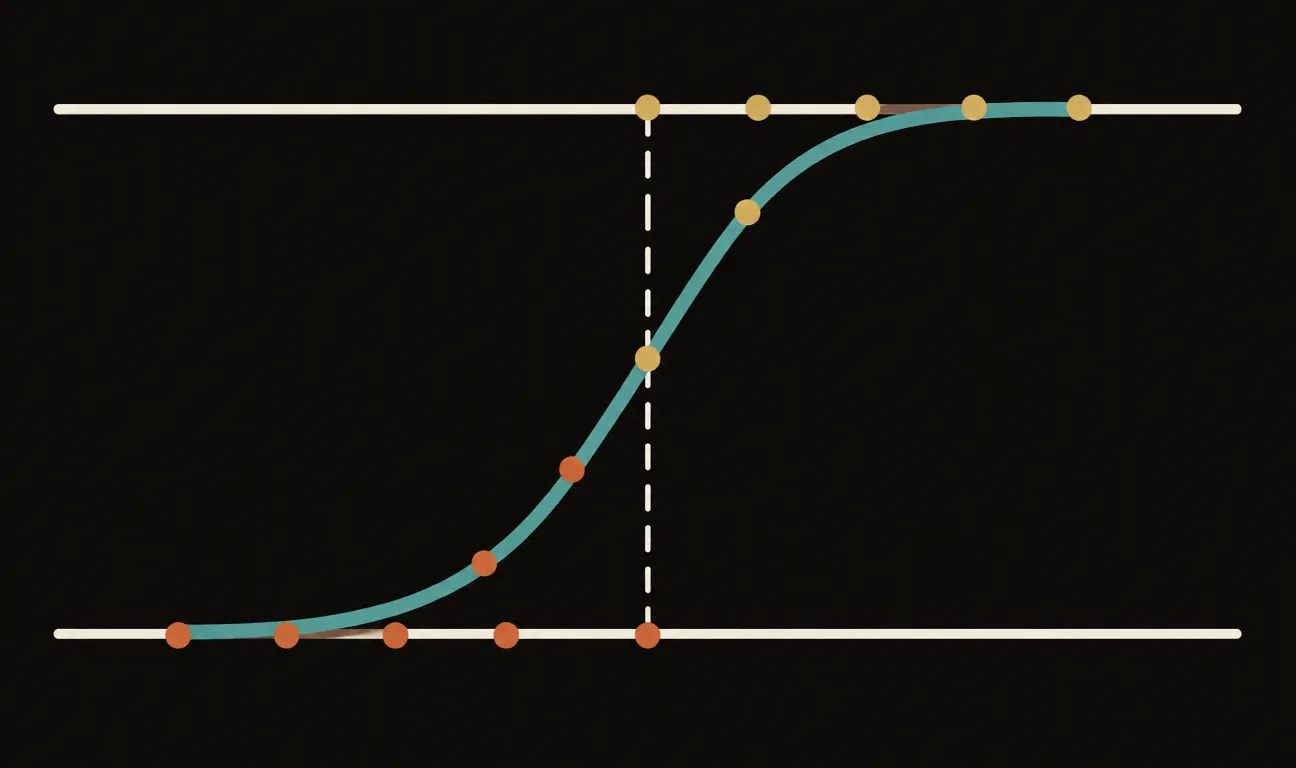
La sigmoide ha la forma di una S allungata. Per punteggi molto negativi vale quasi 0, per punteggi molto positivi vale quasi 1, e a punteggio zero vale esattamente 0,5: massima incertezza. La zona centrale è ripida — lì piccole variazioni del punteggio spostano molto la probabilità — mentre le code sono piatte: quando il modello è già molto sicuro, un po’ di evidenza in più cambia poco. È il comportamento che vorremmo da un collega ragionevole.
La sigmoide comprime qualsiasi punteggio tra 0 e 1. La soglia a 0,5 divide il piano: a sinistra si predice la classe 0, a destra la classe 1.
Il modello completo è quindi in due tempi: prima un punteggio lineare identico a quello della regressione lineare, z = w · ore + b, poi la sigmoide che lo trasforma in probabilità, p = σ(z). Tutta la parte «intelligente» — quali variabili contano e quanto — resta lineare; la sigmoide è solo il traduttore finale verso il linguaggio delle probabilità.
Costruiamola da zero
Generiamo dati sintetici in cui la verità è nota: la probabilità di passare cresce con le ore di studio secondo una sigmoide con w = 1,2 e b = −6 (cioè: al di sotto di 5 ore si è più probabilmente bocciati che promossi).
import numpy as np

rng = np.random.default_rng(7)
ore = rng.uniform(0, 10, size=200)
prob_vera = 1 / (1 + np.exp(-(1.2 * ore - 6)))
passato = (rng.uniform(size=200) < prob_vera).astype(float)

def sigmoide(z):
    return 1 / (1 + np.exp(-z))
Per addestrare il modello non esiste una formula chiusa come per i minimi quadrati: si usa la discesa del gradiente sulla cross-entropy, la funzione di errore naturale per le probabilità. Qui la matematica regala una sorpresa elegante: il gradiente della cross-entropy rispetto ai parametri ha esattamente la stessa forma di quello dell’errore quadratico nella regressione lineare — la media di (previsione − verità) · x. Il ciclo di addestramento è quindi quasi identico:
w, b, lr = 0.0, 0.0, 0.1

for epoca in range(3000):
    p = sigmoide(w * ore + b)
    errore = p - passato
    w -= lr * np.mean(errore * ore)
    b -= lr * np.mean(errore)
    if epoca % 600 == 0:
        ce = -np.mean(passato * np.log(p + 1e-12)
                      + (1 - passato) * np.log(1 - p + 1e-12))
        print(f"epoca {epoca:4d}  cross-entropy={ce:.3f}  w={w:.2f}  b={b:.2f}")

print(f"\nfinale: w={w:.2f}, b={b:.2f}  (verità: 1.2, -6)")
Eseguendolo, i parametri convergono vicino ai valori veri. Trecento righe di libreria compresse in dieci: è lo stesso algoritmo che scikit-learn nasconde dietro LogisticRegression().fit(), con l’unica differenza che la versione di libreria usa ottimizzatori più raffinati e converge in meno passi.
La soglia: dove la probabilità diventa decisione
Il modello produce probabilità, ma il mondo chiede decisioni: la mail va nello spam oppure no. Il passaggio avviene con una soglia, tipicamente 0,5:
previsioni = (sigmoide(w * ore + b) >= 0.5).astype(float)
print(f"accuratezza: {(previsioni == passato).mean():.2%}")
print(f"ore per il 50% di probabilità: {-b / w:.1f}")
Il punto −b/w è dove la sigmoide attraversa 0,5: nel nostro caso circa 5 ore di studio, la frontiera di decisione. Ma la soglia a 0,5 è una convenzione, non una legge. Un test medico di screening la abbassa (meglio un falso allarme che un tumore mancato), un filtro antispam la alza (meglio uno spam in inbox che una mail importante persa). È come la temperatura del termostato: il meccanismo è fisso, ma dove scatta lo decide chi conosce il costo degli errori. Separare la stima della probabilità dalla scelta della soglia è esattamente ciò che rende la regressione logistica adatta alle decisioni reali.
La regressione logistica non decide: stima quanto è probabile. La decisione — dove mettere la soglia — resta a chi conosce il costo di sbagliare.
Leggere i coefficienti: il linguaggio degli odds
Come la sorella lineare, la regressione logistica si spiega da sola — ma in una valuta diversa. Il punteggio z è il logaritmo degli odds, il rapporto tra probabilità di successo e di insuccesso. Ne segue che ogni unità in più di una variabile moltiplica gli odds per e elevato al suo coefficiente: nel nostro esempio, un’ora di studio in più moltiplica gli odds di promozione per circa e^1,2 ≈ 3,3. È il formato in cui epidemiologi e analisti del credito ragionano da decenni, ed è il motivo per cui in medicina e finanza — dove ogni previsione va difesa davanti a un comitato — la regressione logistica resta spesso preferita a modelli più potenti ma opachi.
Un’avvertenza pratica prima di usarla sui dati veri: se le classi sono molto sbilanciate — un caso di frode ogni mille transazioni legittime — l’accuratezza diventa una metrica bugiarda (un modello che dice sempre «legittima» segna il 99,9%) e la soglia a 0,5 quasi mai è quella giusta. In questi casi si valuta con precision e recall, e si sposta la soglia guardando il costo reale dei due tipi di errore, non la simmetria della sigmoide.
Perché vi riguarda
La sigmoide che avete appena programmato non è un esercizio scolastico: è l’ultimo strato di quasi ogni rete neurale binaria, e la sua generalizzazione a più classi — la softmax — è quella che trasforma i punteggi di un LLM nella probabilità della prossima parola. Ogni volta che un modello linguistico «sceglie» un token, sta facendo l’operazione di questo articolo su un vocabolario di centinaia di migliaia di voci. Capire la regressione logistica significa capire il momento esatto in cui, dentro qualsiasi sistema di AI, i numeri diventano probabilità e le probabilità diventano decisioni — cioè il punto dove gli errori nascono, e dove si va a cercarli quando qualcosa non torna.
I commenti sono riservati agli iscritti.
Accedi per commentare