Nel 1801 l’asteroide Cerere sparì dietro il Sole dopo appena quaranta giorni di osservazioni, e gli astronomi europei non sapevano più dove puntare i telescopi. Carl Friedrich Gauss lo ritrovò calcolando l’orbita con il metodo dei minimi quadrati: prendere le osservazioni imperfette, farci passare in mezzo la curva che minimizza gli errori al quadrato, fidarsi del risultato. Quel metodo, formalizzato pubblicamente da Legendre nel 1805, è la regressione lineare. Ha più di duecento anni, e ancora oggi è il primo modello che un data scientist esperto prova su un problema nuovo — spesso anche l’ultimo, perché funziona.
Regressione lineare e logistica, dalla retta di best fit alla probabilità, sono derivate per intero nel libro.
Leggi «Apprendimento supervisionato: regressione e classificazione» nel libro →
Il problema: una retta in mezzo ai punti
Partiamo da qualcosa di concreto: stimare il prezzo di un appartamento dai metri quadrati. Abbiamo un elenco di vendite passate — superficie e prezzo — e vogliamo una regola che, data la superficie di un appartamento nuovo, ne preveda il prezzo. La regressione lineare propone la regola più semplice possibile: prezzo = w · metri + b. Due numeri da trovare: la pendenza w (quanto vale un metro quadrato in più) e l’intercetta b (il punto di partenza).
Generiamo dati sintetici così sappiamo qual è la verità da ritrovare:
import numpy as np

rng = np.random.default_rng(0)
metri = rng.uniform(40, 140, size=60)
# prezzo in migliaia di euro: 1.9 k€ al metro + base, più rumore
prezzo = 1.9 * metri + 35 + rng.normal(0, 18, size=60)
Il rumore è il punto importante: nessun appartamento reale sta esattamente sulla retta. Ci sono il piano, l’esposizione, la fretta del venditore. La retta non pretende di spiegare tutto: pretende di spiegare la parte sistematica, lasciando il resto al caso.
I residui: cosa significa «la retta migliore»
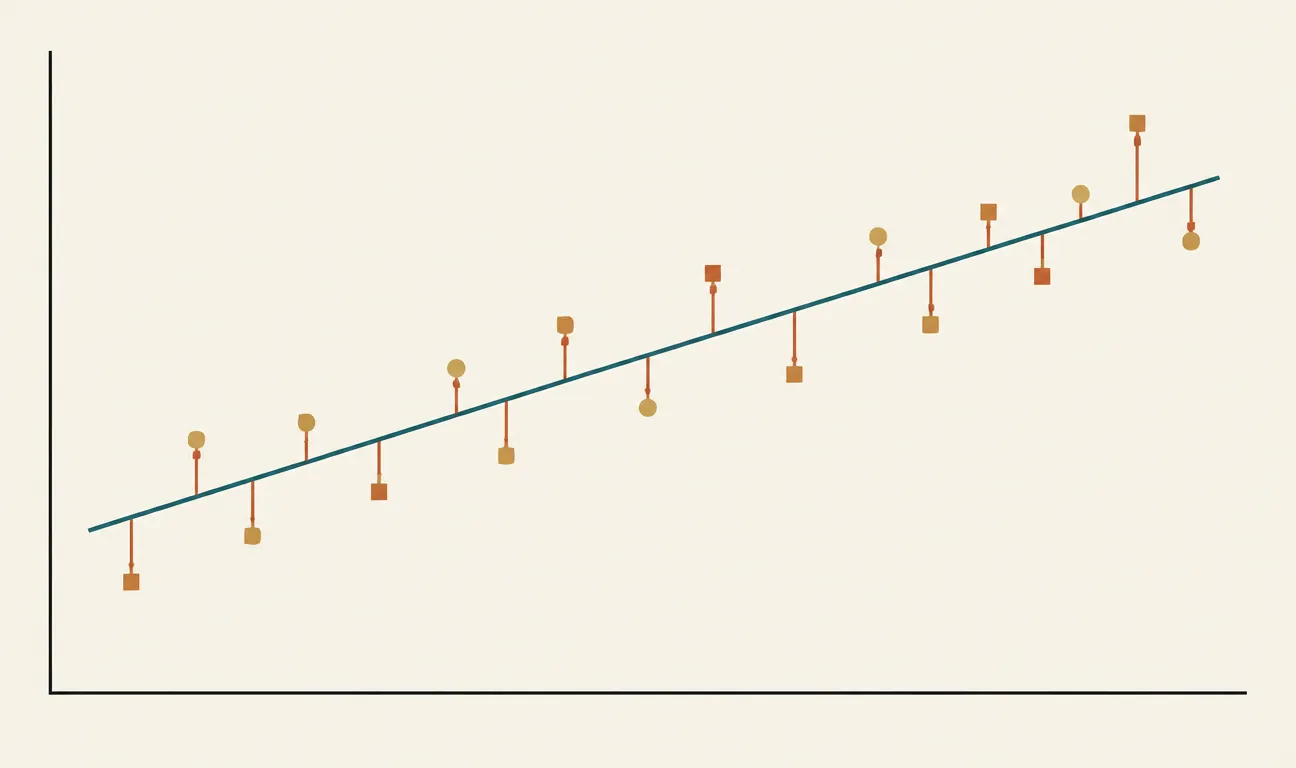
Tra tutte le rette possibili, quale scegliere? Per ogni punto misuriamo il residuo: la distanza verticale tra il prezzo vero e quello che la retta prevede. La retta migliore è quella che rende i residui, elevati al quadrato e sommati, più piccoli possibile. Il quadrato serve a due cose: elimina i segni (un errore di −10 pesa quanto uno di +10) e punisce gli errori grandi più che proporzionalmente.
La retta di regressione passa in mezzo ai punti minimizzando i residui: i segmenti verticali tratteggiati tra ogni osservazione e la retta.
Un’immagine utile: pensate a ogni residuo come a un elastico che collega il punto alla retta. Elastici corti tirano poco, elastici lunghi tirano molto — e per via del quadrato tirano più che proporzionalmente. La retta dei minimi quadrati è la posizione di equilibrio: quella in cui gli elastici, tutti insieme, smettono di spostarla.
La soluzione in forma chiusa
Qui la regressione lineare si distingue da quasi tutto il machine learning moderno: non serve un ciclo di addestramento. Il minimo dei quadrati si calcola con una formula, in un colpo solo. NumPy la implementa in lstsq:
X = np.column_stack([np.ones_like(metri), metri])  # colonna di 1 per l'intercetta
theta, residuo_tot, rango, _ = np.linalg.lstsq(X, prezzo, rcond=None)
b, w = theta
print(f"prezzo ≈ {w:.2f} · metri + {b:.1f}")
# prezzo ≈ 1.89 · metri + 37.6  (verità: 1.9 e 35)
La colonna di uni è il piccolo trucco standard: aggiungendo ai dati una «variabile» che vale sempre 1, l’intercetta diventa un coefficiente come gli altri e la formula si scrive una volta sola. I valori stimati non coincidono con la verità (1,89 contro 1,9) perché il rumore esiste: con più dati la stima si stringe attorno al valore vero.
Vale la pena guardare anche i residui della soluzione trovata:
previsti = w * metri + b
residui = prezzo - previsti
print(f"media residui: {residui.mean():.4f}")   # ~0 per costruzione
print(f"deviazione:    {residui.std():.1f}")     # ~18, il rumore che avevamo messo
La media dei residui è zero per costruzione. La loro deviazione standard invece è informativa: ci dice quanto sbaglia tipicamente il modello, ed è il numero da comunicare a chi userà le previsioni.
Più variabili, stessa idea
Il passaggio da una a molte variabili non cambia nulla di concettuale: invece di una retta nel piano cerchiamo un piano (o un iperpiano) nello spazio delle variabili. Con scikit-learn:
from sklearn.linear_model import LinearRegression

piano = rng.integers(0, 8, size=60).astype(float)
distanza_centro = rng.uniform(0.5, 12, size=60)   # km
prezzo2 = 1.9 * metri + 6 * piano - 4.5 * distanza_centro + 40 \
          + rng.normal(0, 15, size=60)

X_multi = np.column_stack([metri, piano, distanza_centro])
modello = LinearRegression().fit(X_multi, prezzo2)
for nome, coef in zip(["metri", "piano", "distanza"], modello.coef_):
    print(f"{nome:10s} {coef:+.2f}")
print(f"R²: {modello.score(X_multi, prezzo2):.3f}")
L’output è leggibile riga per riga: un metro quadrato in più vale circa 1,9 mila euro, un piano in più circa 6, un chilometro di distanza dal centro ne toglie 4,5 — a parità delle altre variabili. Quest’ultima clausola è la vera potenza del modello: i coefficienti separano i contributi, cosa che guardando le variabili una alla volta non si può fare.
La regressione lineare non è il modello che usi quando non sai fare di meglio. È il modello che ti dice se fare di meglio serve davvero.
Dove la retta si spezza
L’onestà impone l’elenco dei limiti. Primo: la relazione deve essere ragionevolmente lineare — se il prezzo al metro cresce nei quartieri di lusso, la retta lo ignora (si rimedia trasformando le variabili, ad esempio con i logaritmi). Secondo: i coefficienti si leggono bene solo se le variabili non sono troppo correlate tra loro; se metri quadrati e numero di stanze si muovono sempre insieme, il modello non sa a chi dei due attribuire il merito. Terzo: gli errori grandi pesano al quadrato, quindi un singolo dato anomalo — il prezzo scritto male, l’attico venduto tra parenti — può trascinare la retta da solo. Guardare i residui uno per uno, sempre, è la forma minima di igiene statistica.
C’è infine il limite più sottovalutato: l’estrapolazione. Il modello ha visto appartamenti tra 40 e 140 metri quadrati; chiedergli il prezzo di una villa da 400 è come chiedere indicazioni stradali a chi non è mai uscito dal proprio quartiere. La formula risponde comunque — le formule rispondono sempre — ma fuori dall’intervallo dei dati la risposta non poggia su nulla. Prima di fidarsi di una previsione, la domanda da farsi è se il punto richiesto assomiglia a qualcosa che il modello ha davvero visto.
Perché non muore mai
In un campo che cambia architettura di riferimento ogni tre anni, un modello del 1805 continua a essere ovunque: nelle stime dei ministeri, nei test A/B, negli studi clinici, dentro l’ultimo strato di molte reti neurali (che è, letteralmente, una regressione lineare sulle feature apprese dagli strati precedenti). I motivi sono tre: si calcola in modo esatto e istantaneo, si interpreta coefficiente per coefficiente, e fornisce la linea di base contro cui misurare qualsiasi modello più complesso. Se una rete neurale batte la regressione lineare del 2% al costo di mille volte il calcolo e zero interpretabilità, quel 2% va discusso, non dato per scontato.
Per chi lavora o vuole lavorare con i dati, la lezione pratica è una: prima di aprire PyTorch, tracciate la retta. Nel peggiore dei casi avrete un punto di riferimento onesto. Nel migliore, avrete finito.
I commenti sono riservati agli iscritti.
Accedi per commentare