
Nel 1906, a una fiera di paese nell’Inghilterra sud-occidentale, quasi ottocento visitatori pagarono sei pence per provare a indovinare il peso di un bue esposto. Lo statistico Francis Galton raccolse i biglietti e fece i conti: la mediana delle stime si avvicinò al peso reale dell’animale più della grande maggioranza dei singoli partecipanti, allevatori esperti compresi. Nessuno era particolarmente bravo, ma gli errori individuali — chi esagerava, chi sottostimava — tendevano a cancellarsi a vicenda. La random forest è questo principio tradotto in algoritmo: tante stime imperfette e indipendenti che, aggregate, battono il singolo esperto.
L’albero decisionale, perché da solo è ballerino, e come Random Forest e boosting lo correggono: nel libro.
Il problema di partenza: alberi lunatici
L’albero di decisione ha un pregio raro — si spiega da solo — e un difetto strutturale: l’instabilità. La sua costruzione è greedy: la domanda scelta alla radice condiziona tutte le successive. Basta togliere o aggiungere una manciata di esempi al training set perché lo split iniziale cambi, e con lui l’intera struttura a cascata, come una partita a scacchi che diverge completamente dopo una prima mossa diversa.
In gergo statistico, l’albero profondo è un modello ad alta varianza: molto sensibile al campione specifico su cui è stato addestrato. Ma proprio qui c’è l’intuizione: la varianza si può abbattere facendo la media. Se addestri molti alberi su versioni leggermente diverse dei dati e poi medi le loro predizioni, gli errori dovuti al caso — che vanno un po’ di qua e un po’ di là — si compensano, mentre il segnale vero, condiviso da tutti, resta.
Bagging: la stessa storia raccontata da testimoni diversi
Il primo ingrediente si chiama bagging, contrazione di bootstrap aggregating, proposto da Leo Breiman negli anni Novanta. L’idea: da un dataset di N esempi si estraggono, con reinserimento, N esempi a caso. Il campione risultante — un campione bootstrap — contiene alcuni esempi ripetuti e ne omette altri (in media ne resta fuori circa un terzo). Ogni albero della foresta viene addestrato su un campione bootstrap diverso: vede la stessa realtà, ma da un punto di osservazione leggermente distorto, come testimoni diversi dello stesso incidente.
Gli esempi lasciati fuori da ciascun campione, detti out-of-bag, sono un bonus prezioso: ogni albero può essere valutato sugli esempi che non ha mai visto, ottenendo una stima dell’errore di generalizzazione senza sacrificare dati per un set di validazione separato.
Il secondo ingrediente: sabotare le domande
Il bagging da solo non basta. Se nel dataset c’è una feature dominante — una che separa le classi molto meglio delle altre — quasi tutti gli alberi la sceglieranno alla radice, e le foreste finiranno per essere composte da alberi molto simili tra loro. E la media di opinioni tutte uguali non corregge nulla: è la folla di Galton dove tutti hanno copiato la stima dal vicino.
La random forest aggiunge quindi una seconda dose di casualità: a ogni nodo, l’albero non può scegliere la domanda migliore tra tutte le feature, ma solo tra un sottoinsieme estratto a caso (tipicamente la radice quadrata del numero totale, per la classificazione). È una limitazione volontaria, quasi un sabotaggio: costringe alberi diversi a esplorare strade diverse, a valorizzare feature secondarie che l’albero singolo ignorerebbe. Il singolo albero ne esce peggiore; la foresta, più varia e quindi più forte.
La foresta funziona perché i suoi alberi sbagliano in modi diversi. La casualità non è un difetto da tollerare: è il meccanismo che rende gli errori scorrelati, e quindi cancellabili.
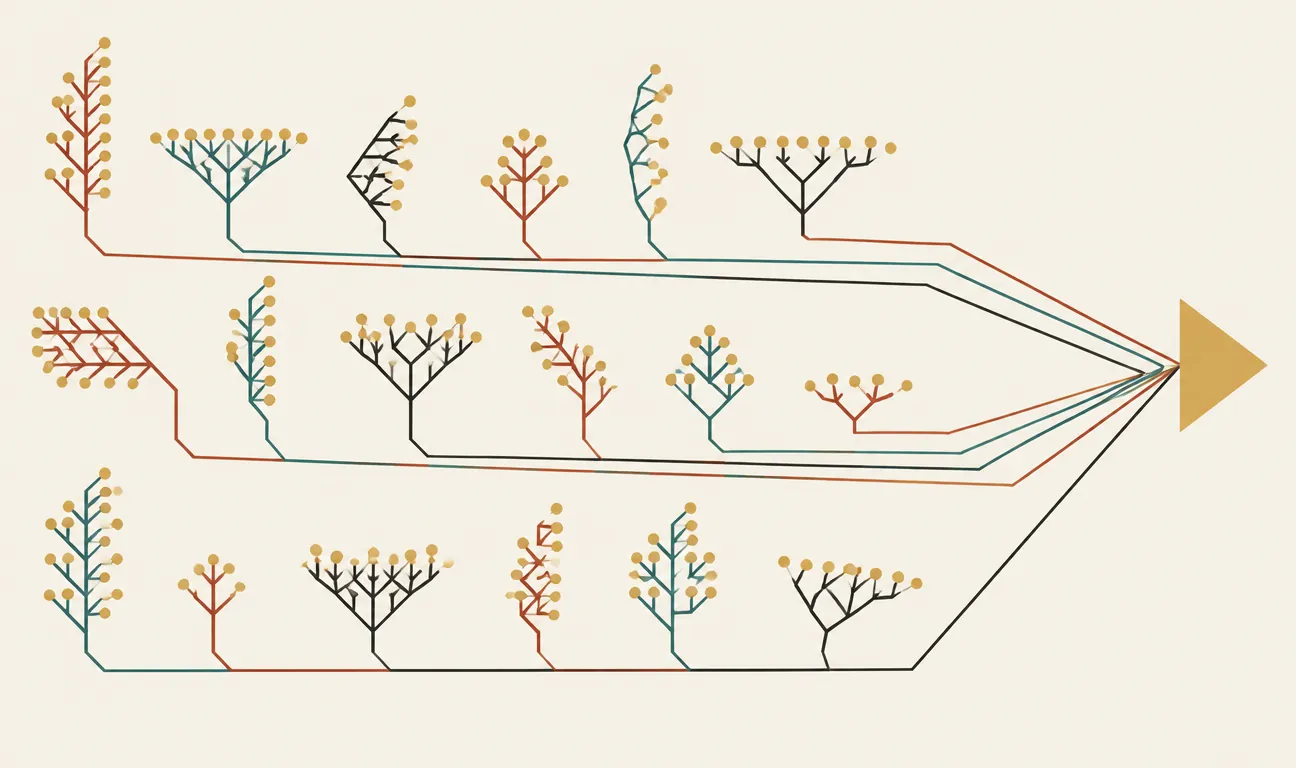
Il meccanismo del voto: quattro alberi addestrati su campioni e feature diversi classificano lo stesso input. Uno sbaglia, ma la maggioranza corregge. Con centinaia di alberi l’effetto si amplifica.
Il voto finale e i suoi effetti collaterali
Al momento della predizione, ogni albero della foresta classifica il nuovo esempio e la foresta risponde con la classe più votata (o con la media, nella regressione). Da questo schema semplice discendono proprietà pratiche molto apprezzate.
- Robustezza all’overfitting: aggiungere alberi non fa mai peggiorare la generalizzazione, al contrario di quanto accade aumentando la profondità di un albero singolo. Il costo di una foresta più grande è solo computazionale.
- Pochi iperparametri delicati: numero di alberi, feature per split, profondità massima. I default delle librerie funzionano sorprendentemente bene, il che rende la random forest un’eccellente baseline: il modello da battere prima di giustificare qualcosa di più complesso.
- Importanza delle feature: aggregando su centinaia di alberi quanto ogni feature contribuisce a purificare gli split, si ottiene una classifica di quali variabili contano. Va letta con prudenza — tende a favorire le feature con molti valori distinti — ma resta uno strumento diagnostico utile.
- Parallelismo naturale: gli alberi sono indipendenti tra loro, quindi si addestrano in parallelo su tutti i core disponibili. Nessuna GPU richiesta.
Cosa si perde, e dove la folla smette di essere saggia
Il prezzo più visibile è l’interpretabilità: un albero si legge come un diagramma di flusso, cinquecento alberi no. La foresta restituisce importanze aggregate, non il percorso di una singola decisione — per quello servono strumenti post-hoc come i valori SHAP. Anche la predizione è più lenta: ogni classificazione deve attraversare tutti gli alberi, un dettaglio che pesa quando i vincoli di latenza sono stretti.
Ci sono poi limiti strutturali. Come tutti i modelli ad alberi, la random forest non sa estrapolare: nella regressione non può predire valori fuori dall’intervallo visto in addestramento, perché ogni foglia restituisce una media di esempi noti. E l’ipotesi di Galton — errori indipendenti — vale solo in parte: se il dataset contiene un bias sistematico, tutti gli alberi lo ereditano e il voto lo conferma invece di correggerlo. La folla è saggia solo se i suoi errori sono davvero scorrelati; quando tutti sbagliano nella stessa direzione, la media sbaglia con convinzione.
Infine, sui dati tabellari la concorrenza interna: il gradient boosting (XGBoost, LightGBM), che costruisce gli alberi in sequenza correttiva anziché in parallelo, spesso strappa qualche punto di accuratezza in più al costo di un tuning più delicato. Ne parliamo nel prossimo articolo di questa serie.
Perché ti riguarda
La random forest è probabilmente il miglior rapporto qualità/sforzo del machine learning su dati tabellari: pochi iperparametri, ottime performance di default, nessun hardware speciale. Se in azienda hai un problema di classificazione o regressione su dati strutturati — previsione di abbandono clienti, scoring, manutenzione predittiva — è quasi sempre il primo modello serio da provare, e il metro con cui giudicare tutto ciò che viene dopo. Ma il suo valore è anche concettuale: l’idea che tanti modelli deboli e diversi battano un modello forte e solitario è uno dei principi più fecondi del campo, e la ritroverai ovunque, dal boosting fino agli ensemble di reti neurali.
I commenti sono riservati agli iscritti.
Accedi per commentare