
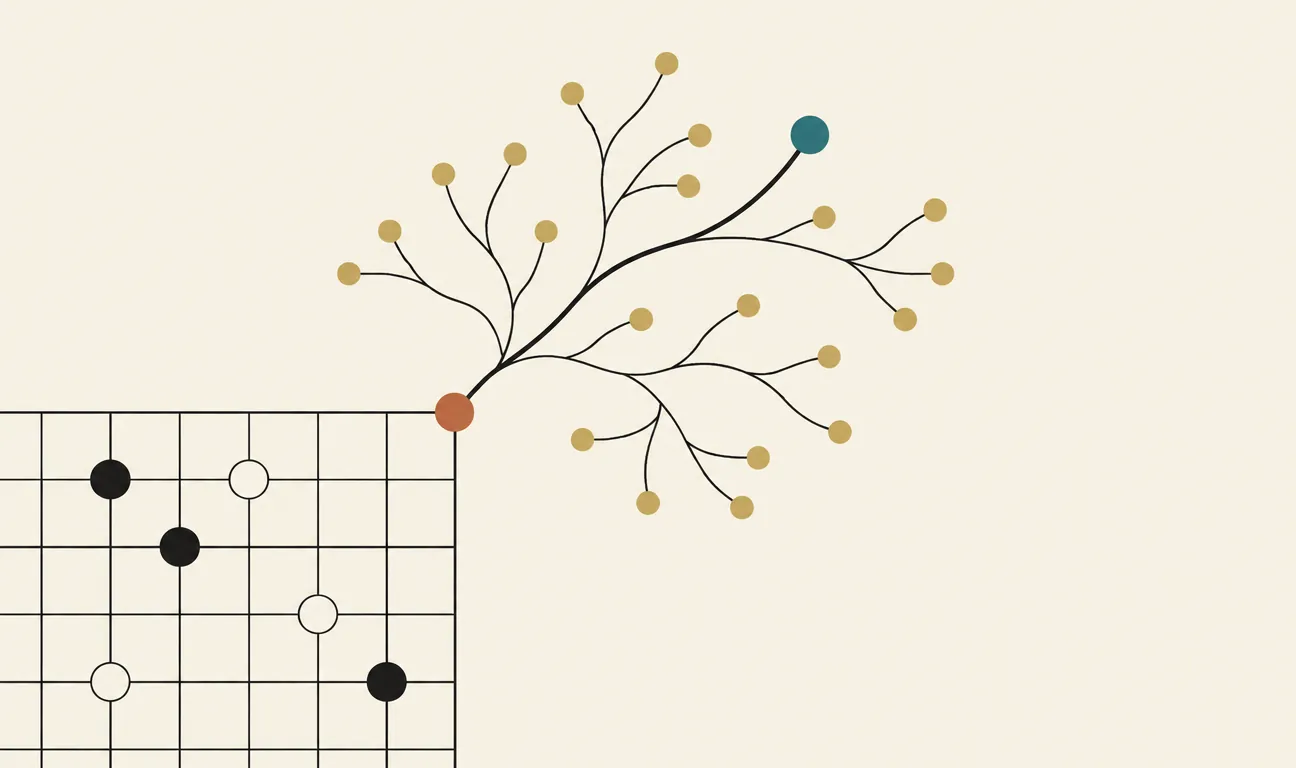
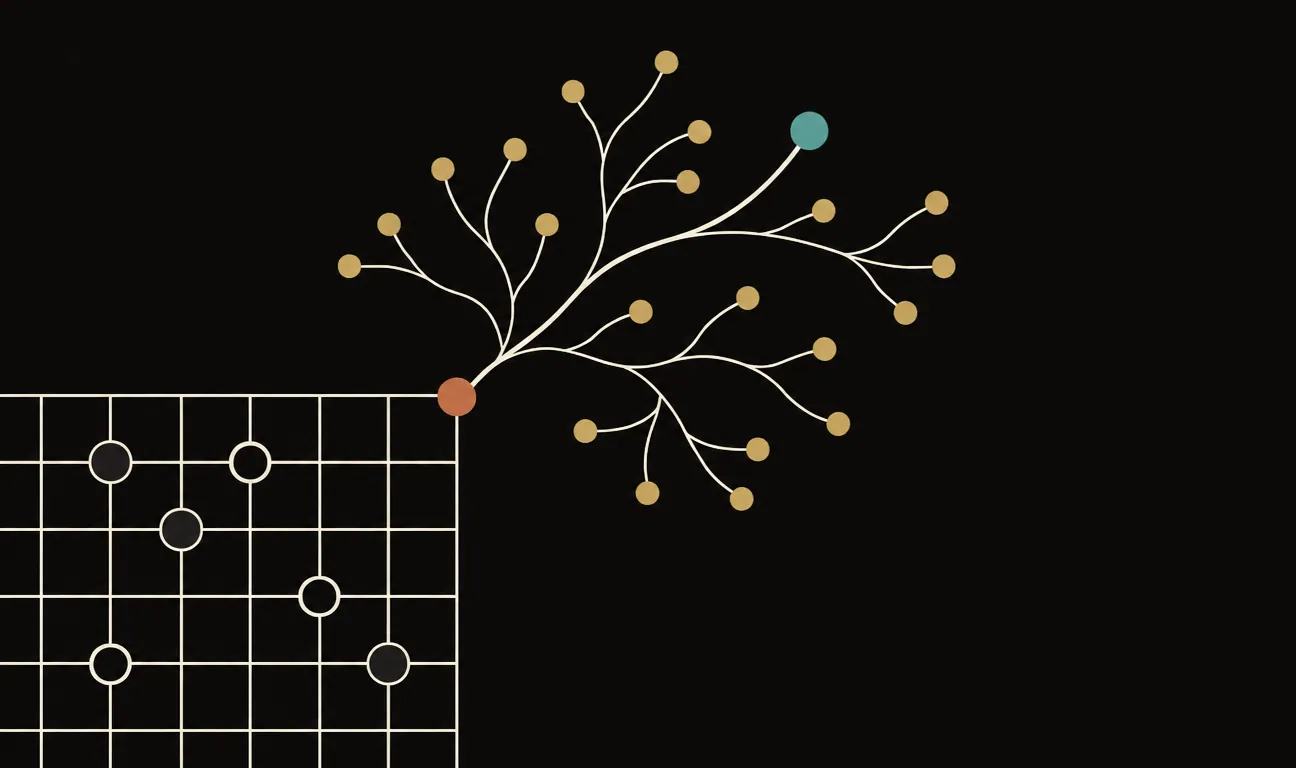
Nell’ottobre del 2015, in una stanza degli uffici londinesi di DeepMind, il campione europeo di go Fan Hui perde cinque partite su cinque contro un programma. Non era mai successo: nessuna macchina aveva battuto un giocatore professionista sul tabellone intero, senza handicap. La notizia resta riservata per mesi, fino a quando esce, il 28 gennaio 2016, il paper che spiega come è stato fatto. Si intitola Mastering the game of Go with deep neural networks and tree search, è firmato da David Silver, Demis Hassabis e colleghi, e appare su Nature.
La ricerca ad albero Monte Carlo, il passaggio da AlphaGo ad AlphaZero e il salto verso gli LLM: nel libro.
Leggi «Pensare prima di agire: la ricerca ad albero Monte Carlo» nel libro →
Per capire perché quel 5 a 0 conta bisogna capire perché il go aveva resistito così a lungo. Gli scacchi erano caduti nel 1997; il go è rimasto in piedi altri diciannove anni. Non per mancanza di tentativi, ma perché il metodo che aveva funzionato sugli scacchi qui non basta.
Perché il go resisteva
Un programma di scacchi, in sostanza, prova mosse. Esplora l’albero delle possibilità — se io gioco questo, l’avversario gioca quello, poi io… — e valuta le posizioni che ne risultano. Il problema è che questo albero cresce a valanga. A ogni turno del go si può giocare in circa 250 punti diversi, e una partita dura intorno alle 150 mosse. Il numero di posizioni legali del go supera di gran lunga il numero di atomi nell’universo osservabile: esplorarle tutte è fuori discussione, ora e per sempre.
Servono due tagli. Bisogna ridurre la larghezza dell’albero — non considerare tutte le 250 mosse, ma solo le poche sensate — e ridurne la profondità — capire chi sta vincendo in una certa posizione senza dover simulare la partita fino all’ultima pietra. È esattamente ciò che fa un forte giocatore umano: guarda il tabellone e, per intuito, scarta quasi tutto e «sente» chi è in vantaggio. Il paper insegna a una macchina a fare le stesse due cose.
Due reti e un albero
AlphaGo tiene insieme tre componenti. Una rete policy si occupa della larghezza: guardando la posizione, suggerisce quali sono le mosse promettenti, restringendo il ventaglio da centinaia a una manciata. Una rete value si occupa della profondità: data una posizione, stima la probabilità di vittoria senza bisogno di giocarla fino alla fine. Le due reti guidano una ricerca ad albero Monte Carlo (MCTS), il motore che esplora le linee di gioco: la policy indirizza dove guardare, la value dice quando fermarsi.
La ricerca non decide con un solo sguardo: lavora per accumulo. Parte dalla posizione attuale e simula molte volte come potrebbe proseguire la partita, ogni volta scendendo lungo i rami che la policy segnala come più promettenti. Al termine di ciascuna simulazione stima quanto vale la posizione raggiunta — in parte con la rete value, in parte con brevi partite di prova giocate fino in fondo — e riporta il risultato indietro lungo il percorso, aggiornando delle statistiche. Dopo migliaia di simulazioni, la mossa che il programma gioca davvero è quella esplorata più spesso: non la più brillante in astratto, ma quella che ha retto meglio alla prova ripetuta.
Le tre componenti non sono in fila ma in circolo: il self-play genera partite, le partite allenano policy e value, le due reti rendono più forte la ricerca ad albero, che a sua volta produce un giocatore migliore per il self-play successivo.
Imparare dagli umani, poi da sé
L’addestramento procede per stadi. Prima l’apprendimento supervisionato: la rete policy studia una raccolta di circa 30 milioni di posizioni tratte da partite di forti giocatori umani, imparando a prevedere quale mossa avrebbe scelto una persona. Arriva a indovinarla il 57% delle volte — non un dettaglio, se si pensa che le alternative sono centinaia. Questa è l’intuizione di partenza, copiata dagli esseri umani.
Poi il salto: l’apprendimento per rinforzo attraverso il self-play. La rete comincia a giocare contro versioni di se stessa, milioni di partite, aggiustando la propria strategia in base a chi vince. Non impara più a imitare gli umani, ma a battere avversari sempre più forti — cioè copie sempre migliori di sé. Dalle posizioni generate in questo modo si addestra infine la rete value, quella che stima chi è in vantaggio. La macchina, in pratica, diventa il proprio insegnante.
Perché non fermarsi all’imitazione? Perché copiare gli umani fissa un tetto: al massimo si diventa bravi quanto i giocatori studiati, e se ne ereditano anche gli errori sistematici. Il self-play toglie quel tetto. Giocando contro se stesso, il sistema esplora anche mosse che nessun maestro avrebbe provato e conserva quelle che vincono. È anche il motivo per cui alcune giocate di AlphaGo hanno colpito i professionisti per la loro originalità: non venivano da un manuale, ma da milioni di partite in cui l’unico criterio era il risultato.
Il risultato: cinque a zero
Contro gli altri programmi di go dell’epoca, AlphaGo vince 494 partite su 495: non una vittoria fortunata, ma un dominio ripetuto. Contro Fan Hui, campione europeo e professionista, la versione più forte — distribuita su molte macchine — vince 5 a 0: il risultato che il paper porta come prova. È bene essere precisi, perché la memoria collettiva tende a sovrapporre due eventi. La partita famosa, quella contro il leggendario Lee Sedol vinta 4 a 1 e seguita in diretta da milioni di persone, avviene nel marzo 2016 — poche settimane dopo la pubblicazione. Il paper documenta Fan Hui; Lee Sedol è ciò che è arrivato subito dopo, la conferma su un avversario di livello ancora più alto.
Perché ti riguarda
La forza di AlphaGo non sta in una delle sue parti, ma nel modo in cui si tengono. Le reti neurali, da sole, «sentono» la posizione ma non calcolano le conseguenze. La ricerca ad albero, da sola, calcola ma si perde nell’esplosione delle possibilità. Messe insieme — intuizione che restringe il campo, calcolo che verifica — coprono ciascuna il punto debole dell’altra. È lo schema che tornerà, più affilato, nei sistemi successivi capaci di imparare un gioco da zero senza esempi umani.
Vale la pena tenere la misura giusta. AlphaGo non «capisce» il go come lo capisce un maestro, e non è un passo verso una macchina che pensa in generale: è un sistema costruito per un problema con regole chiare e obiettivo netto. Ma proprio per questo è istruttivo. Mostra che, quando un compito ha confini definiti, la combinazione di apprendimento e ricerca può superare la migliore intuizione umana. Riconoscere quali problemi hanno quella forma — e quali no — è una delle competenze più utili per chi lavora con l’AI oggi.
Il paper originale
David Silver, Aja Huang, Chris J. Maddison, Arthur Guez, Laurent Sifre et al., Mastering the game of Go with deep neural networks and tree search, Nature 529, 484–489 (28 gennaio 2016). Pagina ufficiale: nature.com/articles/nature16961.
I commenti sono riservati agli iscritti.
Accedi per commentare