
Metti una foto di strada davanti a un sistema di riconoscimento oggetti del 2014 e, dietro le quinte, comincia una processione. Il programma non guarda l’immagine: la interroga a pezzi. Propone una regione, chiede «c’è qualcosa qui, e cosa?», passa alla successiva e ripete l’operazione migliaia di volte, poi mette insieme i pezzi in una risposta. Funziona, ma è lento. E la lentezza non è un dettaglio estetico: un’auto che deve accorgersi di un pedone non può permettersi di ragionare per secondi.
Dal riquadro alla maschera, due stadi contro uno, le ancore e le metriche IoU e mAP: nel libro.
Nel 2015 quattro ricercatori propongono di ribaltare l’impianto. Il titolo del loro paper è già una dichiarazione di intenti: You Only Look Once, si guarda una volta sola. Joseph Redmon, Santosh Divvala, Ross Girshick e Ali Farhadi presentano YOLO alla conferenza CVPR del 2016. L’idea sta in una frase: trattare il rilevamento non come una caccia fatta di tentativi ripetuti, ma come un unico calcolo che, in un solo passaggio sull’immagine, dice cosa c’è e dove si trova.
Il problema dei metodi a due tempi
Per capire la portata del cambiamento serve vedere cosa c’era prima. I sistemi migliori di allora — la famiglia R-CNN, per esempio — lavoravano in due fasi separate. Prima un modulo proponeva centinaia o migliaia di «regioni candidate», riquadri dell’immagine che potrebbero contenere un oggetto. Poi un classificatore esaminava ogni singola regione, una alla volta, per decidere cosa ci fosse dentro. Due lavori distinti, incollati in una catena di montaggio.
È come un vigilante che rivede le registrazioni della notte: prima scorre tutto e segna con un post-it ogni fotogramma sospetto, poi torna indietro e riguarda con calma ciascun post-it, uno per uno. Accurato, ma la seconda passata costa: più sono i sospetti segnati, più lungo è il lavoro. E siccome ogni regione viene analizzata isolata dalle altre, il sistema perde il contesto: guarda il ritaglio, non la scena intera.
Una griglia e un solo sguardo
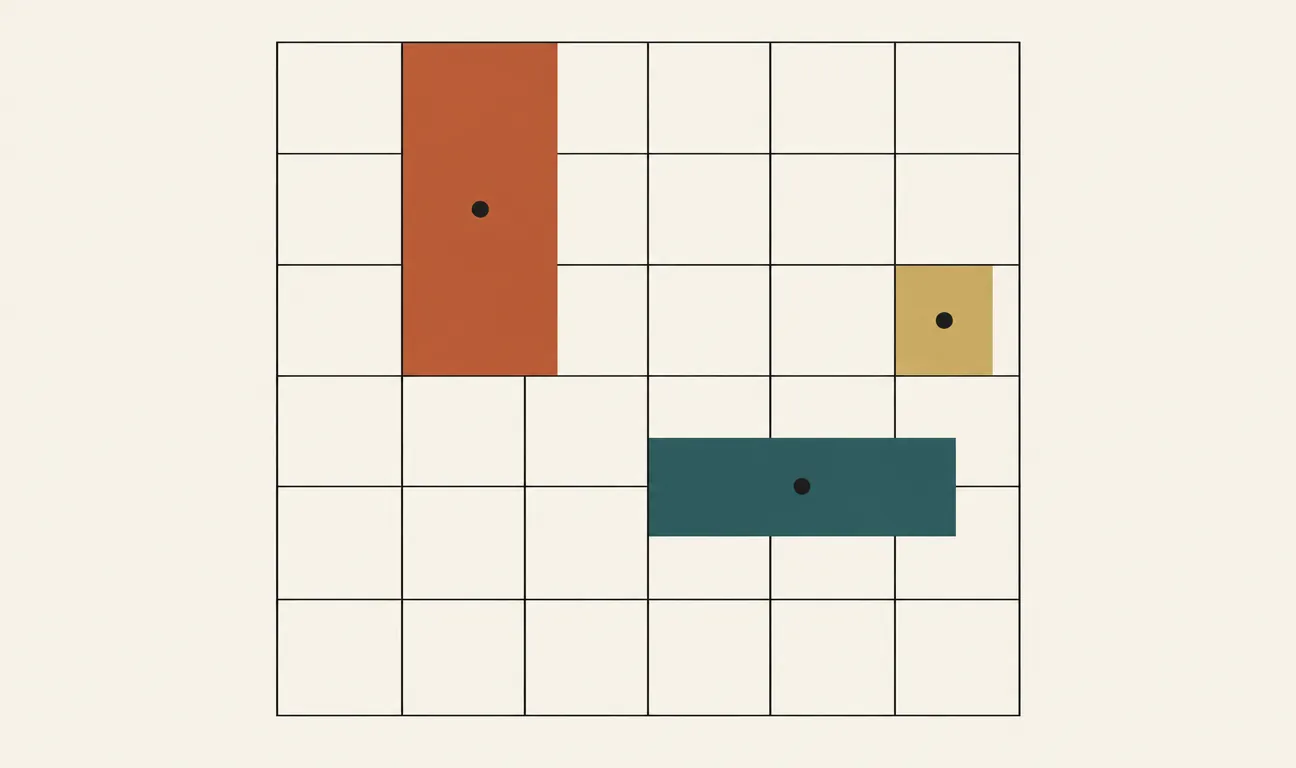
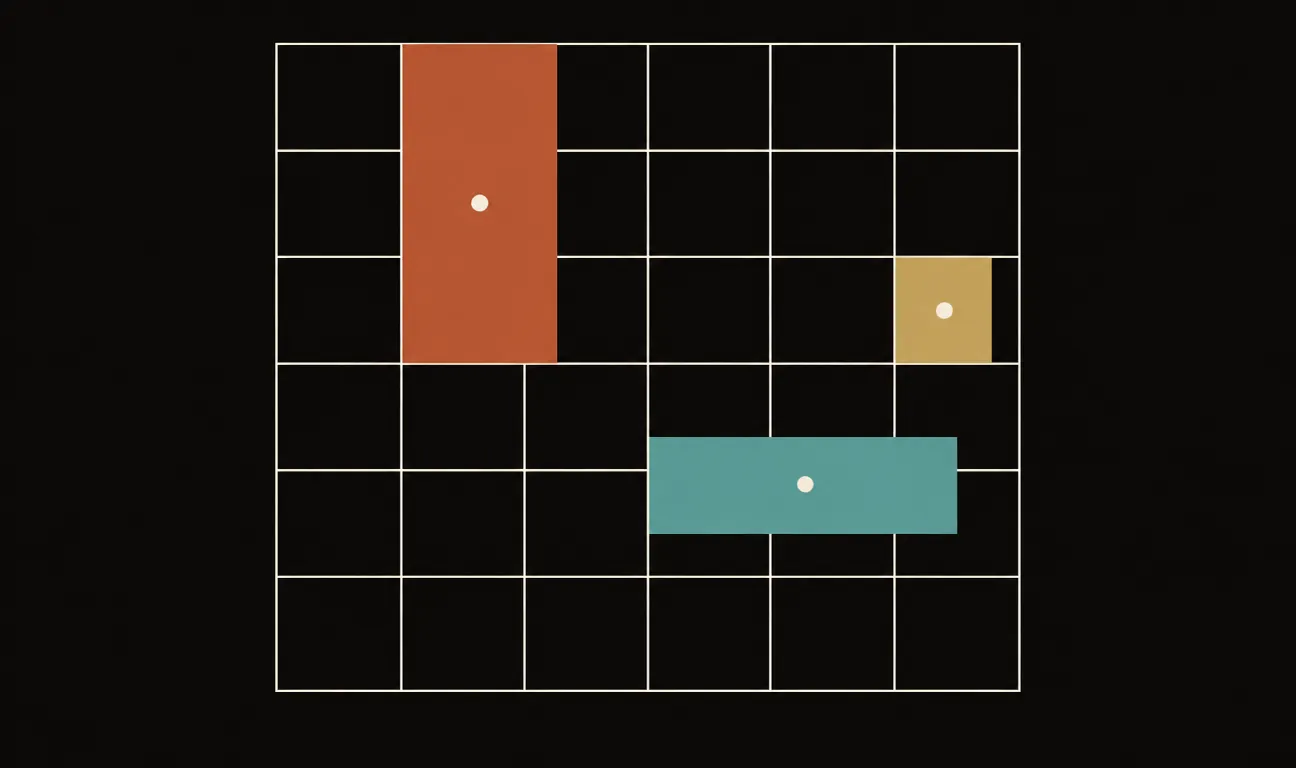
YOLO elimina la catena di montaggio. Riformula il problema come una singola regressione: una sola rete neurale che, dall’immagine grezza, produce direttamente i riquadri degli oggetti e le loro etichette. Il meccanismo è geometrico. L’immagine viene divisa in una scacchiera di 7 × 7 caselle. Ogni casella ha una responsabilità precisa: se il centro di un oggetto cade dentro di lei, tocca a lei rilevarlo.
Ogni casella predice due riquadri candidati — posizione, dimensioni e un punteggio di confidenza — più la probabilità delle classi presenti. Il tutto in un colpo solo: una sola passata della rete produce un blocco di numeri di forma 7 × 7 × 30, che contiene tutte le predizioni della foto insieme. La rete che macina questo calcolo ha 24 strati convoluzionali seguiti da 2 strati densi, e legge un’immagine ridimensionata a 448 × 448 pixel.
Il fatto che tutto passi per una sola rete cambia anche il modo in cui il sistema si addestra. YOLO si allena da capo a fondo con un unico obiettivo: la stessa funzione di costo misura insieme quanto sono precisi i riquadri e quanto sono giuste le classi, e corregge l’intera rete di conseguenza. Non ci sono moduli separati da mettere a punto uno alla volta e poi far combaciare a mano. Meno pezzi da incastrare significa anche meno punti in cui qualcosa può disallinearsi lungo la catena.
Ogni casella della griglia 7 × 7 predice riquadri, punteggio di confidenza e classe. Una sola passata della rete produce l’intero blocco 7 × 7 × 30: il rilevamento diventa un unico calcolo invece di migliaia di controlli separati.
Velocità contro precisione
I numeri raccontano il compromesso con onestà. Il modello base gira a 45 fotogrammi al secondo: tempo reale, cioè abbastanza veloce da seguire un video mentre scorre. Una versione alleggerita, Fast YOLO, arriva a 155 fotogrammi al secondo mantenendo, scrivono gli autori, il doppio dell’accuratezza media degli altri rilevatori in tempo reale. Sul banco di prova PASCAL VOC 2007 il modello base ottiene una mAP — la misura standard di accuratezza per il rilevamento — del 63,4%.
Va detto senza giri di parole: al momento della pubblicazione, i sistemi a due tempi più curati raggiungevano una precisione più alta. YOLO non vince sull’accuratezza pura; vince sul rapporto tra accuratezza e velocità. È la scelta di chi preferisce un rilevamento buono adesso a uno impeccabile ma troppo tardi.
C’è però un vantaggio che nasce proprio dall’aver guardato tutto insieme. Poiché la rete vede l’intera immagine e non un ritaglio isolato, coglie il contesto globale della scena. Il risultato, misurato nel paper: YOLO commette più errori di localizzazione — i riquadri sono meno precisi — ma è meno propenso a «vedere» oggetti dove c’è solo sfondo. Gli autori mostrano anche che generalizza meglio di DPM e R-CNN quando passa dalle fotografie a domini diversi, come le opere d’arte.
YOLO non ha reso il rilevamento più accurato: ha reso accurato abbastanza qualcosa che finalmente era anche veloce.
Dove sbaglia
La stessa scelta geometrica che dà velocità impone dei limiti, e il paper non li nasconde. Ogni casella può impegnarsi su un numero ristretto di oggetti: quando molte cose piccole si accalcano nello stesso punto — uno stormo di uccelli, una folla in lontananza — la griglia satura e YOLO ne perde diversi. È il prezzo di dividere l’immagine in caselle fisse: dove la scena è densa, la scacchiera è troppo grossolana. Anche i riquadri, come si è visto, tendono a essere meno aderenti rispetto ai metodi a due tempi. C’è poi un vincolo strutturale: nel modello ogni casella si impegna su una sola classe di oggetto, così due cose di tipo diverso che si sovrappongono nello stesso punto mettono in crisi la griglia. Sono limiti coerenti con il progetto, non difetti nascosti, e le versioni successive lavoreranno proprio su questi punti.
Perché ti riguarda
YOLO è il capostipite dei rilevatori «a stadio singolo», la famiglia di modelli che oggi fa girare il riconoscimento oggetti dove serve reattività: la fotocamera dello smartphone che riconosce i volti, il sistema che conta i pezzi su un nastro di produzione, l’assistenza alla guida. Ogni volta che una macchina identifica cose in un flusso video senza rallentarlo, sotto c’è l’eredità di questa idea.
Ma la lezione più trasferibile non è tecnica. È il gesto di riformulare la domanda. Per anni la comunità aveva perfezionato la risposta a «quali regioni dell’immagine vale la pena controllare?». Redmon e colleghi hanno cambiato la domanda in «e se guardassimo tutto in una volta?». Non sempre il progresso arriva da una risposta migliore alla vecchia domanda; a volte arriva da una domanda diversa. Vale per la visione artificiale come per qualunque problema tu stia cercando di risolvere.
Il paper originale
Joseph Redmon, Santosh Divvala, Ross Girshick, Ali Farhadi, You Only Look Once: Unified, Real-Time Object Detection, CVPR 2016. Testo integrale: arXiv:1506.02640.
I commenti sono riservati agli iscritti.
Accedi per commentare