
Nel 2015, a un challenge internazionale di analisi di immagini biomediche, si presenta un gruppo dell’Università di Friburgo con un problema che sembra squalificante in partenza: il deep learning dell’epoca vuole milioni di esempi, e loro di immagini annotate ne hanno una manciata — in uno dei task, trenta in tutto. Annotare immagini mediche costa carissimo: serve un esperto che tracci a mano il contorno di ogni cellula. Olaf Ronneberger, Philipp Fischer e Thomas Brox vincono comunque, e con margine. La loro rete si chiama U-Net, dal profilo a U del suo schema. Dieci anni dopo è ancora l’architettura di riferimento per la segmentazione biomedica, e — per una traiettoria che nessuno dei tre poteva prevedere — è diventata la spina dorsale dei modelli di diffusione che generano immagini dal testo.
Segmentare non è classificare
Le reti convoluzionali che dominavano la scena dopo AlexNet rispondevano a una domanda sola: cosa c’è in questa immagine? Un’etichetta per l’intera foto. La segmentazione chiede molto di più: per ogni singolo pixel, decidere a cosa appartiene. Non «in questa immagine c’è una cellula», ma «questi 4.812 pixel sono la cellula, questi il bordo, questi lo sfondo».
Il problema è che le due richieste tirano in direzioni opposte. Per capire cosa è un oggetto serve contesto: guardare una regione ampia, riassumere, astrarre. Per dire dove passa esattamente il suo contorno serve il contrario: precisione locale al pixel. Le reti di classificazione buttavano via la localizzazione strada facendo — a ogni livello di pooling la risoluzione si dimezza, e alla fine resta un riassunto semanticamente ricco ma geograficamente vago. L’approccio precedente per la segmentazione, una finestra scorrevole che classificava un pixel alla volta con il suo intorno, funzionava ma era lentissimo e rifaceva mille volte gli stessi calcoli su regioni sovrapposte.
La forma a U: scendere per capire, risalire per localizzare
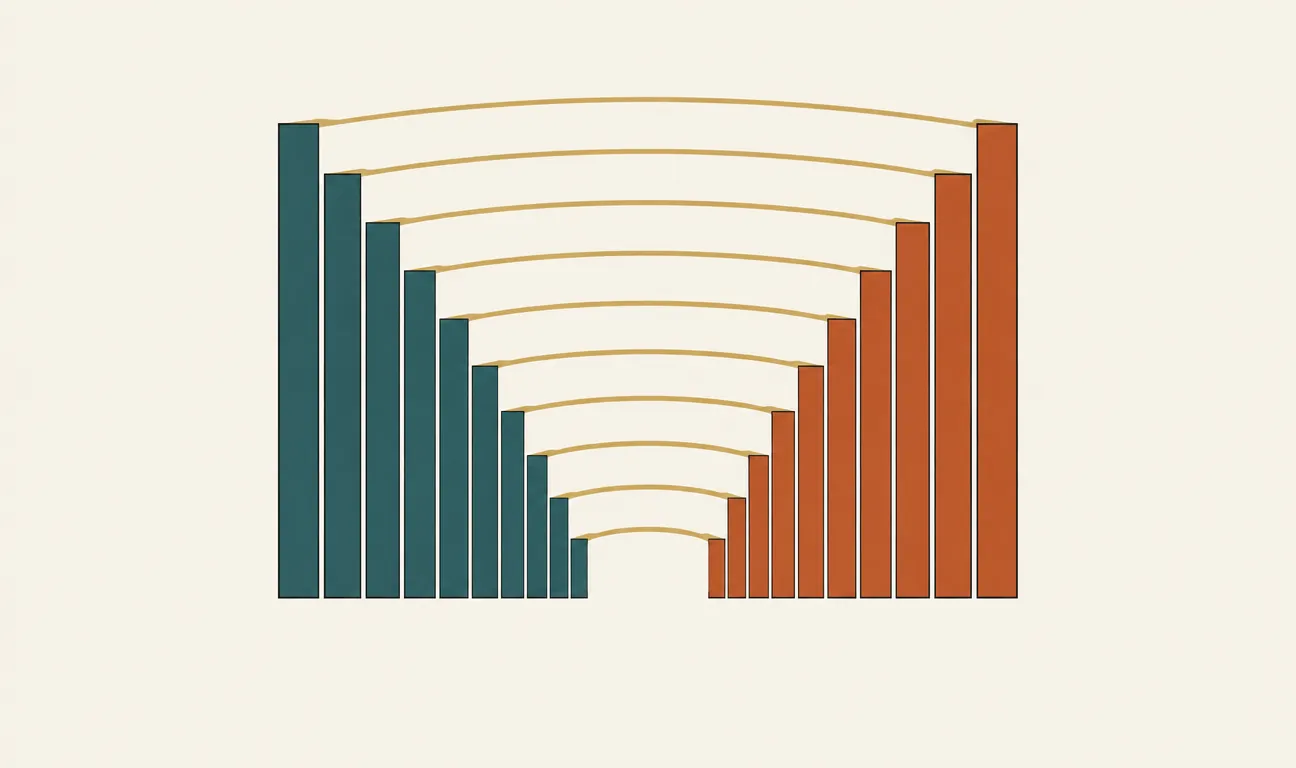
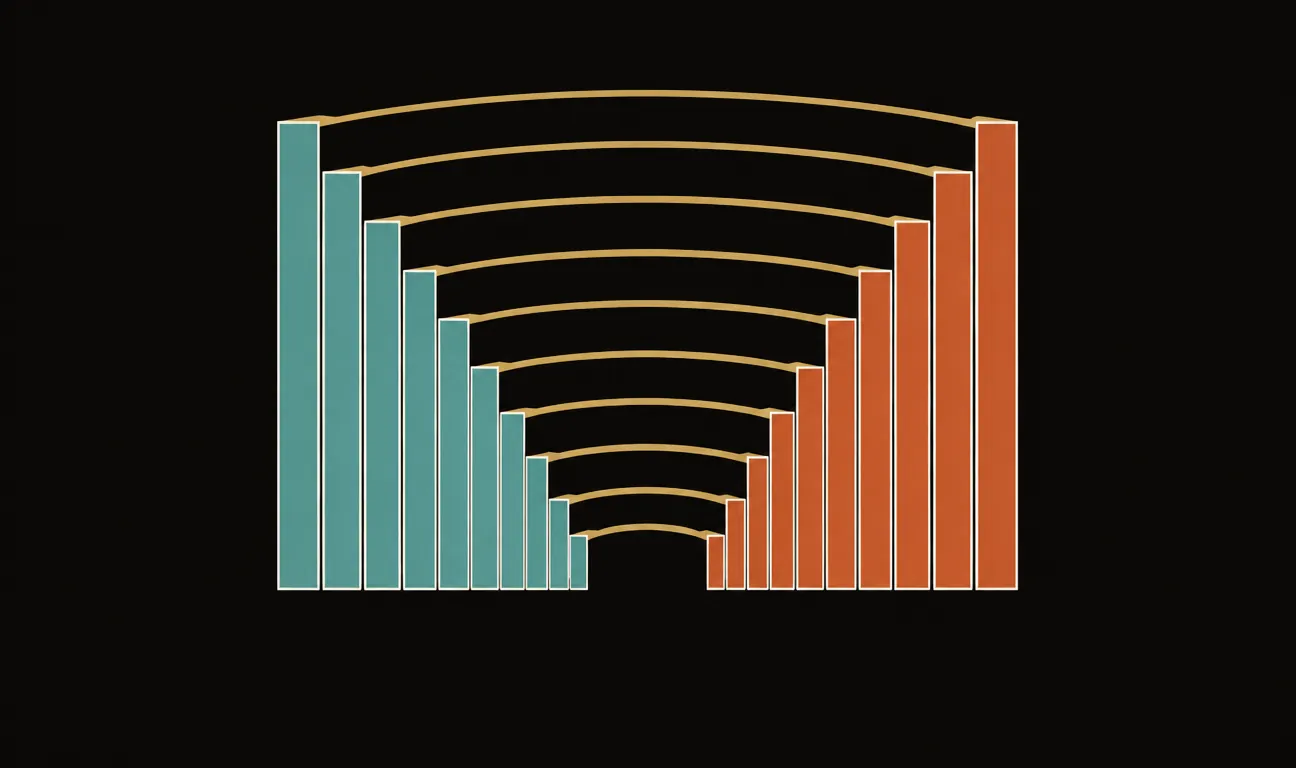
L’idea della U-Net è dare alla rete due bracci simmetrici. Il braccio che scende (il contracting path) è una normale rete convoluzionale: a ogni gradino la risoluzione si dimezza e il numero di canali raddoppia. L’immagine diventa una mappa sempre più piccola e sempre più astratta — in fondo alla U la rete «sa» cosa sta guardando, ma ha perso la precisione spaziale. Il braccio che sale (l’expanding path) fa il percorso inverso: a ogni gradino la risoluzione raddoppia, tramite convoluzioni di upsampling, e la mappa torna gradualmente alle dimensioni utili per decidere pixel per pixel.
Vista di profilo è una clessidra: larga, stretta al centro, di nuovo larga. Ma la clessidra da sola non basterebbe: quello che è andato perso scendendo — il dettaglio fine dei bordi — non si può reinventare risalendo. Serve il terzo ingrediente.
Le skip connection: il corridoio tra i due bracci
A ogni livello della U, una connessione orizzontale copia le mappe di attivazione del braccio discendente e le concatena a quelle del braccio ascendente alla stessa risoluzione. Il decoder, mentre risale, ha così davanti due fonti insieme: il riassunto astratto che arriva dal fondo della U («qui c’è una cellula») e la copia ad alta risoluzione di ciò che l’encoder vedeva a quel livello («i bordi precisi passavano qui»).
L’analogia che rende meglio è quella del restauratore. Ricostruire un affresco dalla sola descrizione («una figura femminile, panneggio azzurro») produce qualcosa di plausibile ma impreciso. Ricostruirlo con accanto le fotografie ad alta risoluzione scattate prima del danno permette di rimettere ogni linea al suo posto. Le skip connection sono quelle fotografie: il decoder non deve ricordare il dettaglio, gli viene riconsegnato.
La U-Net non chiede alla rete di scegliere tra capire e localizzare: le dà un percorso per fare la prima cosa e un corridoio per non perdere la seconda.
Vale la pena distinguere: le skip connection della ResNet, uscita lo stesso anno, sommano l’input all’output per facilitare l’ottimizzazione di reti profonde. Quelle della U-Net concatenano mappe tra rami diversi per preservare informazione spaziale. Stesso nome, funzione diversa.
La clessidra della U-Net: il braccio terracotta comprime e astrae, quello teal risale verso la risoluzione piena. Le linee tratteggiate ocra sono le skip connection, che riportano al decoder il dettaglio spaziale di ogni livello.
Vincere con trenta immagini
L’architettura da sola non spiega il risultato al challenge. La seconda metà del paper è una lezione di frugalità. Primo strumento: la data augmentation spinta, in particolare le deformazioni elastiche — l’immagine viene stirata e piegata localmente, come un timbro su gomma morbida. Per i tessuti biologici è un’augmentation quasi gratuita: una cellula deformata è ancora una cellula perfettamente realistica, e da trenta immagini se ne ottengono virtualmente infinite varianti plausibili.
Secondo strumento: una funzione di perdita pesata sui pixel che contano. Il tallone d’Achille della segmentazione cellulare sono le cellule adiacenti della stessa classe: se la rete fonde due cellule che si toccano, il conteggio è sbagliato anche se il 99% dei pixel è corretto. Gli autori calcolano una mappa di pesi che dà importanza sproporzionata ai sottili bordi di separazione, costringendo la rete a impararli per prima cosa. È una scelta che oggi chiameremmo di error shaping: dire al modello non solo cosa sbaglia, ma quali errori costano davvero.
Dal microscopio ai diffusion model
La U-Net avrebbe potuto restare un’architettura di nicchia per la microscopia. È successo l’opposto, per una ragione strutturale: qualunque compito che trasforma un’immagine in un’altra immagine della stessa dimensione — denoising, colorizzazione, super-resolution, stima della profondità — ha lo stesso fabbisogno della segmentazione: contesto globale più precisione locale. La clessidra con i corridoi risolve entrambi.
Il caso più rilevante è arrivato nel 2020, quando i modelli di diffusione hanno scelto proprio una U-Net come rete che, passo dopo passo, toglie rumore da un’immagine. Sistemi come Stable Diffusion hanno usato per anni varianti di U-Net come componente centrale del processo generativo. Se avete mai generato un’immagine da un prompt, con ogni probabilità una discendente della rete di Friburgo ha fatto gran parte del lavoro. Solo di recente le architetture basate su transformer hanno iniziato a sostituirla in questo ruolo — un ciclo di vita di quasi un decennio, un’eternità per questo campo.
Per chi lavora con dati veri, però, la lezione più utile del paper non è l’architettura: è il metodo. Pochi dati annotati non sono una condanna, se si investe dove conta — augmentation coerente con il dominio e una loss che rispecchia il costo reale degli errori. È la situazione di quasi ogni progetto applicato in azienda o in ospedale, dove i dataset da milioni di esempi semplicemente non esistono.
Il paper originale
Il paper è U-Net: Convolutional Networks for Biomedical Image Segmentation di Olaf Ronneberger, Philipp Fischer e Thomas Brox (Università di Friburgo), pubblicato su arXiv nel maggio 2015 e presentato alla conferenza MICCAI dello stesso anno. È uno dei paper più leggibili del canone: otto pagine, figure chiare, e la celebre illustrazione a U che ha dato il nome all’architettura. Consigliata la lettura delle sezioni su augmentation e loss pesata, spesso saltate ma — come si è visto — metà del merito.
I commenti sono riservati agli iscritti.
Accedi per commentare