
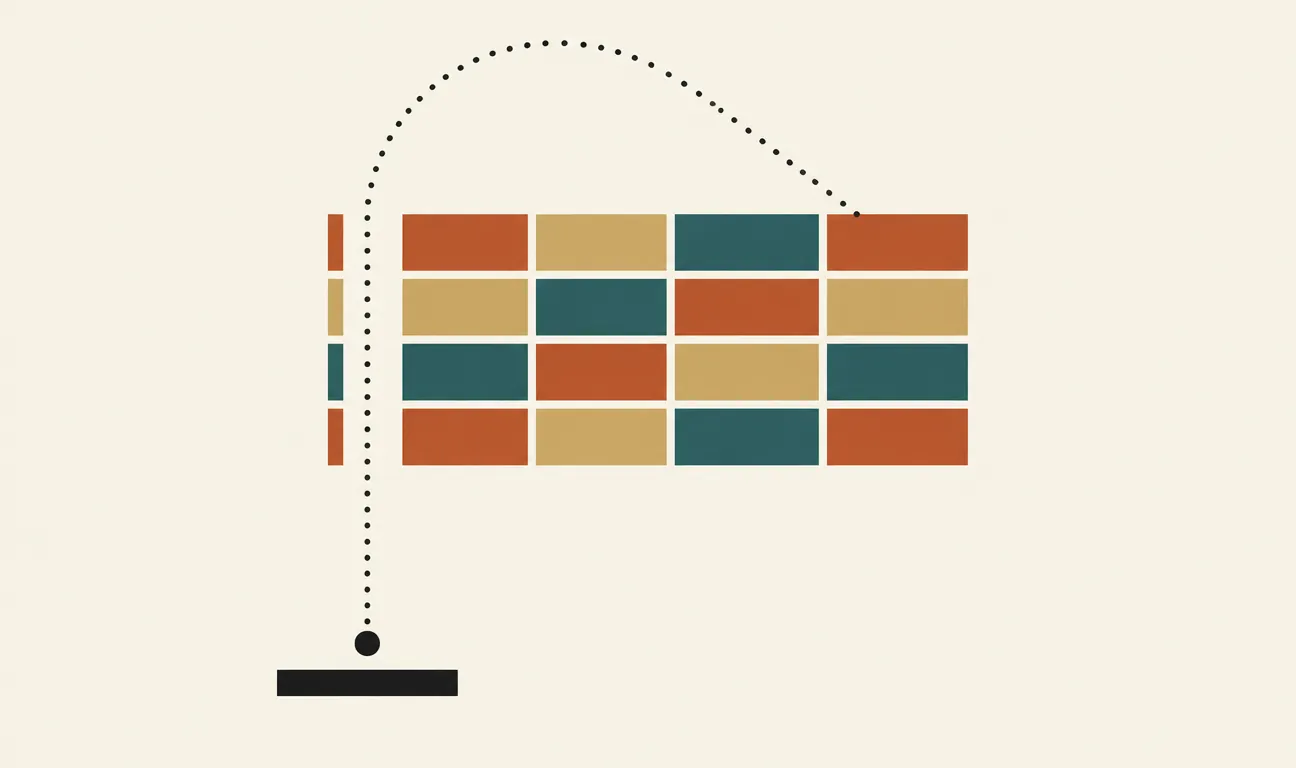
In Breakout, il vecchio gioco Atari in cui una pallina sbriciola un muro di mattoncini, esiste una mossa che i giocatori umani scoprono con orgoglio: invece di rimbalzare la pallina in modo disordinato, conviene scavare un tunnel su un lato, farla passare dietro il muro e lasciare che rimbalzi da sola contro il soffitto, demolendo i mattoncini dall’alto senza più fatica. Nel 2015 una rete neurale addestrata da un gruppo di DeepMind arrivò da sola a quella strategia. Nessuno gliel’aveva insegnata, nessuno le aveva spiegato cos’è un mattoncino o una pallina: aveva davanti solo i pixel dello schermo e un numero, il punteggio, che ogni tanto saliva. Il paper che racconta come ci riuscì si intitola Human-level control through deep reinforcement learning, e la sua importanza non sta nell’aver battuto un videogioco, ma nell’aver reso finalmente stabile un’unione che fino ad allora tendeva a esplodere.
Dalla tabella alla rete, la triade fatale e i due accorgimenti che tengono in piedi l’addestramento: nel libro.
Un giocatore che vede solo pixel
Immaginate di essere seduti davanti a una console con un joystick, ma di non conoscere le regole di nessun gioco. Non sapete nemmeno quale gioco sia. Vedete solo lo schermo cambiare e, in un angolo, un contatore. Provate a muovere il joystick a caso e osservate cosa succede al contatore. Dopo migliaia di partite cominciate a intuire quali gesti, in quali configurazioni dello schermo, fanno salire quel numero. È esattamente la situazione in cui i ricercatori hanno messo il loro agente. L’ingresso della rete non è una descrizione del gioco, ma l’immagine grezza: quattro fotogrammi consecutivi ridotti a una griglia di 84×84 pixel — quattro perché da un solo fotogramma non capiresti in che direzione si muove la pallina. L’uscita è il valore stimato di ciascuna mossa possibile del joystick.
Questo è il cuore del reinforcement learning, l’apprendimento per rinforzo: non ci sono esempi etichettati come nell’apprendimento supervisionato, dove qualcuno ti mostra la risposta giusta. C’è solo un ambiente, delle azioni e una ricompensa che arriva col contagocce, spesso in ritardo rispetto alla mossa che l’ha causata. La difficoltà è tutta qui: come fai a capire che è stato il tunnel scavato trenta secondi fa a farti guadagnare quei punti adesso?
Q: quanto vale premere un tasto
La risposta del paper si appoggia a un’idea più vecchia, il Q-learning. La lettera Q sta per quality: per ogni situazione sullo schermo e per ogni mossa, esiste un numero che dice quanto conviene quella mossa, non per il punto immediato ma per tutti i punti che ci si può aspettare da lì in avanti giocando bene. È lo stesso ragionamento di uno scacchista che guarda la scacchiera e pensa «questa mossa non cattura nulla adesso, ma mi porta in una posizione che vale». Se conoscessi il valore Q esatto di ogni mossa in ogni schermata, giocare sarebbe banale: scegli sempre la mossa col valore più alto.
Il problema è che le schermate possibili di un gioco Atari sono astronomiche, impossibile compilarne una tabella. Qui entra il deep: al posto della tabella si usa una rete neurale convoluzionale — tre strati convoluzionali che leggono l’immagine più due strati densi — che approssima la funzione Q. Le date la schermata, ti restituisce un valore stimato per ogni tasto. L’idea di usare una rete per questo non era nuova; era nota per essere instabile. Addestrata in modo ingenuo, la rete tendeva a divergere, a inseguire se stessa fino a produrre numeri privi di senso. Il contributo del paper è soprattutto aver capito perché, e averlo aggirato con due accorgimenti.
Il ciclo si chiude su se stesso. La rete guarda lo schermo e stima quanto vale ogni mossa; quella scelta produce (a volte) un punto; quel reward torna indietro come segnale che aggiusta le stime, spingendole verso il valore che avrebbero dovuto avere. Ripetuto milioni di volte, questo aggiustamento fa emergere una strategia.
Due trucchi per non impazzire
Il primo si chiama experience replay. Un agente ingenuo impara dal momento presente e poi lo dimentica: usa lo schermo di adesso, si corregge, passa oltre. Ma i fotogrammi consecutivi di un gioco si somigliano moltissimo — la pallina si è spostata di poco — e imparare da una sequenza così correlata è come studiare per un esame leggendo mille volte la stessa pagina di seguito: ci si fissa e si perde l’insieme. La soluzione è tenere un diario, una memoria delle ultime esperienze (nel paper, un milione di transizioni), e allenarsi ripescandone a caso qualche pagina alla volta. Mescolando il passato, si spezza la correlazione e si sfrutta ogni esperienza più volte.
Il secondo è la rete bersaglio, il target network. Il guaio del Q-learning con reti neurali è che il valore verso cui ti correggi lo calcoli con la stessa rete che stai correggendo: insegui un bersaglio che si sposta a ogni tuo passo, come cercare di colpire la propria ombra. Il rimedio è quasi ovvio una volta detto: si congela una copia della rete e la si usa come riferimento fisso per un po’, aggiornandola solo di tanto in tanto. Il bersaglio smette di scappare e l’addestramento si stabilizza. A questo si aggiunge un dettaglio pratico, il clipping della ricompensa: tutti i punti vengono ridotti a +1, 0 o −1, così un gioco con punteggi enormi non schiaccia uno con punteggi piccoli, e la stessa ricetta funziona ovunque.
Non impari dal presente mentre scorre, ma da un diario di ricordi ripescati a caso: è così che l’agente ha smesso di fissarsi e ha cominciato a vedere l’insieme.
Quarantanove giochi, una sola ricetta
La prova di forza del paper non è un singolo record, ma l’uniformità. Lo stesso identico algoritmo, la stessa architettura di rete e gli stessi iperparametri furono applicati a 49 giochi Atari diversi, da Space Invaders a Pong, senza ritocchi su misura. In 43 di quei 49 giochi l’agente superò i migliori metodi automatici precedenti. In 29 giochi raggiunse più del 75% del punteggio di un collaudatore umano professionista — in alcuni casi surclassandolo, in altri restando sotto. Dove falliva, il fallimento era istruttivo: nei giochi che richiedono di pianificare a lungo termine, come Montezuma’s Revenge, dove la ricompensa arriva solo dopo lunghe sequenze di mosse apparentemente inutili, l’agente restava a mani vuote. Il suo orizzonte era troppo corto.
Perché è ancora un riferimento
Per chi programma sistemi di apprendimento per rinforzo, DQN è il punto di partenza da cui quasi tutto il resto discende: Double DQN, le reti duelling, il prioritized replay sono correzioni e raffinamenti diretti di questo schema. Ma la lezione più larga vale anche per chi non scriverà mai una riga di questo codice. DQN ha mostrato che un sistema può costruirsi da solo una rappresentazione utile del mondo partendo da dati grezzi e da un unico segnale di ricompensa, senza che nessuno gli spieghi le regole. È lo stesso principio che, anni dopo, ritroviamo nell’apprendimento per rinforzo usato per allineare i grandi modelli linguistici: cambia l’ambiente — non più uno schermo Atari ma una conversazione — ma l’ossatura, imparare da una ricompensa invece che da esempi già risolti, è quella collaudata qui. Vale la pena ricordarlo quando si parla di «AI che impara da sola»: la frase è vaga, ma dietro ha meccanismi precisi, e molti sono nati in queste pagine.
Il paper
Volodymyr Mnih, Koray Kavukcuoglu, David Silver, Andrei A. Rusu, Joel Veness, Marc G. Bellemare e altri, Human-level control through deep reinforcement learning, Nature 518, 529–533 (2015). DOI: 10.1038/nature14236.
I commenti sono riservati agli iscritti.
Accedi per commentare