Deep Learning
Paper Summary
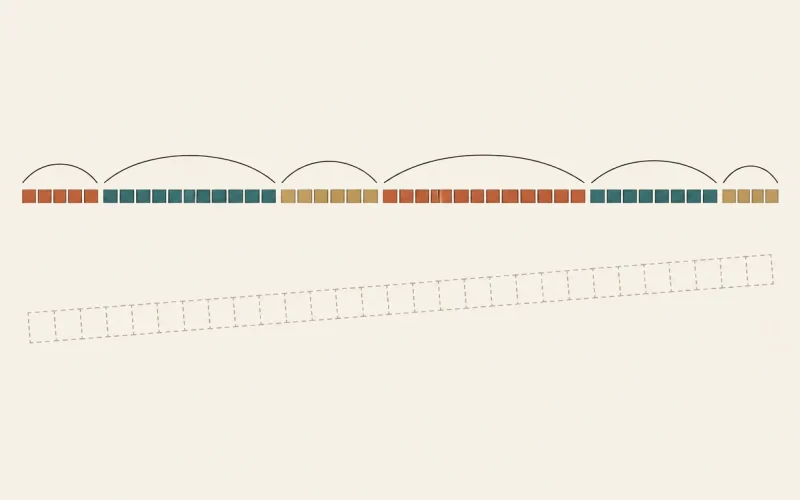
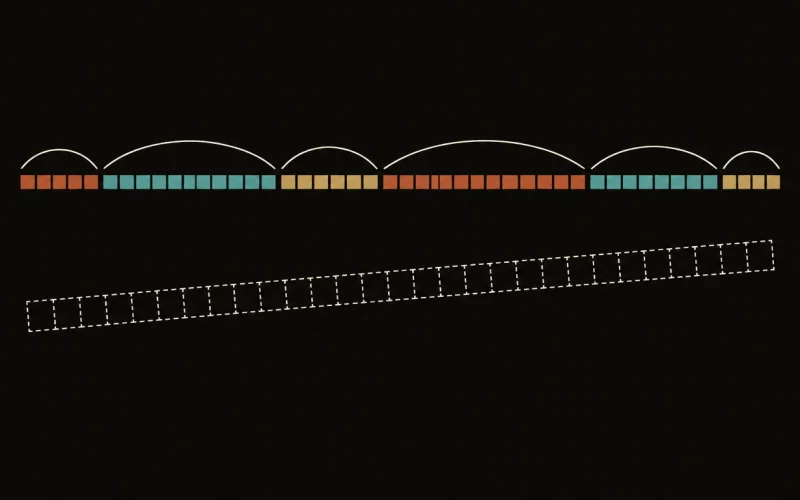
Byte Latent Transformer (2024): addio al tokenizer
Prima di leggere anche una sola parola, ogni modello linguistico spezza il testo in token secondo un vocabolario fisso deciso…