q0: pretraining a iper-epoca, o come sfruttare il budget di calcolo oltre la saturazione
Quando il testo di qualità finisce ma il calcolo abbonda, ripassare gli stessi dati smette presto di aiutare un modello.…
Uno studio di PricewaterhouseCoopers mette alla prova un'intuizione scomoda: nella ricerca agentica il vecchio grep batte spesso la ricerca semantica…
Ricercatori di Apple mostrano che un modello può migliorare a scrivere codice riaddestrandosi sui propri output grezzi, senza verificatore, insegnante…
Le reti ricorrenti sono efficienti ma dimenticano; i transformer ricordano tutto ma costano il quadrato. Un gruppo di Google propone…
Da mesi si distribuiscono "skill" per gli agenti AI, schede di procedure che dovrebbero renderli più bravi. Un benchmark le…
Un gruppo del MIT guidato da Kaiming He sposta la parte ripetitiva della generazione dal momento in cui si produce…
Le mappe di attenzione di un Vision Transformer dicono quali patch si guardano, non cosa si scambiano. Un gruppo di…
Tre ricercatori costruiscono "gallerie del vento" bayesiane, compiti dove la risposta esatta è nota in anticipo e la memorizzazione è…
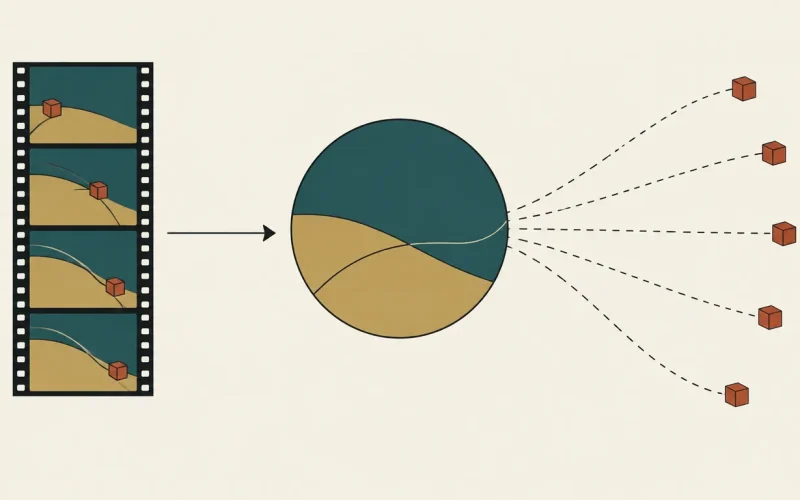
Un gruppo di Meta e New York University addestra un "modello del mondo" su oltre 900 ore di video, in…
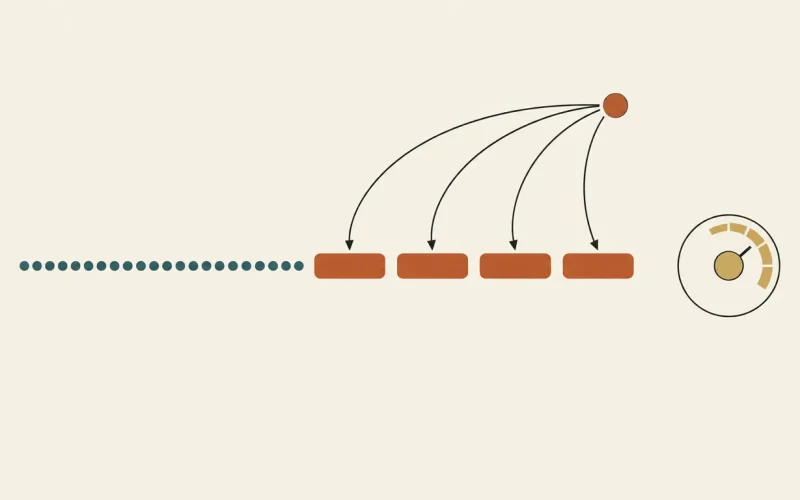
Un modello che comprime il passato in sintesi e vi presta attenzione, con una manopola per scegliere a inferenza quanto…