
«Il gatto ____ sul divano.» Coprite una parola qualsiasi in una frase e chiedete a chiunque di indovinarla: userà istintivamente ciò che viene prima e ciò che viene dopo. «Divano» e «gatto» insieme suggeriscono «dorme», forse «salta», di sicuro non «piove». È un esercizio che a scuola si chiama cloze, ed esiste da molto prima dei computer. Nel 2018 quattro ricercatori di Google lo hanno trasformato nel modo in cui una macchina impara a leggere. Il modello si chiama BERT, e per qualche anno è stato il motore silenzioso dietro buona parte della comprensione del linguaggio nei prodotti reali.
GPT, BERT e T5 come tre modi di studiare la lingua, e cosa succede oltre il testo: nel libro.
Leggi «Le famiglie di modelli, e oltre il testo» nel libro →
Leggere in una sola direzione costa caro
Fino a quel momento, quasi tutti i modelli di linguaggio leggevano da sinistra a destra: dato l’inizio di una frase, prevedi la parola successiva. È un obiettivo naturale e funziona benissimo per generare testo, una parola dopo l’altra. Ma per capire il testo è un vincolo assurdo. Quando leggi una parola ambigua, il contesto che la disambigua spesso arriva dopo. In «ho versato il vino nel bicchiere finché non fu pieno», chi è pieno? Il bicchiere. Lo sai solo perché hai letto fino in fondo.
Il problema è che non si può addestrare ingenuamente un modello profondo a guardare in entrambe le direzioni con l’obiettivo classico. Se ogni parola può vedere tutte le altre attraverso gli strati della rete, allora — indirettamente — può vedere anche se stessa: il compito «indovina la parola successiva» diventa banale, perché la risposta è già in input. È come dare a uno studente un test a completamento in cui le parole da indovinare sono stampate a fondo pagina. Tentativi precedenti aggiravano l’ostacolo in modo goffo: ELMo addestrava separatamente un modello sinistra-destra e uno destra-sinistra e ne concatenava i risultati alla fine, mentre GPT restava rigorosamente unidirezionale. Nessuno dei due era davvero, profondamente bidirezionale.
Il trucco del cloze: nascondere per imparare
La mossa di BERT è cambiare il gioco. Invece di prevedere la parola successiva, maschera a caso il 15% delle parole di un testo e chiede al modello di ricostruirle usando tutto il resto, a sinistra e a destra. Si chiama masked language model, ed è esattamente il cloze scolastico. Il problema del «vedere se stessi» sparisce di colpo: la parola nascosta non è in input, quindi il modello può guardare liberamente in ogni direzione senza barare.
C’è un dettaglio ingegnoso in quel 15%. Non tutte le parole scelte vengono coperte con il segnaposto [MASK]: nell’80% dei casi sì, ma nel 10% vengono sostituite con una parola casuale e nel restante 10% lasciate intatte. Il motivo è pratico. Quando poi userai BERT su un testo vero, il segnaposto [MASK] non comparirà mai; se il modello imparasse a lavorare solo in presenza di quel simbolo, in produzione andrebbe in crisi. È come un insegnante che a volte cancella una parola, a volte ne infila una sbagliata, a volte la lascia giusta: lo studente non può mai rilassarsi e deve valutare ogni parola, anche quelle che sembrano a posto.
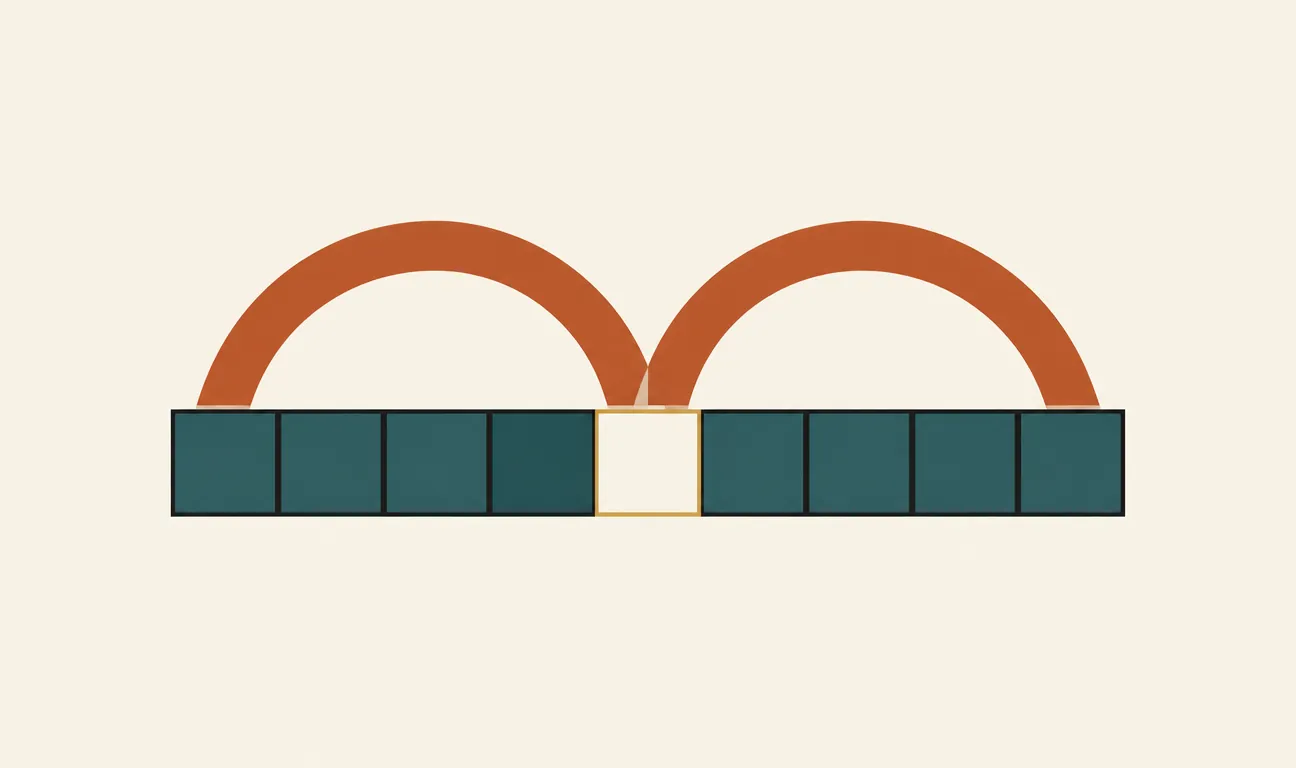
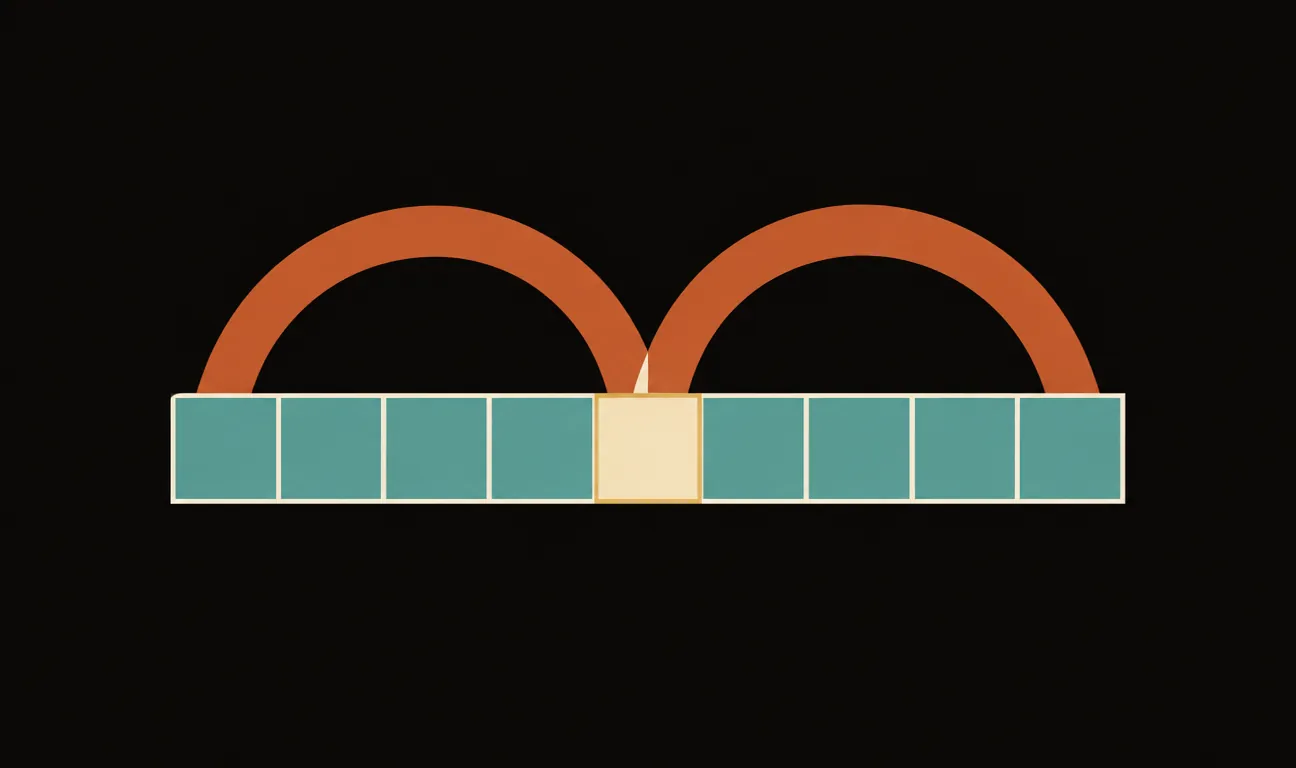
Il masked language model in una frase: la parola nascosta (terracotta) viene ricostruita facendo convergere su di essa sia il contesto che precede (teal) sia quello che segue (ocra). L’encoder bidirezionale lascia che ogni posizione guardi in entrambe le direzioni, cosa impossibile per un modello che prevede solo la parola successiva.
La seconda lezione: due frasi vanno insieme?
Al mascheramento BERT affianca un secondo compito di addestramento, la next sentence prediction: date due frasi, il modello deve dire se la seconda segue davvero la prima nel testo originale o se è stata pescata a caso. L’idea era insegnare alla rete le relazioni tra frasi, utili per compiti come rispondere a domande o riconoscere se un’affermazione ne implica un’altra. Qui vale la pena di essere onesti: lavori successivi, RoBERTa in testa, hanno mostrato che questo secondo compito contribuisce poco e si può eliminare senza danni. È un promemoria utile — non tutte le componenti di un articolo influente si rivelano essenziali, e distinguere l’idea centrale dagli orpelli è parte del mestiere di leggere la ricerca.
Prima impari tutto, poi ti specializzi
La vera eredità di BERT non è un singolo trucco ma una struttura in due tempi. Nel primo, il pre-training, il modello si allena sui due compiti appena descritti divorando un’enorme quantità di testo senza etichette: BooksCorpus, circa 800 milioni di parole, più l’intera Wikipedia inglese, circa 2,5 miliardi, per un totale intorno ai 3,3 miliardi di parole. È un investimento costoso, ma si fa una volta sola. Nel secondo tempo, il fine-tuning, si prende quel modello già «colto» e lo si specializza su un compito preciso — classificare recensioni, estrarre risposte, riconoscere entità — aggiungendo un sottile strato finale e riaddestrando su pochi dati etichettati.
È la stessa logica per cui a un laureato in lettere non insegni l’italiano da capo prima di affidargli la revisione di un testo: la competenza generale è già lì, basta orientarla. BERT viene rilasciato in due taglie: la versione base con 12 strati, dimensione nascosta 768 e 12 teste di attenzione, per un totale di 110 milioni di parametri; e la versione large con 24 strati, dimensione 1024 e 16 teste, che arriva a 340 milioni.
L’idea che è sopravvissuta non è «mascherare le parole», ma «impara il linguaggio una volta su tutto il testo del mondo, poi adatta quel sapere a mille compiti diversi».
I numeri che hanno convinto tutti
All’uscita, BERT stabilisce nuovi risultati di riferimento su un’intera batteria di test. Sul benchmark GLUE, che aggrega nove compiti di comprensione del linguaggio, raggiunge un punteggio di 80,5, con un balzo di 7,7 punti sul precedente stato dell’arte. Sul SQuAD v1.1, dataset di domande e risposte, arriva a un F1 di 93,2; sulla versione 2.0, più difficile, a 83,1. Sul test di inferenza MultiNLI tocca l’86,7% di accuratezza. Sono margini ampi per un campo dove di solito si guadagnano frazioni di punto, ed è questo che ha spostato l’intera comunità sul paradigma pre-training più fine-tuning nel giro di pochi mesi.
Perché ti riguarda ancora
Nell’era dei modelli generativi giganti è facile archiviare BERT come un pezzo di storia. Sarebbe un errore. BERT è un encoder: non genera testo come un assistente conversazionale, lo comprende e lo rappresenta come vettori. E questa famiglia di modelli è ancora ovunque nei sistemi che usi senza vederli. Quando una ricerca capisce che cerchi il significato e non le parole esatte, quando un sistema di retrieval trova i documenti giusti da dare in pasto a un modello linguistico — il cuore delle architetture RAG — molto spesso a fare l’incontro tra la tua domanda e i testi è un encoder discendente da BERT.
Il motivo per cui vale la pena capirlo va oltre il modello specifico. BERT ha reso normale un’idea che oggi diamo per scontata: non serve un modello addestrato da zero per ogni problema, ne basta uno che abbia imparato il linguaggio in generale e che si adatti al resto. Ogni volta che qualcuno «affina» un modello preesistente sui propri dati invece di costruirne uno nuovo, sta seguendo la strada che questo articolo ha reso praticabile. La direzione da cui leggi conta: BERT lo ha dimostrato guardando, per la prima volta davvero, in tutte e due.
Il paper originale
Jacob Devlin, Ming-Wei Chang, Kenton Lee, Kristina Toutanova (Google AI Language), BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, 2018, presentato a NAACL 2019. Preprint su arXiv: arxiv.org/abs/1810.04805. Le cifre riportate qui (GLUE 80,5, SQuAD v1.1 F1 93,2, SQuAD v2.0 F1 83,1, MultiNLI 86,7%, dimensioni dei due modelli, mascheramento al 15% con la suddivisione 80/10/10, corpus di circa 3,3 miliardi di parole) provengono dall’articolo stesso.
I commenti sono riservati agli iscritti.
Accedi per commentare