
Immaginate di dare a un modello, dentro la stessa richiesta, tre righe: «mare → sea», «cane → dog», «casa → house», e poi «albero →». Il modello risponde «tree». Non l’avete addestrato a tradurre, non avete toccato i suoi parametri, non c’è stato alcun ri-addestramento nel mezzo. Gli avete solo mostrato il gioco, e lui l’ha capito al volo dagli esempi. Nel 2020 il paper di OpenAI Language Models are Few-Shot Learners ha fatto di questo comportamento — un modello che afferra un compito nuovo leggendo qualche esempio nel prompt — il centro della scena. Il modello che lo mostrava si chiama GPT-3, e con esso il baricentro del campo si è spostato: dall’addestrare modelli al saperli interrogare.
Il pretraining su scala web, le leggi di scala, e l’arte di scegliere la parola dopo — temperatura, top-p, KV cache — stanno nel libro.
Il problema che GPT-2 aveva lasciato aperto
Un anno prima, GPT-2 aveva sostenuto una tesi affascinante: un modello linguistico impara di straforo dei compiti che nessuno gli insegna. Ma restava una scomodità di fondo. Per adattare davvero bene un modello a un compito, lo schema dominante prevedeva ancora il fine-tuning: raccogliere migliaia di esempi etichettati e ri-addestrare il modello su quel dataset specifico. Funzionava, ma aveva un costo. Serviva un dataset annotato per ogni compito, il che è lento e caro; e un modello ottimizzato a fondo su un compito ristretto tende a diventare fragile fuori da quel recinto, come uno studente che ha memorizzato i temi d’esame e va nel panico appena la domanda cambia forma.
Gli esseri umani, osserva il paper, non funzionano così. A una persona bastano una consegna a parole e uno o due esempi per capire cosa deve fare. Non le si riscrive il cervello per ogni compito nuovo. La domanda degli autori è se un modello abbastanza grande possa avvicinarsi a questa flessibilità: imparare dal contesto, e non dall’addestramento.
In-context learning: imparare senza imparare
La risposta è il meccanismo che il paper chiama in-context learning, apprendimento nel contesto. Il modello resta congelato — i suoi pesi non cambiano mai durante l’uso — ma la richiesta che gli si passa contiene la lezione. Il paper distingue tre regimi crescenti. Nello zero-shot gli si dà solo l’istruzione a parole («traduci in francese:») e la frase da elaborare. Nel one-shot si aggiunge un singolo esempio svolto. Nel few-shot se ne mettono diversi, in genere da dieci a cento, quanti ne stanno nella finestra di contesto. Più esempi il modello vede nel prompt, meglio in media azzecca lo schema.
Il punto sottile, e facile da fraintendere, è che qui «imparare» è una metafora. Nulla viene salvato: finita la risposta, il modello non ricorda nulla di quegli esempi, e alla richiesta successiva riparte da zero. L’apprendimento avviene interamente dentro il singolo passaggio, come una lettura a mente fresca che si dimentica appena chiuso il libro. È la differenza tra insegnare un mestiere a qualcuno e mostrargli come si fa proprio mentre lo fa, sapendo che domani non se ne ricorderà.
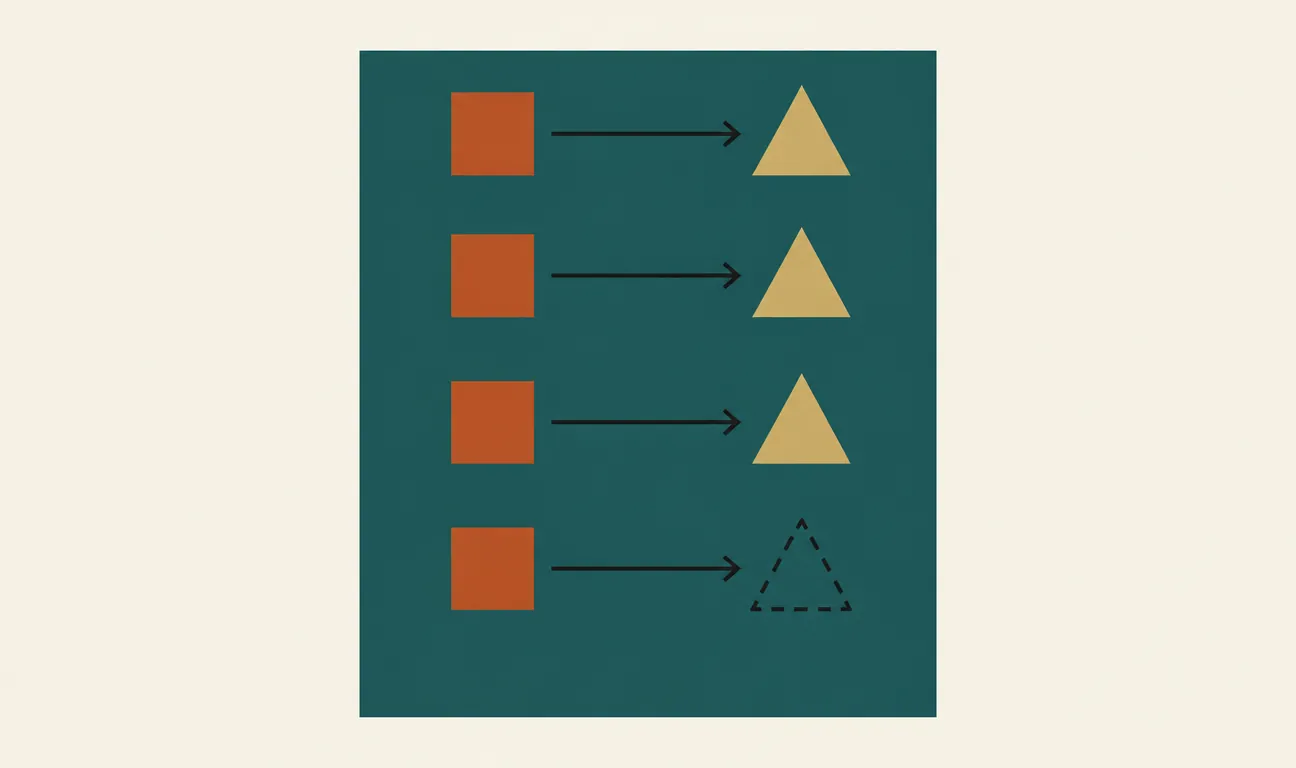
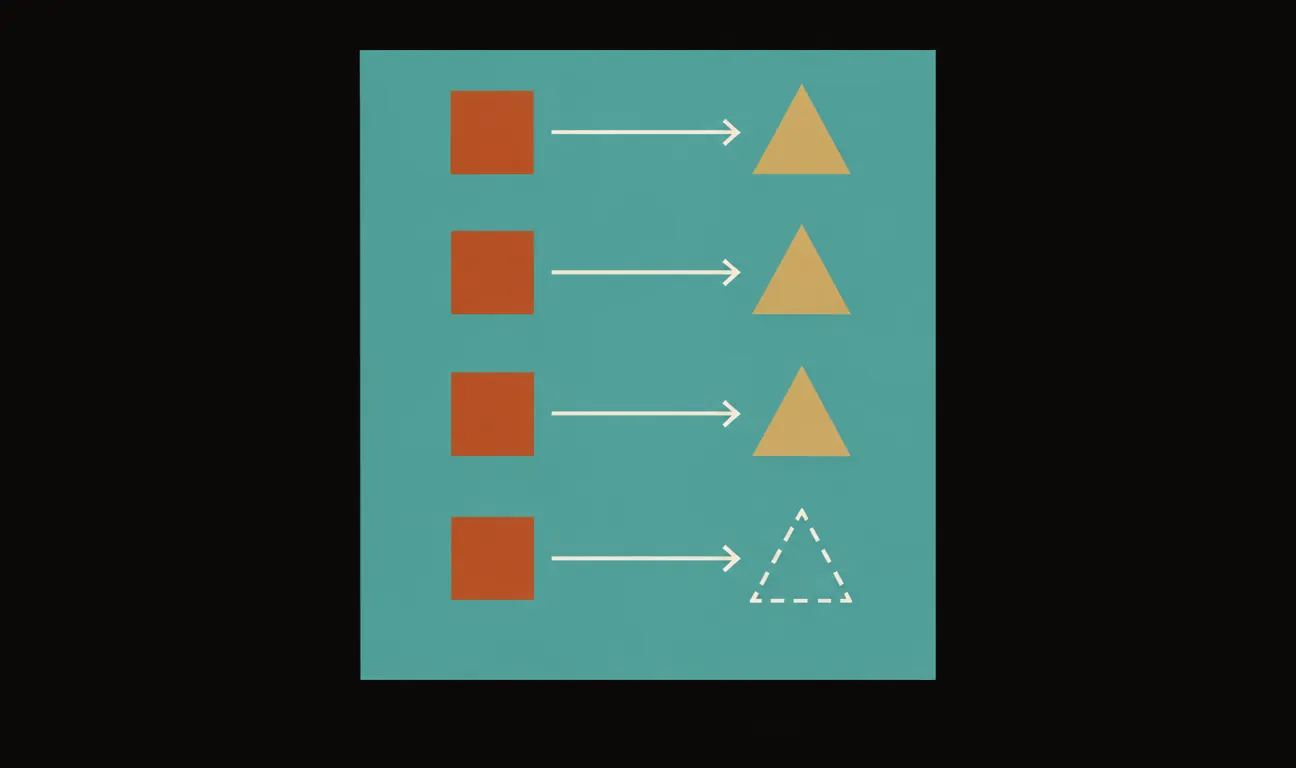
Nel few-shot gli esempi non addestrano il modello: viaggiano dentro lo stesso testo della domanda. Il modello resta congelato e legge tutto in un colpo solo, coglie lo schema degli esempi e lo applica alla domanda finale. Chiuso il prompt, non ne resta traccia.
Centosettantacinque miliardi di parametri
Perché nel 2020 e non prima? Perché l’in-context learning, secondo il paper, è una capacità che si fa robusta solo con la scala. Gli autori addestrarono otto modelli di taglia crescente, dai 125 milioni di parametri fino a 175 miliardi — dieci volte più grande di qualunque modello linguistico denso precedente — e misurarono come cambiava la capacità di imparare dagli esempi al crescere delle dimensioni. Il risultato è una tendenza netta: più il modello è grande, più il divario tra zero-shot e few-shot si allarga a favore del few-shot. I modelli piccoli guadagnano poco dagli esempi nel prompt; quelli grandi ne traggono molto. L’abilità di «capire il gioco al volo» non è programmata da nessuna parte: emerge come sottoprodotto della scala.
Il costo di questa scommessa è il testo. GPT-3 fu addestrato su circa 300 miliardi di token, pescati da una versione filtrata di Common Crawl, da libri, da Wikipedia e da un corpus di pagine web selezionate, con una finestra di contesto di 2048 token. È un’operazione da grande industria, non da laboratorio artigianale, e questo è già di per sé un pezzo della storia: da GPT-3 in poi, addestrare un modello di frontiera diventa qualcosa che pochi possono permettersi.
Non hanno inventato un nuovo tipo di apprendimento. Hanno preso lo stesso addestramento e lo hanno spinto finché una capacità latente è diventata affidabile.
Cosa sa fare e dove inciampa
Il paper è lungo e pieno di misurazioni, e la sua onestà sta nel documentare tanto i successi quanto i fallimenti. In few-shot, GPT-3 va forte su traduzione, domande a risposta chiusa, completamento di frasi, alcuni compiti di ragionamento improvvisato; su parecchi benchmark si avvicina a sistemi addestrati apposta, e su qualcuno li supera. Poi ci sono le crepe. Sull’aritmetica di più cifre il modello sbanda in modo rivelatore: azzecca somme semplici ma sbaglia man mano che i numeri crescono, segno che sta riconoscendo schemi visti nel testo più che calcolando. Gli autori mettono in guardia anche sul rischio di contaminazione — pezzi dei benchmark potrebbero essere finiti nel testo di addestramento, gonfiando i punteggi — e dedicano una sezione ai bias sociali appresi dal modello e ai possibili usi impropri. È un paper che descrive una capacità nuova senza venderla come magia.
L’articolo di giornale che nessuno riconosce
Un esperimento più di ogni altro fece discutere. Gli autori generarono brevi articoli di cronaca con il modello più grande e chiesero a lettori umani di distinguerli da articoli scritti da persone. La capacità dei valutatori di indovinare quale fosse la macchina risultò appena sopra il tiro di una moneta: poco più del caso. Non significa che GPT-3 scrivesse buon giornalismo — significa che a livello di singolo paragrafo la superficie della lingua era diventata difficile da smascherare. È il momento in cui la questione del testo sintetico smette di essere accademica ed entra nel dibattito pubblico, dove è rimasta.
Perché riguarda chi scrive prompt oggi
Se oggi il modo normale di usare un modello linguistico è scrivergli istruzioni ed esempi in linguaggio naturale, invece di ri-addestrarlo, è a questo paper che si deve la dimostrazione che la cosa funziona su scala larga. Tutto il vocabolario che diamo per scontato — zero-shot, few-shot, «dagli qualche esempio nel prompt» — nasce qui. Chi lavora con questi strumenti farebbe bene a tenere a mente anche la parte scomoda: l’in-context learning non ragiona, riconosce schemi, e per questo brilla dove il compito somiglia a qualcosa già visto e vacilla dove serve calcolo esatto o vera novità. Rileggere GPT-3 nel 2026, con anni di modelli più capaci alle spalle, serve proprio a questo: ricordare che l’interfaccia che usiamo tutti i giorni è nata da una scommessa sulla scala, non da una teoria della comprensione.
Il paper
Tom B. Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah e altri (31 autori in totale), Language Models are Few-Shot Learners, 2020. Presentato a NeurIPS 2020, disponibile su arXiv: arxiv.org/abs/2005.14165.
I commenti sono riservati agli iscritti.
Accedi per commentare