
Ottobre 2018: Google pubblica BERT e nel giro di pochi mesi il modello scala le classifiche di quasi tutti i benchmark di comprensione del linguaggio. Pochi mesi prima, con molto meno clamore, OpenAI aveva presentato GPT, un modello che invece di classificare frasi le continuava. Stessa architettura di partenza — il Transformer del 2017 — ma due tagli chirurgici opposti: BERT tiene solo l’encoder, GPT solo il decoder. Da quella biforcazione discende gran parte della NLP degli ultimi anni, incluso il fatto che oggi parliamo con i modelli invece di usarli solo per etichettare testi.
GPT, BERT e T5 come tre modi di studiare la lingua, e cosa succede oltre il testo: nel libro.
Leggi «Le famiglie di modelli, e oltre il testo» nel libro →
Un’architettura, due metà
Il Transformer originale era pensato per la traduzione automatica e aveva due componenti: un encoder che legge la frase di partenza tutta intera e ne costruisce una rappresentazione, e un decoder che produce la traduzione una parola alla volta, guardando sia la rappresentazione dell’encoder sia le parole già generate.
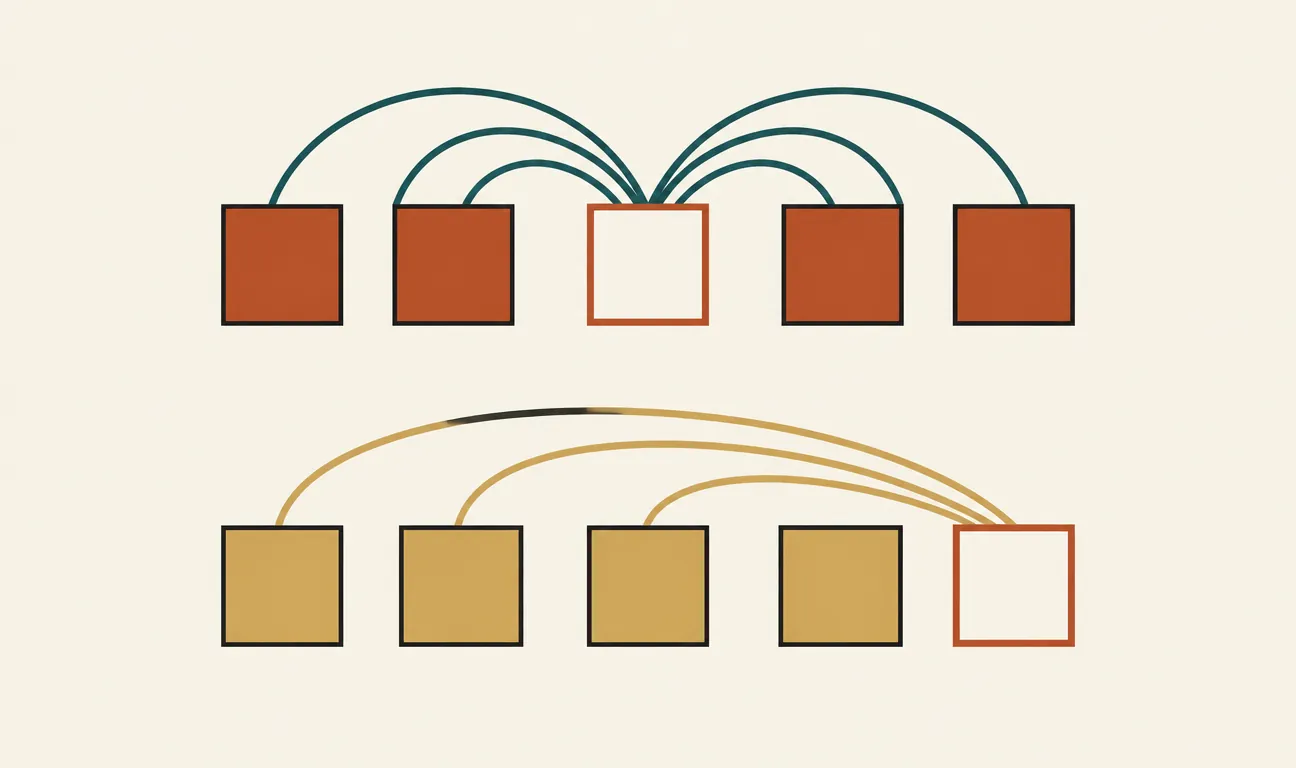
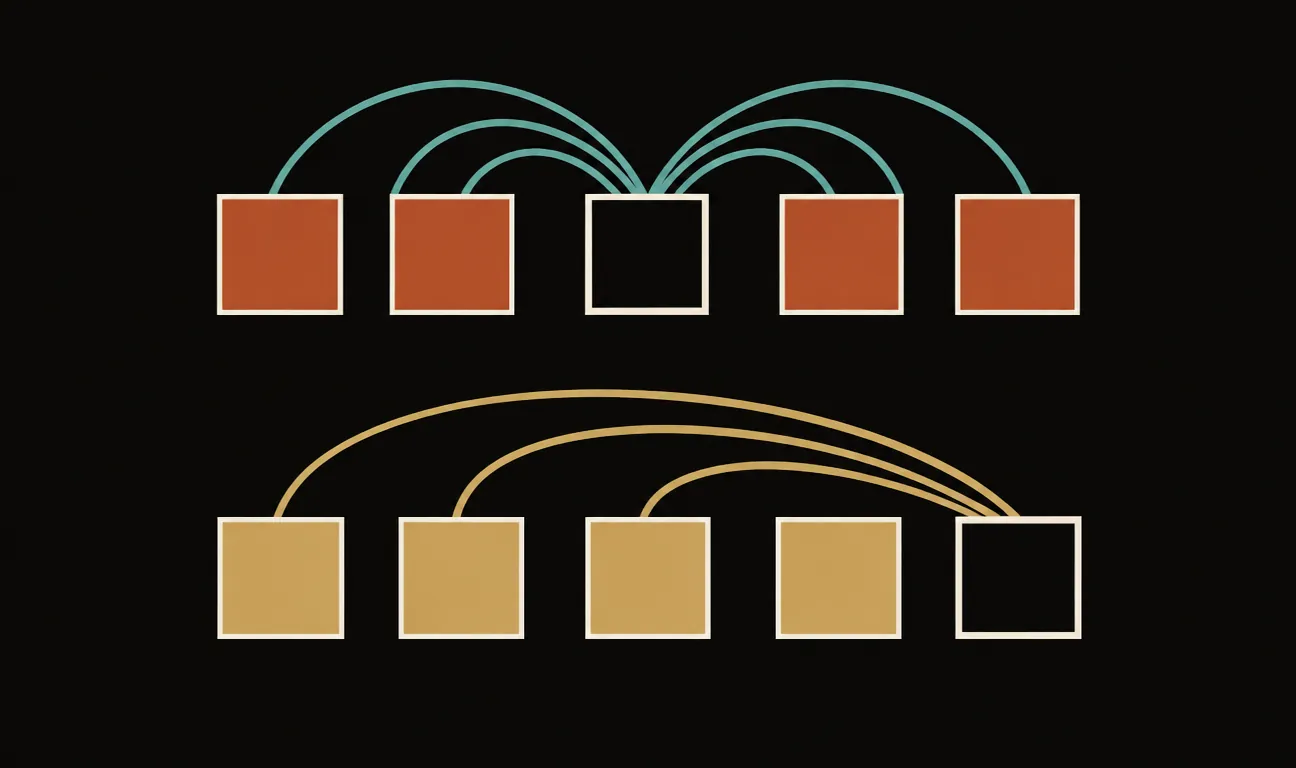
BERT e GPT sono nati staccando le due metà. BERT (Bidirectional Encoder Representations from Transformers) prende l’encoder: ogni parola può «guardare» tutte le altre, sia quelle che la precedono sia quelle che la seguono. GPT (Generative Pre-trained Transformer) prende il decoder: ogni parola può guardare solo quelle che la precedono, perché il suo mestiere è indovinare la prossima.
Un’analogia utile: BERT è un lettore che ha il libro intero davanti e può sfogliarlo avanti e indietro per capire un passaggio ambiguo. GPT è uno scrittore che sta componendo il libro riga per riga: conosce tutto quello che ha già scritto, ma non può sbirciare quello che deve ancora venire, per il semplice motivo che non esiste ancora.
Due modi di allenarsi
La differenza architetturale si riflette nel compito di addestramento. BERT impara con il masked language modeling: si prende una frase, si nasconde a caso il 15% circa delle parole con un segnaposto [MASK], e il modello deve ricostruirle. Per indovinare «Il gatto dorme sul [MASK] della cucina» servono indizi da entrambi i lati: è la bidirezionalità messa al lavoro.
GPT impara con il compito più vecchio della linguistica computazionale: prevedere la parola successiva. Data la sequenza «Il gatto dorme sul», produrre una distribuzione di probabilità sulla parola che segue. Sembra un obiettivo più povero, ma ha una proprietà preziosa: ogni testo esistente è un esempio di addestramento già pronto, senza alcuna etichettatura, e il modello che ne esce sa produrre testo, non solo analizzarlo.
BERT riempie i buchi di una frase che esiste già. GPT scrive la frase che ancora non esiste. Tutto il resto è conseguenza.
Lo schema in una figura
Encoder contro decoder: in BERT l’attenzione fluisce in entrambe le direzioni per ricostruire il token mascherato; in GPT solo verso sinistra, perché il token da produrre non esiste ancora.
Capire: dove BERT ha dominato
Per anni BERT e i suoi discendenti (RoBERTa, ALBERT, DeBERTa, e per l’italiano modelli come UmBERTo o GilBERTo) sono stati la scelta di default per i compiti di comprensione: classificare il sentiment di una recensione, riconoscere entità in un contratto, decidere se due frasi si contraddicono, trovare il passaggio di un documento che risponde a una domanda.
Il motivo è pratico. Se il compito è etichettare un testo che hai già davanti, la bidirezionalità è un vantaggio strutturale: ogni parola viene interpretata alla luce dell’intera frase. In più, i modelli in stile BERT sono tipicamente piccoli — da poche decine a qualche centinaio di milioni di parametri — quindi economici da mettere a punto e da servire in produzione, anche su hardware modesto.
Il prezzo è che BERT non genera. Non c’è un modo naturale di chiedergli di riassumere un articolo o rispondere a una mail: la sua uscita è una rappresentazione, non un testo.
Generare: la scommessa lunga di GPT
La linea GPT ha fatto la scommessa inversa: un solo obiettivo (la parola successiva), scalato in modo aggressivo su dati e parametri. La scommessa era che, per prevedere bene il seguito di qualunque testo, un modello dovesse implicitamente imparare grammatica, fatti, stili e frammenti di ragionamento. Con GPT-2 e soprattutto GPT-3 è emerso un comportamento nuovo: il modello svolgeva compiti descritti nel prompt senza alcun addestramento specifico, il cosiddetto apprendimento in-context.
È il punto in cui i due paradigmi divergono davvero. Con BERT, ogni nuovo compito richiede un fine-tuning: dati etichettati, addestramento, una copia del modello per compito. Con un modello generativo abbastanza grande, molti compiti si specificano a parole, nel prompt. La classificazione stessa si può riformulare come generazione: «Questa recensione è positiva o negativa? Rispondi con una parola.»
Chi ha vinto? Dipende dalla domanda
Sarebbe comodo chiudere con «ha vinto GPT», e nel racconto pubblico è andata così: i modelli che usiamo oggi come assistenti — la famiglia GPT, Claude, Gemini, Llama — sono tutti decoder-only. Ma la risposta onesta è meno netta.
- Per generare (chatbot, riassunti, traduzione, codice) i decoder autoregressivi hanno vinto senza appello.
- Per rappresentare, gli encoder bidirezionali restano centrali: i modelli di embedding che alimentano la ricerca semantica e i sistemi RAG discendono concettualmente da BERT, e proprio i sistemi RAG accoppiano di fatto un «cervello BERT» per trovare i documenti e un «cervello GPT» per scrivere la risposta.
- Per compiti di classificazione ad alto volume — moderazione, smistamento ticket, estrazione di campi — un BERT fine-tuned da 100 milioni di parametri è spesso più preciso, più veloce e ordini di grandezza più economico di una chiamata a un LLM.
Perché ti riguarda
Se lavori con la NLP, questa biforcazione è una decisione di progetto che incontri di continuo. La domanda giusta non è «quale modello è più potente» ma «il mio problema è capire o generare?«. Se devi etichettare, estrarre o cercare, un encoder piccolo e specializzato è quasi sempre la scelta più sensata dal punto di vista di costi, latenza e controllo. Se devi produrre testo, o se il compito cambia ogni settimana e non hai dati etichettati, il decoder generalista vince. E se stai costruendo un sistema RAG, stai già usando entrambe le scuole insieme, che tu ci abbia pensato o no: saperle distinguere ti aiuta a capire quale delle due metà sta sbagliando quando qualcosa non funziona.
I commenti sono riservati agli iscritti.
Accedi per commentare