
«Il cane morde l’uomo» e «l’uomo morde il cane» contengono esattamente le stesse parole. Per un transformer senza correttivi, sono la stessa frase. Non è un difetto marginale: è una conseguenza diretta della scelta architetturale che ha reso il transformer vincente. L’attention elabora tutti i token in parallelo e confronta ciascuno con tutti gli altri in modo simmetrico, senza alcuna nozione di «prima» e «dopo». La velocità del parallelismo si paga con la cecità all’ordine. Il positional encoding è il modo — sorprendentemente elegante — in cui l’ordine rientra dalla finestra.
Encoder e decoder pezzo per pezzo, positional encoding e feed-forward network sono nel libro.
Il problema: un sacchetto di parole
Le reti ricorrenti, che dominavano il linguaggio naturale prima del 2017, avevano l’ordine gratis: leggevano una parola alla volta, da sinistra a destra, e la posizione era implicita nel momento in cui ogni parola veniva processata. Il transformer rinuncia a questa lettura sequenziale proprio per poter elaborare tutto insieme. Ma così i token arrivano al meccanismo di attention come biglie in un sacchetto: il modello sa quali parole ci sono, non dove sono.
La soluzione concettuale è semplice: se l’architettura non vede la posizione, scriviamola dentro i dati. Ogni token entra nel modello come un vettore di numeri, il suo embedding; basta sommare a quel vettore un secondo vettore che codifica la posizione. Il token «cane» in posizione 2 e il token «cane» in posizione 7 diventano così vettori leggermente diversi, e l’attention può imparare a usare quella differenza.
Perché non basta numerare le posizioni
La prima idea che viene in mente — aggiungere semplicemente il numero della posizione: 1, 2, 3, … — funziona male. I valori crescono senza limite: alla posizione 5000 il numero aggiunto è enorme rispetto ai valori tipici di un embedding, che stanno intorno allo zero, e finisce per schiacciare il contenuto semantico del token. Normalizzare tra 0 e 1 non risolve: il valore assegnato a «posizione 10» dipenderebbe dalla lunghezza della frase, e la distanza tra due posizioni non avrebbe più un significato stabile.
Servono proprietà precise: valori limitati, una codifica unica per ogni posizione, e — soprattutto — una struttura che renda facile per il modello ragionare sulle distanze relative («questa parola è tre posizioni prima di quella»), perché è questo che conta nella sintassi, molto più della posizione assoluta.
La soluzione del 2017: onde sinusoidali
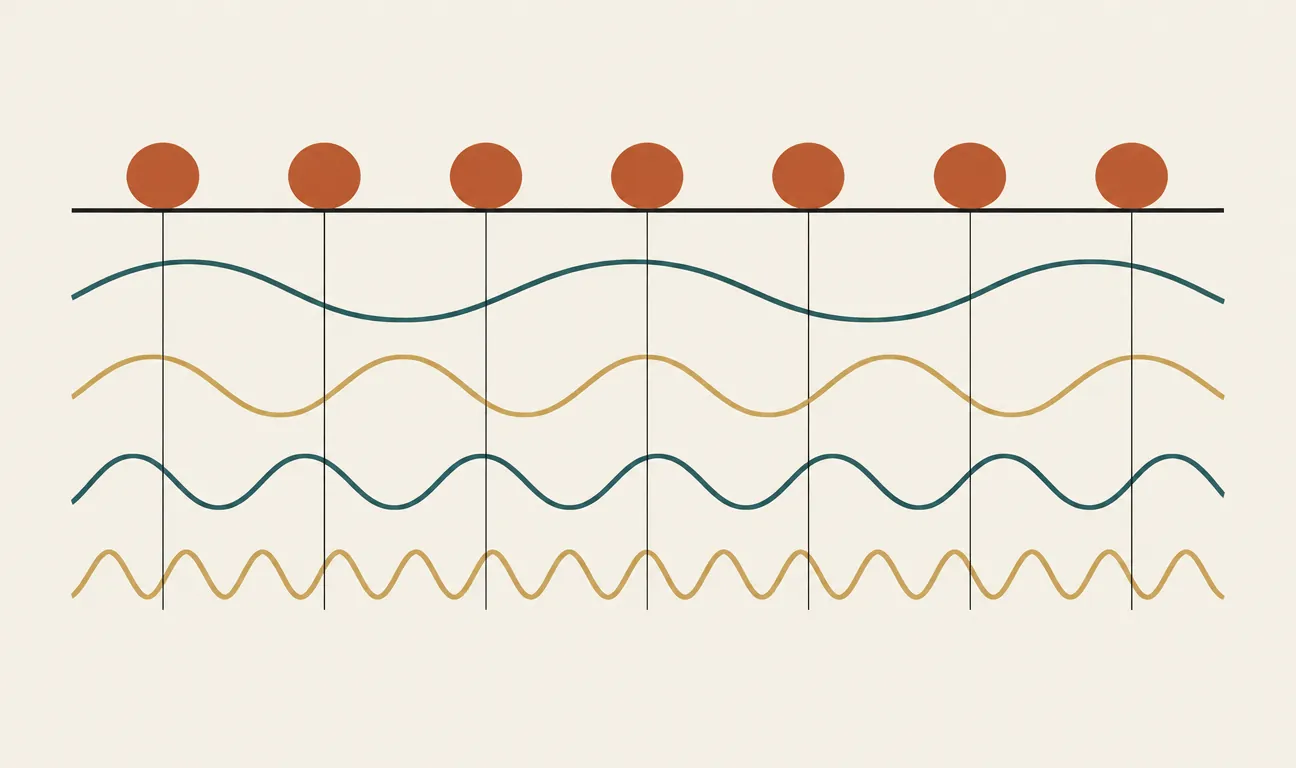
Gli autori di «Attention Is All You Need» propongono una costruzione che a prima vista sembra bizzarra: ogni posizione viene codificata da un vettore le cui componenti sono seni e coseni a frequenze diverse. Le prime componenti oscillano velocemente, completando un ciclo ogni poche posizioni; le ultime oscillano lentissime, con periodi di decine di migliaia di posizioni.
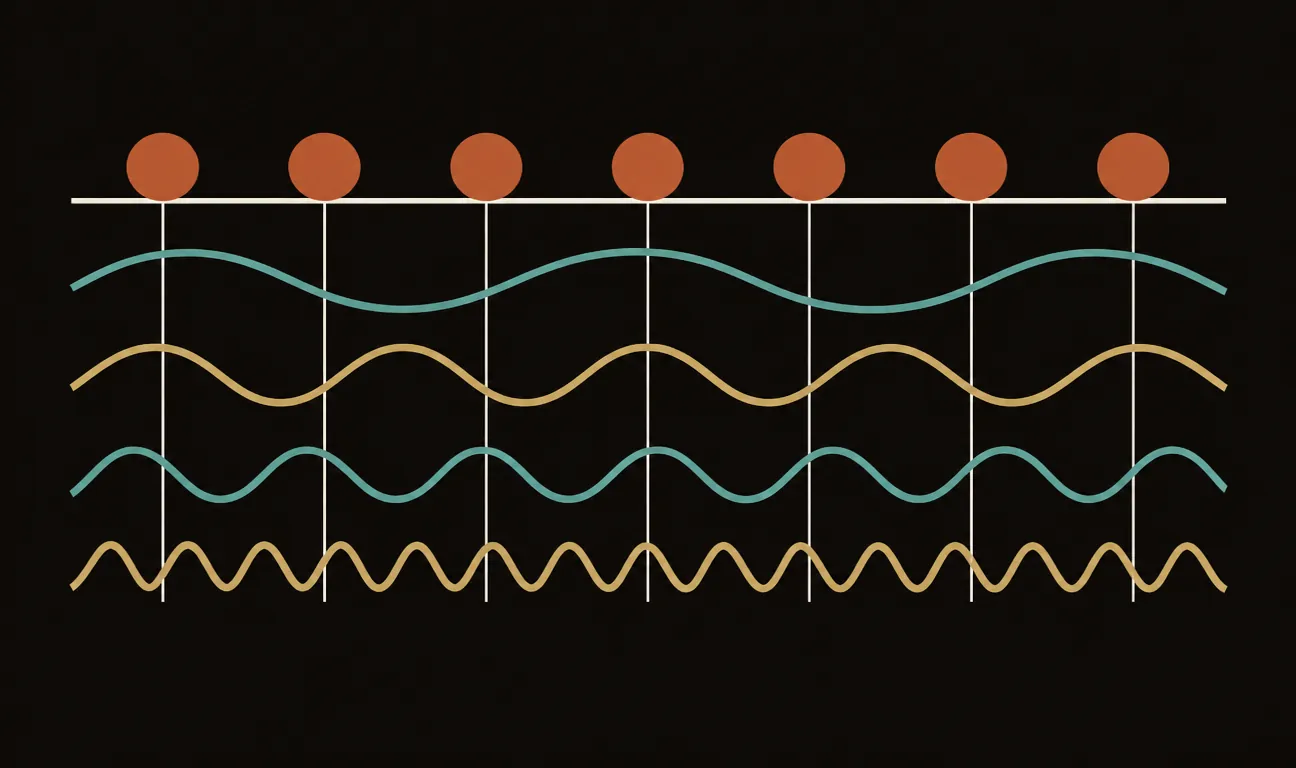
L’analogia giusta è un orologio con molte lancette. La lancetta dei secondi gira in fretta e distingue bene istanti vicini; quella delle ore gira lenta e colloca il momento nella scala grande della giornata. Nessuna lancetta da sola identifica l’istante, ma la combinazione di tutte sì — e due istanti vicini hanno lancette in posizioni simili, due istanti lontani no. Le sinusoidi a frequenze diverse fanno esattamente questo con le posizioni dei token: ogni posizione riceve una «firma» unica, e posizioni vicine hanno firme simili.
Nessuna lancetta da sola identifica l’istante, ma la combinazione di tutte sì. Le sinusoidi fanno lo stesso con le posizioni dei token.
La scelta di seni e coseni ha un vantaggio matematico preciso: la codifica di una posizione spostata di k passi si ottiene dalla codifica originale con una trasformazione lineare che dipende solo da k, non dalla posizione di partenza. Detto in modo pratico: per il modello, imparare a riconoscere «tre posizioni più avanti» è un’unica operazione, valida ovunque nella frase. È la proprietà che rende le distanze relative facili da usare.
Tre delle molte sinusoidi del positional encoding: frequenze alte (terracotta), medie (teal) e basse (ocra). Leggendo i valori delle onde in corrispondenza di una posizione — i punti sulle linee tratteggiate — si ottiene la sua firma, unica come la combinazione delle lancette di un orologio.
L’alternativa: posizioni imparate, e poi le rotazioni
Le sinusoidi fisse non sono l’unica strada. Molti modelli della generazione successiva — BERT e GPT-2 tra questi — usano embedding posizionali appresi: un vettore per ogni posizione, inizializzato a caso e addestrato insieme al resto. Funziona bene, ma con un limite strutturale: se il modello è stato addestrato su testi fino a 1024 token, la posizione 1025 semplicemente non esiste nel suo vocabolario posizionale.
La famiglia più diffusa oggi è un’evoluzione dell’idea sinusoidale: RoPE, rotary position embedding. Invece di sommare la posizione all’embedding, RoPE la applica ruotando le query e le key dentro il meccanismo di attention, di un angolo proporzionale alla posizione. Il risultato è che il prodotto scalare tra due token dipende solo dalla loro distanza relativa — l’informazione che serve davvero — e la codifica si estende con più grazia a contesti lunghi. Gran parte dei modelli aperti recenti usa varianti di questo schema, e molte tecniche per allungare la finestra di contesto sono, in sostanza, modi di riscalare quelle rotazioni.
Un dettaglio che non è un dettaglio
Il positional encoding sembra una nota a piè di pagina dell’architettura, ma decide comportamenti che si vedono a occhio nudo. La difficoltà dei modelli nel gestire documenti molto lunghi, il degrado delle prestazioni quando l’informazione rilevante sta a metà di un contesto lungo, la possibilità stessa di estendere la finestra di contesto di un modello già addestrato: sono tutte questioni che passano da come le posizioni sono codificate. Quando un modello viene aggiornato «con contesto esteso a 128k token», il lavoro sotto il cofano riguarda quasi sempre la geometria di queste codifiche, non l’attention in sé.
C’è anche una lezione di metodo, e riguarda chiunque progetti sistemi. Il transformer ha barattato una proprietà (l’ordine sequenziale) per un’altra (il parallelismo), e poi ha reintrodotto la proprietà perduta come informazione nei dati invece che come vincolo nell’architettura. È una mossa ricorrente nell’ingegneria del machine learning: quando un vincolo strutturale costa troppo, si prova a trasformarlo in un segnale che il modello può imparare a usare. Il positional encoding è l’esempio più pulito di questa strategia — e il motivo per cui il vostro assistente linguistico sa che il cane morde l’uomo, e non il contrario.
I commenti sono riservati agli iscritti.
Accedi per commentare