
Un radiologo non impara a leggere una TAC partendo da zero: prima passa vent’anni a imparare a leggere, scrivere, studiare anatomia e fisiologia, e solo alla fine si specializza. Nessuno propone di addestrare radiologi facendogli vedere soltanto TAC dalla nascita. Eppure per anni la NLP ha funzionato così: per ogni compito — sentiment, traduzione, estrazione di entità — si addestrava un modello dedicato, da zero, sui soli dati di quel compito. La svolta è arrivata quando il campo ha adottato lo schema del radiologo: prima una formazione generale enorme, poi una specializzazione breve. Si chiamano pre-training e fine-tuning, e sono le due fasi su cui poggia praticamente ogni modello linguistico in produzione oggi.
Instruction tuning, LoRA, RLHF e DPO: tutto quello che succede dopo il pre-addestramento è nel libro.
Leggi «Dopo il pre-addestramento: istruzioni, preferenze, allineamento» nel libro →
Fase uno: imparare la lingua, non il compito
Il pre-training è la fase generalista. Si prende un modello con i pesi inizializzati a caso e lo si addestra su una quantità enorme di testo non etichettato — pagine web, libri, codice — con un obiettivo autosupervisionato: il testo stesso fornisce la risposta corretta. Per i modelli in stile GPT l’obiettivo è prevedere la parola successiva; per quelli in stile BERT, ricostruire parole mascherate. In entrambi i casi non serve nessun essere umano che etichetti: ogni frase esistente è un esercizio con soluzione inclusa.
È la fase costosa. Si parla di settimane o mesi su cluster di GPU, con costi che per i modelli più grandi si misurano in milioni di euro. Ma è un costo che si paga una volta sola: il risultato è un modello «base» che ha assorbito grammatica, lessico, fatti, registri stilistici e regolarità del mondo, senza essere specializzato in niente.
Fase due: imparare il mestiere
Il fine-tuning riprende quel modello base e continua l’addestramento su un dataset piccolo e mirato: qualche migliaio di recensioni etichettate, qualche decina di migliaia di coppie domanda-risposta, esempi di dialogo scritti da annotatori. I pesi non ripartono da zero: partono da quelli del pre-training e si spostano poco, quanto basta per orientare le competenze generali verso il compito specifico.
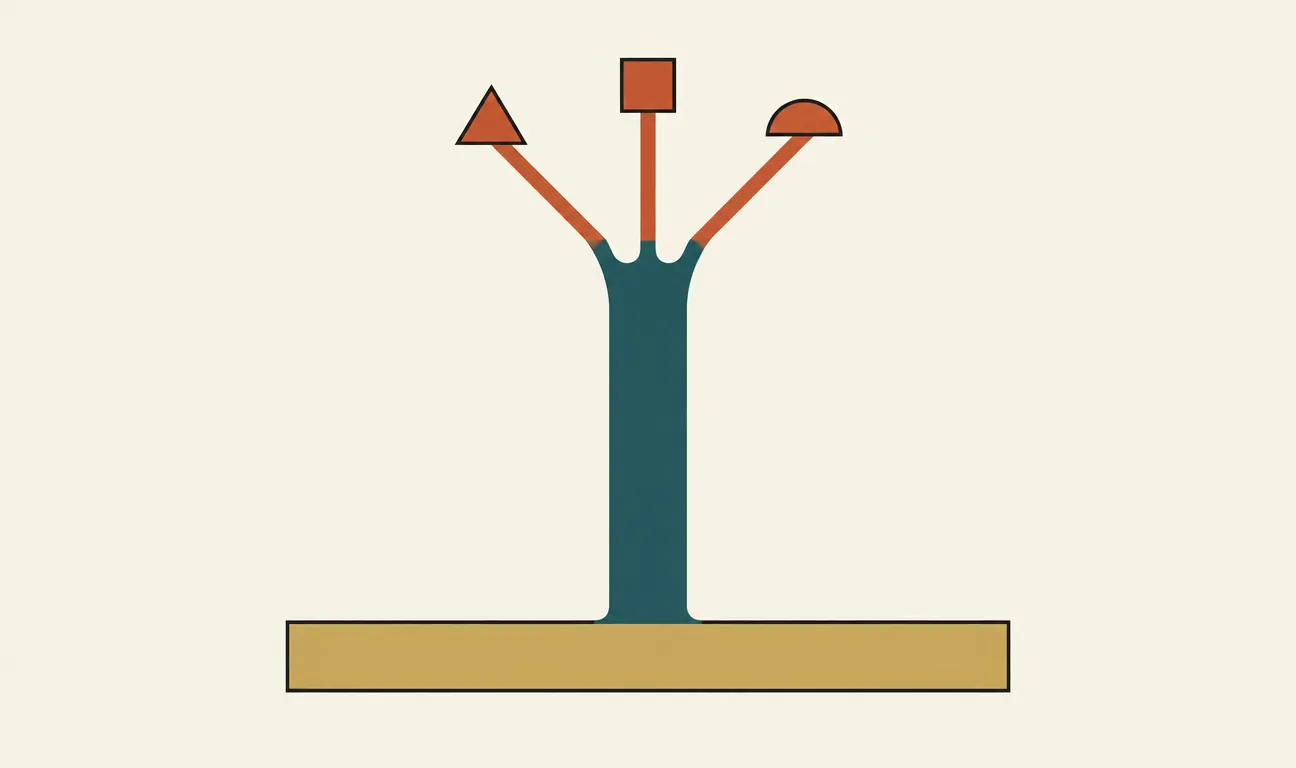
La sproporzione tra le due fasi è il punto chiave. Il pre-training consuma miliardi o migliaia di miliardi di parole; il fine-tuning può bastare con qualche migliaio di esempi, perché non deve insegnare la lingua ma solo il mestiere. È la stessa ragione per cui un corso di specializzazione dura mesi e non vent’anni: il grosso della conoscenza c’è già.
Il pre-training si paga una volta e insegna tutto in generale. Il fine-tuning si paga ogni volta e insegna una cosa in particolare.
La pipeline in una figura
La pipeline a due fasi: un pre-training generalista e costoso produce il modello base; da lì, tanti fine-tuning piccoli ed economici producono i modelli specializzati.
Perché funziona: il transfer learning
Il principio sotto la pipeline si chiama transfer learning: le competenze apprese su un compito si trasferiscono a compiti diversi. Nel linguaggio il trasferimento è particolarmente efficace perché quasi ogni compito testuale poggia sulle stesse fondamenta — sapere che «non male» è un giudizio positivo, che «Roma» può essere una città o una squadra, che un pronome si riferisce a qualcosa detto prima. Il pre-training costruisce queste fondamenta una volta per tutte; il fine-tuning ci appoggia sopra un piano in più.
La conferma empirica è arrivata a cascata: prima con i word embeddings (word2vec, GloVe), che trasferivano solo il primo strato; poi con ULMFiT e BERT nel 2018, che hanno mostrato che trasferire l’intero modello pre-addestrato batteva sistematicamente i modelli addestrati da zero, spesso con cento volte meno dati etichettati.
Le due scuole oggi: aggiornare i pesi o scrivere il prompt
Il titolo parla di due scuole, e oggi la divergenza è visibile soprattutto nel modo in cui si fa la seconda fase. La scuola classica specializza aggiornando i pesi: fine-tuning completo o, più spesso, tecniche efficienti come LoRA, che congelano il modello e addestrano solo piccole matrici aggiuntive, riducendo drasticamente memoria e costi. È la strada giusta quando hai dati abbondanti, un compito stabile e requisiti stretti su latenza o formato dell’output.
La scuola nuova, resa possibile dai modelli generativi di grandi dimensioni, specializza senza toccare i pesi: descrive il compito nel prompt, magari con qualche esempio (few-shot), o fornisce contesto recuperato da documenti (RAG). Nessun addestramento, iterazione immediata, un solo modello per mille compiti. Il prezzo è una dipendenza continua da un modello grande e costoso a ogni chiamata, e un controllo più fragile sul comportamento.
C’è poi un caso speciale che ha cambiato tutto: i modelli di chat che usiamo ogni giorno sono a loro volta il prodotto di un fine-tuning. Un modello base sa solo continuare il testo; è la fase di instruction tuning (più le tecniche di allineamento come RLHF) a trasformarlo in un assistente che risponde alle domande invece di completarle. In altre parole, anche chi «non fa fine-tuning» sta usando il fine-tuning di qualcun altro.
I limiti che è onesto nominare
La pipeline a due fasi non è gratis. Il fine-tuning può causare catastrophic forgetting: specializzando il modello su un dominio, si degradano competenze generali che sembravano acquisite. Può cucire il modello sui difetti del dataset di specializzazione, ereditandone distorsioni e buchi. E la conoscenza del pre-training ha una data di scadenza: il modello sa il mondo com’era nei suoi dati, e nessun fine-tuning leggero lo tiene aggiornato in modo affidabile — per quello servono il retrieval o un nuovo pre-training.
Perché ti riguarda
Se costruisci qualcosa con i modelli linguistici, la decisione «fine-tuning o prompt» è probabilmente la scelta tecnica con il maggiore impatto su costi e manutenzione del tuo progetto. Una regola pratica onesta: parti sempre dal prompt, perché iterare costa minuti; passa al fine-tuning solo quando hai almeno qualche migliaio di esempi buoni, un compito che non cambia ogni settimana e un motivo misurabile — precisione, latenza, costo per chiamata — per cui il prompt non basta. E ricorda la sproporzione delle due fasi: il valore che usi gratis o quasi sta nel pre-training, pagato una volta da qualcun altro. Il tuo lavoro, quasi sempre, è solo l’ultima e più piccola delle due fasi.
I commenti sono riservati agli iscritti.
Accedi per commentare