
Durante l’addestramento, un modello linguistico legge la frase «il gatto è salito sul» e deve indovinare la parola successiva. Non risponde con una parola sola: risponde con una distribuzione di probabilità sull’intero vocabolario — 30% «tetto», 20% «divano», 12% «tavolo», e giù fino a probabilità microscopiche per «fotosintesi». Poi arriva la verità: nel testo originale c’era «tetto». Quanto deve essere punito il modello?
La sorpresa di un evento, l’entropia, la cross-entropia e la divergenza KL — e il ponte con l’apprendimento — sono nel libro.
Leggi «Teoria dell’informazione: misurare la sorpresa» nel libro →
La risposta che regge tutto il deep learning moderno è: −log q(tetto), dove q è la probabilità che il modello aveva assegnato alla parola giusta. Questa penalità si chiama cross-entropy, ed è la funzione di errore con cui sono stati addestrati praticamente tutti i modelli linguistici che usate. Vale la pena capirla davvero, perché insieme alla sua cugina — la KL divergence — è il vocabolario con cui si parla di «quanto un modello sbaglia».
Ripasso in due righe: la sorpresa media
Nell’articolo precedente di questa serie abbiamo visto l’entropia di Shannon: la sorpresa media di una sorgente, H(p) = −Σ p log p. Una moneta equa vale 1 bit a lancio, una truccata al 90% circa 0,47 bit. L’entropia è un fatto della sorgente: non dipende da chi la osserva.
Ma c’è un caso che l’entropia non copre: cosa succede se la realtà segue una distribuzione p, e voi — o il vostro modello — credete che segua un’altra distribuzione q? Quanto vi costa l’errore di prospettiva? È esattamente la situazione di un modello linguistico: la lingua vera ha la sua distribuzione, il modello ne ha una approssimata.
Cross-entropy: la sorpresa di chi ha il modello sbagliato
La cross-entropy è la sorpresa media che provate voi, con le vostre convinzioni q, quando gli eventi arrivano secondo la realtà p: H(p, q) = −Σ p(x) log q(x). Gli eventi accadono con le frequenze vere p, ma la sorpresa che pagate su ciascuno — −log q(x) — è calcolata con le probabilità che gli avevate assegnato voi.
L’analogia più concreta è un frasario per il paese sbagliato. Immaginate di andare a Napoli con un frasario ottimizzato per Helsinki: le frasi che vi servono di continuo («un caffè, grazie») stanno in fondo, in appendice, e ogni volta le cercate a lungo; le frasi in evidenza non le usate mai. Il tempo medio di ricerca è la vostra cross-entropy: dipende sia da quali frasi servono davvero (p, la realtà di Napoli) sia da come il frasario è organizzato (q, le aspettative di chi l’ha compilato).
Due proprietà seguono subito. Primo: la cross-entropy non può mai scendere sotto l’entropia vera, H(p, q) ≥ H(p). Nessun frasario batte quello compilato da chi conosce le frequenze esatte. Secondo: l’uguaglianza vale solo quando q = p. Il modello perfetto non ha sorpresa zero — ha la sorpresa minima possibile, quella intrinseca della sorgente. Anche il miglior modello del mondo non può prevedere l’imprevedibile.
KL divergence: il prezzo dell’errore, isolato
Se la cross-entropy è «sorpresa intrinseca più costo dell’errore», viene naturale isolare il secondo termine. La divergenza di Kullback-Leibler è esattamente questo: KL(p ∥ q) = H(p, q) − H(p). È il costo aggiuntivo, in bit, che pagate per aver creduto in q quando la verità era p. Vale zero se e solo se le due distribuzioni coincidono, ed è sempre positiva altrimenti.
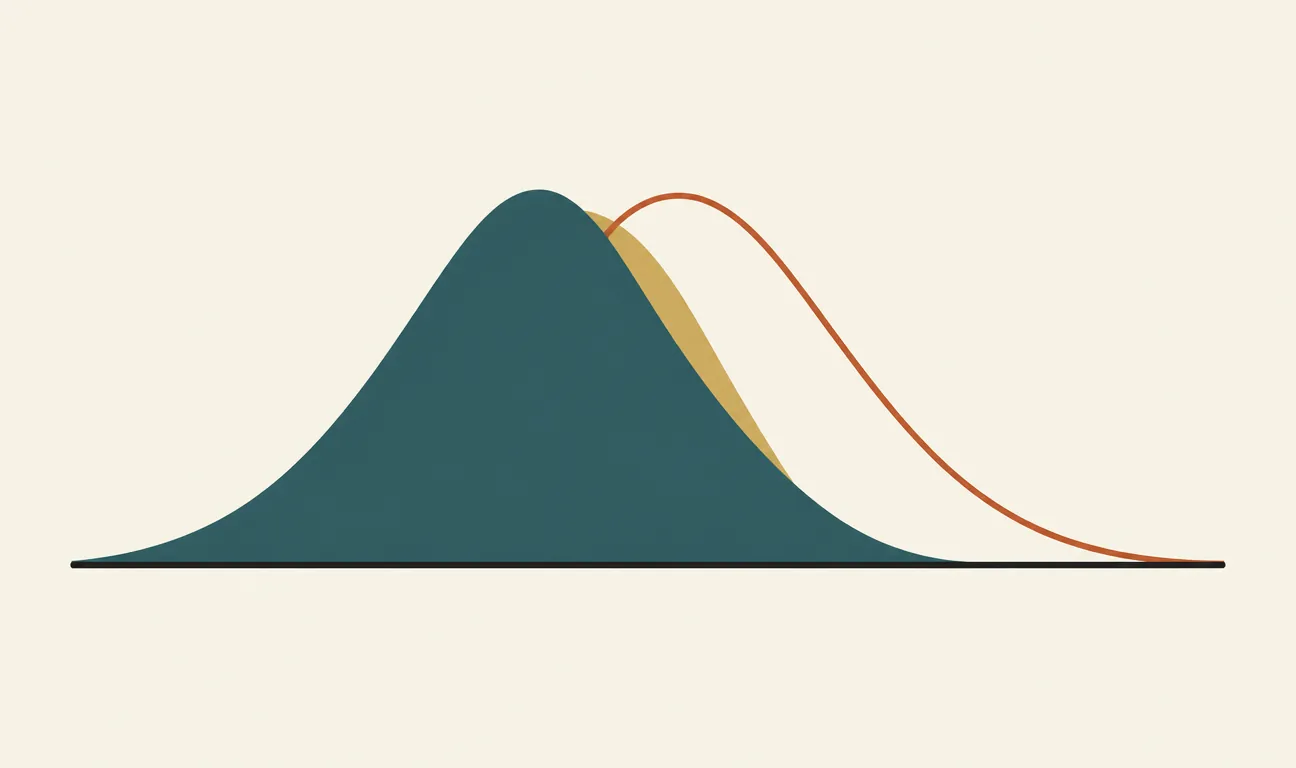
La realtà p (teal) e il modello q (terracotta) a confronto sullo stesso vocabolario. La KL divergence misura quanto costa, in bit di sorpresa extra, usare q al posto di p — e punisce durissimo le zone dove p esiste ma q assegna probabilità quasi nulla.
Attenzione a una trappola da colloquio tecnico: la KL non è una distanza. Non è simmetrica — KL(p ∥ q) e KL(q ∥ p) in generale differiscono — e non rispetta la disuguaglianza triangolare. E l’asimmetria non è un difetto: dice qualcosa. Minimizzare KL(p ∥ q) spinge il modello a coprire tutto ciò che la realtà può fare (se p è positiva dove q è quasi zero, la penalità esplode); minimizzare KL(q ∥ p) spinge invece il modello a concentrarsi su una zona sicura e ignorare il resto. Due obiettivi diversi, due comportamenti diversi.
La cross-entropy non punisce il modello per aver sbagliato parola: lo punisce per quanto era sicuro di sbagliarla.
Dalla teoria alla loss: cosa minimizza davvero un LLM
Torniamo al gatto sul tetto. Durante l’addestramento, per ogni posizione nel testo la «realtà» è una distribuzione degenere: tutta la probabilità sulla parola che c’era davvero, zero sulle altre (il cosiddetto one-hot). Con questa p, la somma della cross-entropy collassa in un solo termine: −log q(parola giusta). Ecco perché la loss ha quella forma così semplice.
Ed ecco perché è una penalità intelligente. Se il modello dava alla parola giusta il 90%, paga −log₂ 0,9 ≈ 0,15 bit: quasi niente. Se le dava l’1%, paga circa 6,6 bit. Se le dava lo 0,0001%, paga circa 20 bit. La punizione cresce senza limite man mano che la sicurezza mal riposta aumenta: sbagliare con arroganza costa enormemente di più che sbagliare con prudenza. È lo stesso motivo per cui questa loss scoraggia i modelli dal dire «impossibile» — assegnare probabilità zero a qualcosa che poi accade costa, letteralmente, infinito.
Mediata su miliardi di posizioni, la cross-entropy per token è il numero che scende durante il pretraining, quello delle celebri curve di loss. E poiché la realtà p è fissa (i testi sono quelli), minimizzare la cross-entropy equivale esattamente a minimizzare KL(p ∥ q): avvicinare la distribuzione del modello a quella della lingua. La perplexity riportata nei paper è solo l’esponenziale di questa loss: una cross-entropy di 3 bit per token equivale a una perplexity di 8, come se il modello esitasse ogni volta tra 8 alternative equiprobabili.
Dove la incontrerete ancora
Una volta imparata a riconoscerla, questa coppia di concetti spunta ovunque. Nella classificazione di immagini, la loss è la stessa cross-entropy, solo con dieci classi invece di cinquantamila parole. Nel fine-tuning con RLHF, un termine di KL divergence tiene il modello aggiornato vicino a quello di partenza, per impedirgli di stravolgersi pur di massimizzare la ricompensa. Nella distillazione, lo studente minimizza la KL rispetto alle distribuzioni (non solo alle risposte) del maestro. Nei variational autoencoder, la KL regolarizza lo spazio latente.
Perché vi riguarda
Se leggete un paper e trovate «loss 2.7» o «perplexity 15», adesso sapete cosa significa: quanti bit di sorpresa il modello paga in media su ogni parola, quanto il suo frasario interno è ancora organizzato per la città sbagliata. E se addestrate modelli, anche piccoli, la lezione operativa è una: la cross-entropy misura la qualità delle probabilità, non solo delle risposte. Un modello che sbaglia sapendo di poter sbagliare è, per questa metrica e per chi lo usa, molto migliore di uno che sbaglia con sicurezza assoluta. Non è solo matematica: è una definizione di onestà che vale la pena esigere, dai modelli e non solo.
I commenti sono riservati agli iscritti.
Accedi per commentare