
Alla vigilia dell’esame, uno studente si procura i compiti degli ultimi cinque anni e impara a memoria ogni risposta, parola per parola. Sulle simulazioni fatte con quei compiti è impeccabile: cento su cento, sempre. Poi arriva l’esame vero, il professore riformula le stesse domande con parole diverse, e lo studente crolla. Non aveva capito la materia: aveva fotografato le risposte.
Overfitting e underfitting, il compromesso bias-varianza, train/validation/test e la cross-validation: nel libro, con i conti.
Leggi «Overfitting, bias-varianza e validazione» nel libro →
I modelli di machine learning commettono esattamente questo errore, così spesso che il fenomeno ha un nome tecnico: overfitting, adattamento eccessivo. È probabilmente il singolo problema più comune di tutta la disciplina, e capire come funziona è il modo più rapido per smettere di farsi ingannare da metriche che sembrano ottime e non lo sono.
Due punteggi che raccontano storie diverse
Quando si addestra un modello, i dati vengono divisi almeno in due gruppi: quelli di training, su cui il modello impara, e quelli di test, che il modello non vede mai durante l’addestramento. L’overfitting si manifesta come una forbice tra i due punteggi: errore bassissimo sui dati di training, errore molto più alto sui dati nuovi.
La causa è quasi sempre la stessa: il modello ha abbastanza flessibilità da adattarsi non solo al segnale — la regolarità vera che vogliamo catturare — ma anche al rumore, cioè alle fluttuazioni casuali presenti in quel particolare campione di dati. È la differenza tra imparare una melodia e imparare anche il fruscio del vinile su cui l’abbiamo ascoltata: il fruscio è specifico di quella copia, e su un disco nuovo non ci sarà.
La curva che insegue ogni punto
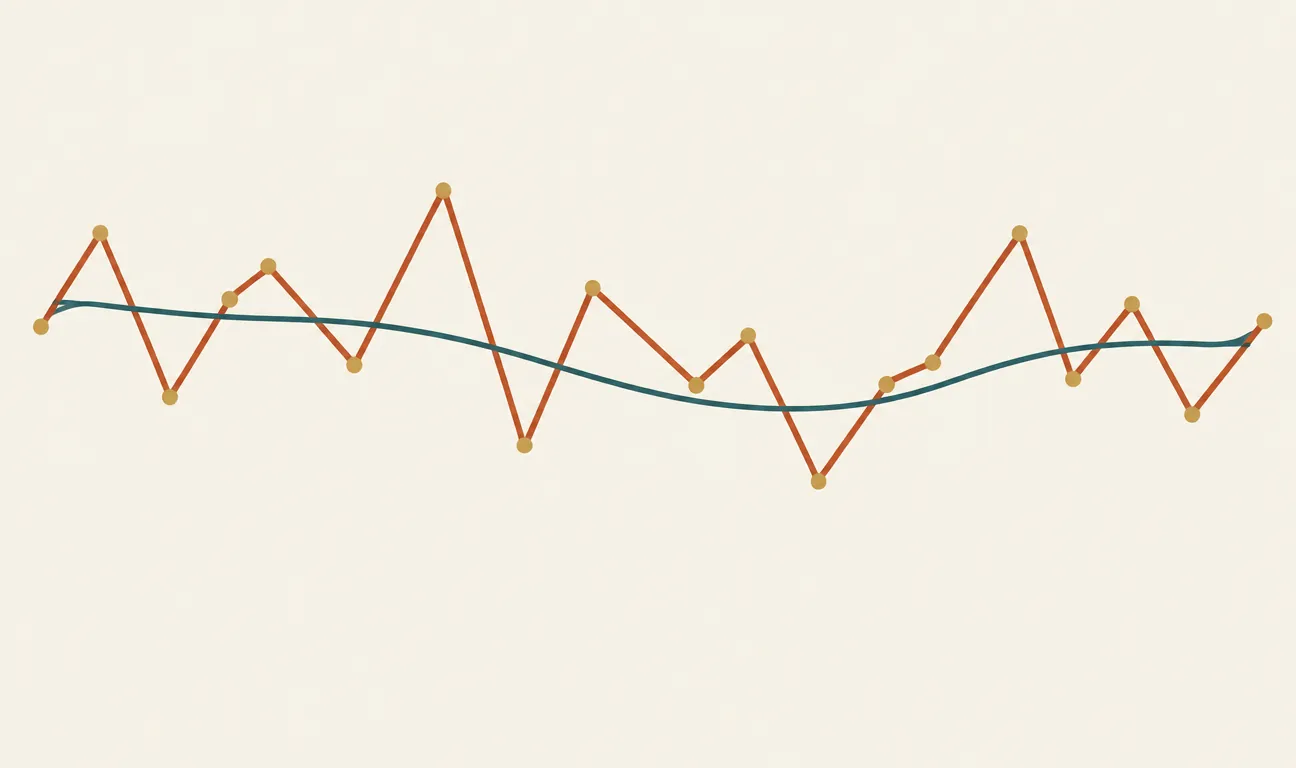
Il modo più chiaro per vedere l’overfitting è un grafico. Immaginiamo dieci punti che seguono una tendenza semplice, con un po’ di rumore di misura. Possiamo adattarci due modelli: uno semplice, che disegna una curva dolce, e uno molto flessibile — per esempio un polinomio di grado alto — che passa esattamente per ogni punto.
Due modelli sugli stessi dieci punti: la curva teal sbaglia un po’ su ciascun punto ma coglie la struttura; la curva terracotta ha errore zero sul training set, ma tra un punto e l’altro oscilla inseguendo il rumore.
Sul training set il polinomio nervoso vince a mani basse: errore zero, la curva tocca ogni punto. Ma guardate cosa fa tra un punto e l’altro: oscilla, sale e scende senza motivo. Se arriva un dato nuovo, cadrà quasi certamente in una di quelle oscillazioni, e la previsione sarà peggiore di quella della curva dolce. È come un abito cucito addosso a una sola persona, in un giorno preciso, con tutte le pieghe e le asimmetrie di quel momento: perfetto per lei, inservibile per chiunque altro.
Perché succede: memoria che si spaccia per comprensione
L’overfitting nasce da uno squilibrio tra la capacità del modello e la quantità (e qualità) dei dati. Una rete neurale con milioni di parametri e mille esempi di training ha abbastanza spazio per memorizzarli letteralmente uno per uno, invece di essere costretta a trovare la regolarità che li accomuna. La compressione forzata è proprio ciò che produce generalizzazione: se il modello non può permettersi di ricordare tutto, deve trovare la regola.
Un modello che non sbaglia mai sui dati che ha già visto non è necessariamente intelligente: può essere solo una fotocopiatrice ben organizzata.
Il rumore aggrava le cose. In qualsiasi dataset reale ci sono errori di misura, etichette sbagliate, casi atipici. Un modello troppo flessibile impara anche quelli, come lo studente che memorizza pure il refuso presente nel compito dell’anno scorso. E lo ripeterà con convinzione.
Come si smaschera
La diagnosi standard usa un terzo insieme di dati, il validation set, controllato durante l’addestramento. All’inizio l’errore scende su entrambi gli insiemi: il modello sta imparando il segnale, che è comune a tutti i dati. A un certo punto, però, le due curve divergono: l’errore di training continua a scendere, quello di validazione si ferma e poi risale. Quel punto di divergenza è il momento in cui il modello ha finito di imparare la materia e ha cominciato a imparare il compito.
Due regole pratiche discendono da qui. Primo: non valutare mai un modello sugli stessi dati su cui è stato addestrato — è come far correggere l’esame allo studente stesso. Secondo: non usare il test set per scegliere gli iperparametri, altrimenti l’informazione del test «filtra» nelle scelte e la valutazione finale torna a essere ottimista. Quando i dati sono pochi, la cross-validation — ruotare più volte il ruolo di training e validazione — rende la stima più affidabile.
Le difese classiche
Contro l’overfitting esiste un intero arsenale, e quasi tutto si riduce a un’idea sola: limitare la libertà del modello, o dargli abbastanza dati da rendere la memorizzazione impossibile.
- Più dati. La difesa più efficace e la meno glamour. Con dieci volte più esempi, il rumore dei singoli punti si media e la scorciatoia della memoria smette di funzionare.
- Modelli più semplici. Meno parametri, alberi meno profondi, polinomi di grado più basso. La prima domanda non è «quale rete uso?» ma «quanta complessità mi serve davvero?».
- Regolarizzazione. Aggiungere alla funzione di costo una multa sui pesi grandi (la L2, in molti framework il parametro
weight_decay). È come il limite del bagaglio a mano: il modello può portarsi dietro solo ciò che è davvero essenziale. - Early stopping. Fermare l’addestramento quando l’errore di validazione smette di scendere, invece di continuare fino a memorizzare tutto.
- Dropout. Nelle reti neurali, spegnere a caso una frazione dei neuroni a ogni passo di training, così nessun neurone può specializzarsi nel ricordare un singolo esempio.
- Data augmentation. Creare varianti plausibili degli esempi esistenti — un’immagine ruotata o ritagliata resta la stessa immagine — per insegnare al modello quali dettagli sono irrilevanti.
Nessuna di queste tecniche è gratis: esagerando si cade nell’errore opposto, l’underfitting, il modello troppo rigido che non impara nemmeno il segnale. Trovare l’equilibrio tra i due è, in buona parte, il mestiere.
Perché ti riguarda
L’overfitting non è un problema esclusivo delle reti neurali: è un modo di sbagliare che riconosciamo ovunque, una volta che abbiamo il nome giusto. La teoria del complotto che spiega perfettamente ogni evento passato ma non azzecca una previsione è overfit. L’analisi finanziaria che «avrebbe guadagnato il 300% negli ultimi dieci anni» — costruita, ovviamente, guardando gli ultimi dieci anni — è overfit. Spiegare il passato è facile; il banco di prova è sempre il dato che non hai ancora visto.
E quando leggete che un modello «raggiunge il 99% di accuratezza», la domanda da fare è una sola: su quali dati? Se la risposta è «su quelli con cui è stato addestrato», quel numero non misura l’intelligenza del modello. Misura la sua memoria — e la memoria, da sola, non ha mai passato un esame vero.
I commenti sono riservati agli iscritti.
Accedi per commentare