
Un casinò perde continuamente. Ogni sera, a ogni tavolo di roulette, ci sono giocatori che vincono puntate singole: il banco paga, e paga spesso. Eppure nessun casinò è mai fallito per colpa della roulette. Su una singola puntata il margine del banco è minuscolo e il caso domina; su milioni di puntate, il caso si spegne e resta solo il margine. Non è fortuna, e non è nemmeno un trucco: è un teorema, dimostrato molto prima che esistessero i casinò moderni. Si chiama legge dei grandi numeri, ed è la stessa ragione per cui i modelli di machine learning hanno bisogno di così tanti dati.
Che cosa dice davvero
L’enunciato informale è semplice: se ripeti tante volte lo stesso esperimento casuale, in condizioni indipendenti e identiche, la media delle osservazioni si avvicina sempre di più al valore atteso — il valore «vero» che la distribuzione ha dentro di sé.
L’esempio classico è la moneta. Su 10 lanci, ottenere 7 teste (il 70%) non sorprende nessuno. Su 10.000 lanci, ottenere il 70% di teste con una moneta equa è talmente improbabile che concluderemmo, ragionevolmente, che la moneta è truccata. La frequenza osservata converge verso la probabilità vera: 50%. Non perché qualcuno la spinga lì, ma perché le fluttuazioni casuali, sommandosi in ogni direzione, si compensano quasi del tutto.
Le due condizioni scritte in corsivo sopra — indipendenti e identiche — non sono pignoleria da matematici. Se le osservazioni si influenzano a vicenda, o se la distribuzione cambia strada facendo, la garanzia salta. È il motivo per cui mille recensioni scritte dagli amici del ristoratore non valgono come mille recensioni di clienti qualsiasi.
Il caso non si corregge, si diluisce
Qui vive uno dei fraintendimenti più costosi della storia del gioco d’azzardo. Se alla roulette è uscito rosso cinque volte di fila, il nero non è «in ritardo»: la pallina non ha memoria, e la probabilità al sesto giro è identica a quella del primo. La legge dei grandi numeri non promette che il caso venga riequilibrato; promette che venga reso irrilevante.
Il caso non viene corretto: viene sommerso.
La distinzione è sottile ma cambia tutto. Se nei primi 100 lanci escono 60 teste, quell’eccesso di 10 teste non verrà «restituito» da una serie di croci compensative. Semplicemente, dopo un milione di lanci, 10 teste in più non spostano la media che di un millesimo di punto percentuale. È come una goccia d’inchiostro: in un bicchiere colora tutta l’acqua, in una piscina olimpionica sparisce. L’inchiostro c’è ancora — è solo diventato invisibile.
La tirannia della radice quadrata
La legge dice che la media converge; non dice quanto in fretta. La risposta la dà un risultato cugino (il teorema del limite centrale): l’errore tipico della media empirica si riduce in proporzione a 1/√n, dove n è il numero di osservazioni.
Quella radice quadrata è una tassa severa. Per dimezzare l’errore non bastano il doppio dei dati: ne servono quattro volte tanti. Per guadagnare una cifra decimale di precisione — errore dieci volte più piccolo — servono cento volte più osservazioni. La precisione si paga con un costo che cresce molto più in fretta del beneficio.
La stessa formula ha però un lato sorprendentemente generoso: l’errore dipende da n, non dalla dimensione della popolazione. È il segreto dei sondaggi: un campione ben scelto di circa mille persone dà un margine d’errore intorno ai tre punti percentuali, che si stia sondando un paese di dieci milioni di abitanti o di trecento. Quello che conta è quanti ne interroghi, non quanti ce ne sono in totale — a patto, di nuovo, che il campione sia davvero casuale.
La media che si calma
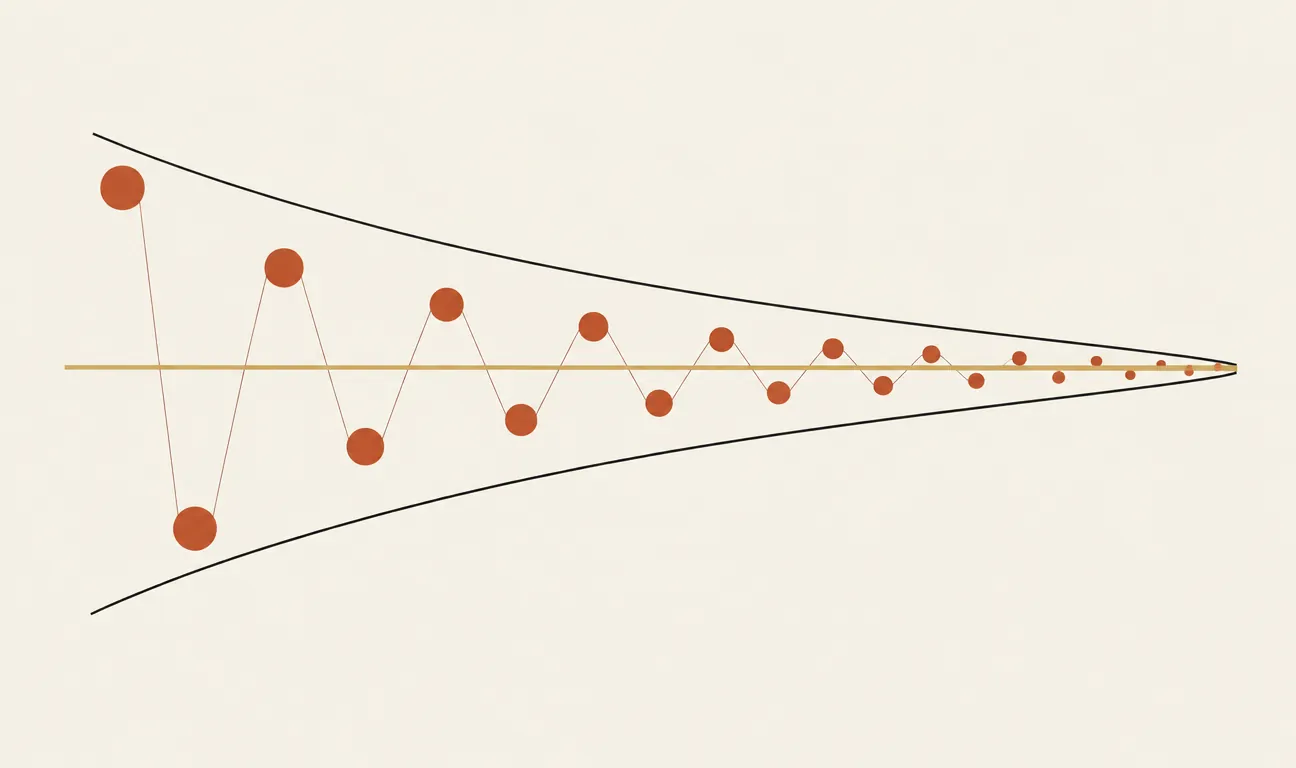
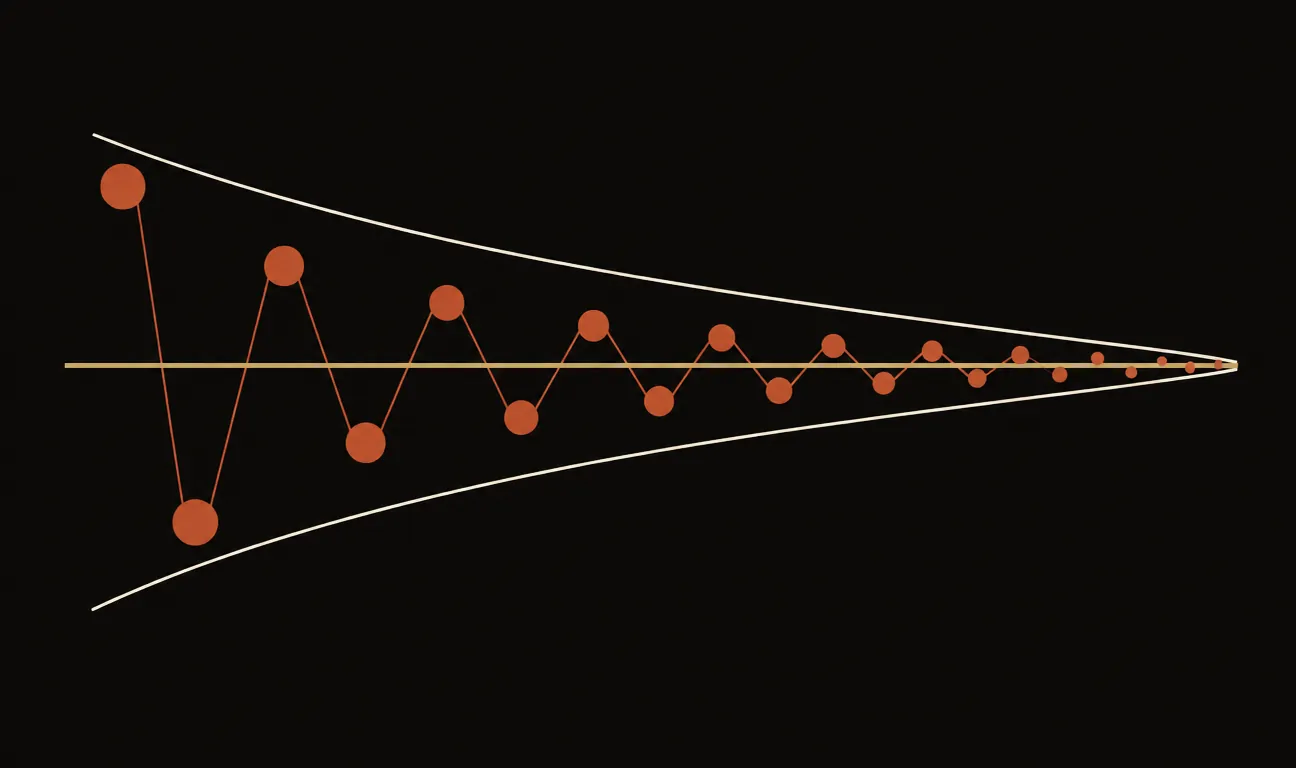
Il comportamento tipico si vede meglio di quanto si racconti: la media osservata parte selvaggia, con oscillazioni enormi quando le osservazioni sono poche, e si calma progressivamente man mano che i dati si accumulano, stringendosi attorno al valore vero.
La media empirica (terracotta) di una sequenza di lanci di moneta: caotica con poche osservazioni, sempre più stabile attorno al valore vero 0,5 (linea ocra). Le curve tratteggiate teal mostrano la fascia dell’errore tipico, che si restringe come 1/√n.
Ogni punto del grafico risponde alla domanda «qual è la media di tutto quello che ho visto finora?». All’inizio ogni nuovo dato può stravolgere la risposta; dopo mille osservazioni, il singolo dato è una goccia nella piscina.
Perché l’AI ha fame di dati
Il machine learning è costruito, quasi letteralmente, sopra questo teorema. Tre esempi concreti.
- L’addestramento è una media. La funzione di perdita che un modello minimizza è la media dell’errore sugli esempi di training. Vogliamo che quella media assomigli all’errore sul mondo reale — e la somiglianza è garantita proprio dalla legge dei grandi numeri, tanto meglio quanti più esempi abbiamo. Con pochi dati, il modello ottimizza una media rumorosa che può essere lontana dal vero: è una delle radici dell’overfitting.
- Anche il gradiente è una media. Ogni passo di discesa del gradiente stocastico stima la direzione giusta facendo la media su un batch di esempi. Batch piccoli, stime rumorose; è statistica applicata, ripetuta milioni di volte.
- La valutazione è una media. «Accuratezza del 92%» misurata su 100 esempi ha un’incertezza di diversi punti percentuali: il confronto tra due modelli che distano l’1% può essere puro rumore. Su 10.000 esempi, la stessa differenza inizia a significare qualcosa.
C’è poi la coda lunga. Se un evento capita una volta ogni diecimila casi — una frase rara, una condizione clinica atipica, un pedone vestito in modo insolito — servono milioni di esempi solo per vederlo qualche decina di volte. La fame di dati dei modelli moderni non è ingordigia: è la radice quadrata che presenta il conto, moltiplicata per tutte le situazioni rare che il modello deve comunque imparare.
Perché ti riguarda
La legge dei grandi numeri è il motivo per cui la statistica funziona, e la sua velocità di convergenza è il motivo per cui funziona più lentamente di quanto vorremmo. La conseguenza pratica sta in una domanda sola, da fare sempre: su quanti casi?
Il ristorante con cinque stelle e sei recensioni contro quello con quattro stelle e seimila. L’A/B test aziendale fermato dopo due giorni perché «la variante B sta vincendo». Il benchmark in cui un modello supera l’altro di un punto percentuale su duecento domande. In tutti questi casi, chi conosce la legge dei grandi numeri sa che una media calcolata su pochi dati non è un fatto: è un’oscillazione fotografata a metà del grafico qui sopra. Aspettare che la curva si calmi, o pretendere che lo abbia fatto, è la forma più semplice — e più trascurata — di onestà intellettuale con i numeri.
I commenti sono riservati agli iscritti.
Accedi per commentare