
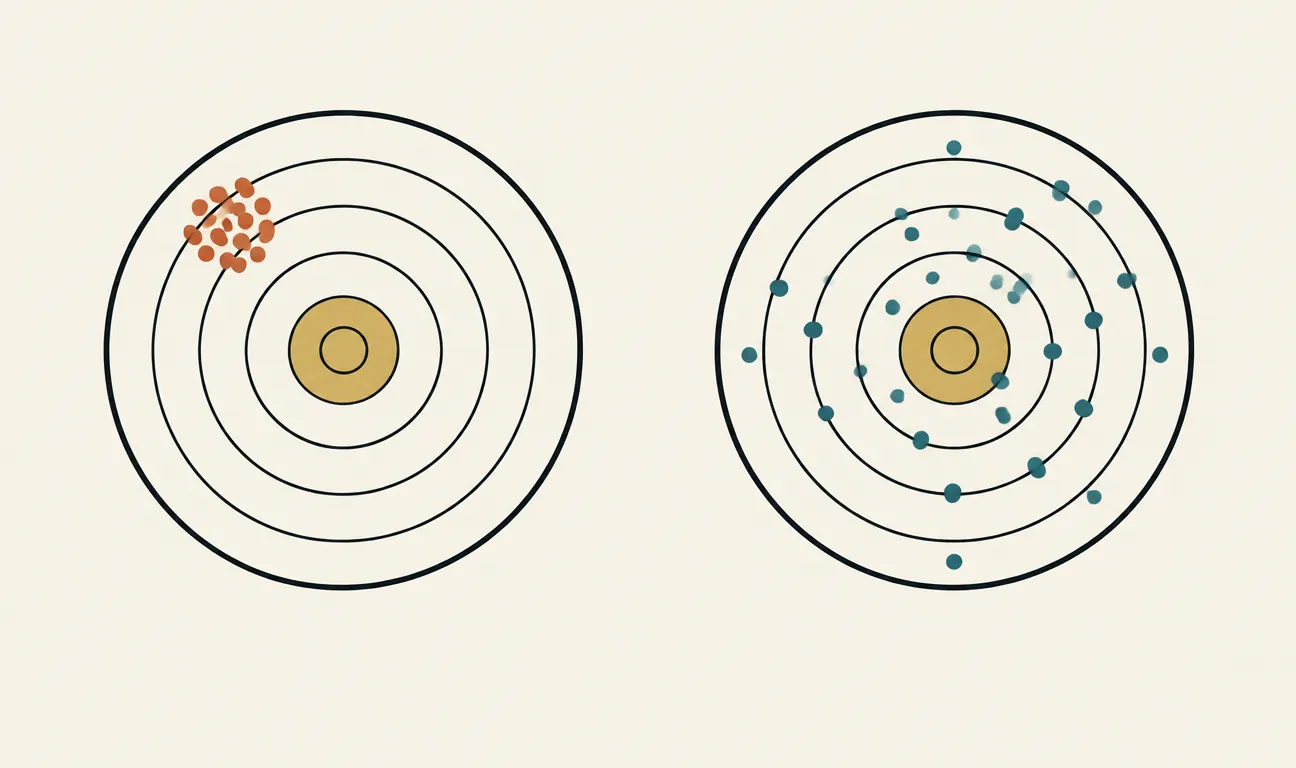
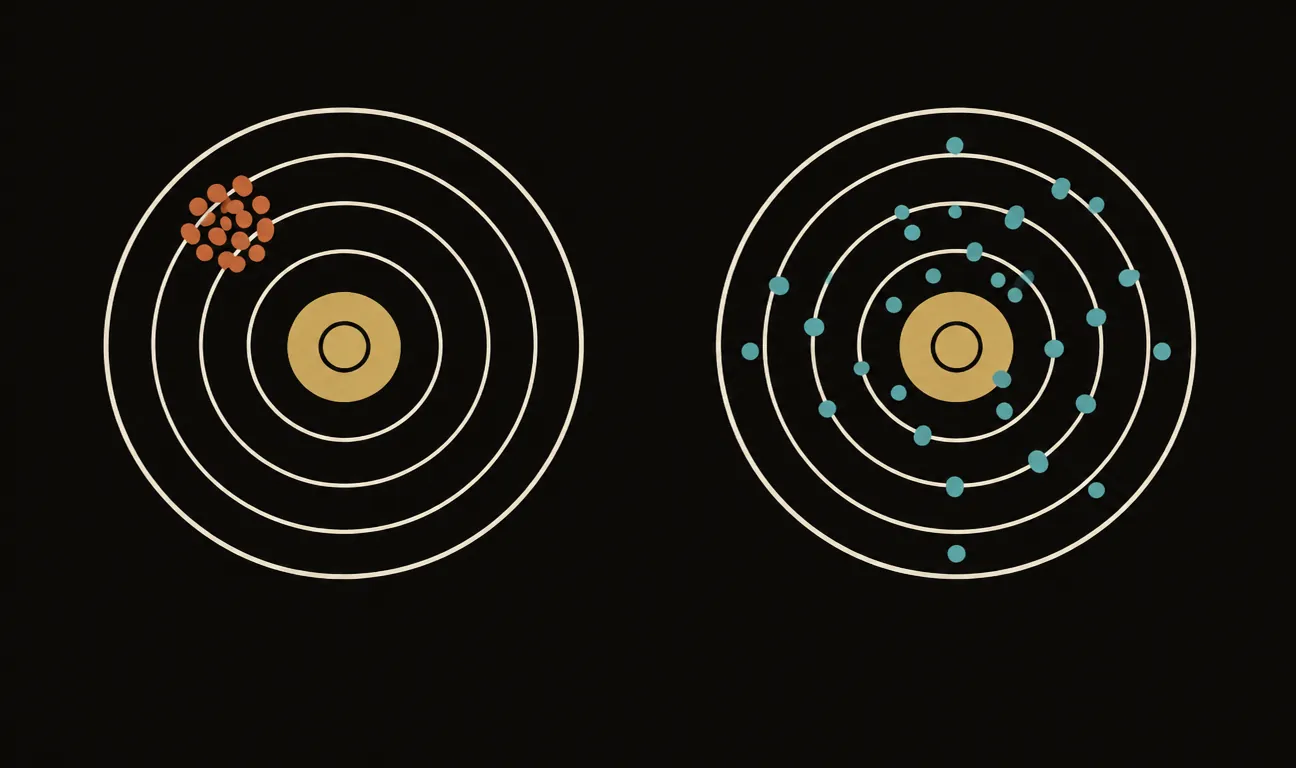
Due arcieri si allenano sullo stesso bersaglio. Il primo ha una mira ferma ma l’arco starato: tutte le frecce finiscono raggruppate strette, però venti centimetri a sinistra del centro. Il secondo ha l’arco perfetto ma la mano che trema: le frecce cadono sparse ovunque, anche se in media ruotano attorno al centro. Chi sbaglia di più? Sbagliano allo stesso modo? E soprattutto: la cura è la stessa? Questa scena, banale in apparenza, contiene la distinzione più importante di tutta la statistica applicata al machine learning. I due arcieri incarnano i due modi fondamentali in cui un modello può sbagliare: il bias e la varianza.
Overfitting e underfitting, il compromesso bias-varianza, train/validation/test e la cross-validation: nel libro, con i conti.
Leggi «Overfitting, bias-varianza e validazione» nel libro →
Due errori con caratteri opposti
Il bias è un errore sistematico: il modello sbaglia sempre nella stessa direzione, perché le sue assunzioni sono troppo rigide per catturare la realtà. È l’arco starato del primo arciere. Se provo a descrivere una relazione curva con una retta, la retta sbaglierà in modo prevedibile: sottostimerà da una parte, sovrastimerà dall’altra, e nessuna quantità di dati aggiuntivi la salverà, perché il problema non sono i dati — è la forma stessa del modello, incapace di piegarsi.
La varianza è un errore di instabilità: il modello è così flessibile che cambia radicalmente al variare del campione di addestramento. È la mano tremante del secondo arciere. Addestrate lo stesso modello flessibile su due campioni diversi estratti dalla stessa popolazione e otterrete due modelli visibilmente diversi, perché ognuno si è adattato anche al rumore del proprio campione — alle coincidenze, non solo al segnale.
La distinzione conta perché i due errori si curano con rimedi opposti. Il bias si riduce rendendo il modello più espressivo: più parametri, più flessibilità, meno assunzioni. La varianza si riduce facendo l’esatto contrario: vincolando il modello, regolarizzandolo, oppure dandogli più dati su cui mediare. Somministrare la cura sbagliata peggiora il paziente.
Il bersaglio
Il modo classico di visualizzare la coppia è una griglia di bersagli. Ogni freccia rappresenta il modello ottenuto addestrando sullo stesso problema ma con un campione di dati diverso; il centro del bersaglio è la verità che vorremmo colpire.
Quattro combinazioni di bias e varianza. Le frecce (terracotta) sono i modelli ottenuti da campioni di training diversi; il centro è la verità. In alto a sinistra il caso ideale; in basso a destra il peggiore: errore sistematico e instabilità insieme.
La griglia rende evidente una cosa che le formule nascondono: l’errore medio di un modello si scompone in un pezzo di bias al quadrato, un pezzo di varianza e un pezzo di rumore irriducibile. Il rumore non si può eliminare — è la parte del fenomeno che nessun modello può prevedere. Sugli altri due pezzi, invece, si può lavorare. Ma raramente su entrambi insieme.
La coperta corta
Qui arriva la parte scomoda: nella maggior parte dei casi bias e varianza si comportano come una coperta corta. Tirate da una parte, si scopre l’altra. Un modello semplice — una regressione lineare, un albero di decisione poco profondo — ha assunzioni forti: bias alto, ma varianza bassa, perché c’è poco che possa adattarsi al rumore. Un modello complesso — un albero profondissimo, una rete neurale enorme — ha bias basso, perché può rappresentare quasi qualunque forma, ma varianza alta: ogni piega dei dati di training, incluse le coincidenze, lascia un’impronta.
Il bias si cura con più flessibilità, la varianza con più disciplina. La diagnosi sbagliata porta alla terapia opposta a quella necessaria.
L’analogia più onesta è quella dello studente. Lo studente «alto bias» ha studiato solo il riassunto: risponde a tutto con le stesse tre idee generiche, e sbaglia in modo prevedibile ogni domanda di dettaglio. Lo studente «alta varianza» ha memorizzato ogni virgola degli esercizi svolti in classe: se all’esame esce un esercizio identico va benissimo, ma basta cambiare un numero e crolla, perché non ha estratto la regola — ha fotografato i casi particolari.
Come si fa la diagnosi
La buona notizia è che distinguere i due errori in pratica è quasi meccanico. Servono due numeri: l’errore sui dati di addestramento e l’errore su dati che il modello non ha mai visto (il set di validazione).
- Errore alto su entrambi, e simile: bias alto. Il modello è troppo rigido perfino per i dati che ha visto. Serve un modello più espressivo, feature migliori, meno regolarizzazione.
- Errore basso in training, alto in validazione: varianza alta. Il modello ha memorizzato il campione. Servono più dati, più regolarizzazione, un modello più vincolato, oppure tecniche di ensemble.
- Errore basso su entrambi: il caso felice. Si può smettere di ottimizzare e passare ai problemi veri, tipo il deployment.
È una diagnosi da cinque minuti, eppure una quota sorprendente di tempo perso nei progetti di machine learning deriva dal non farla: si raccolgono altri dati quando il problema era il bias (e i dati nuovi non servono a niente), o si ingrandisce il modello quando il problema era la varianza (e la situazione peggiora).
Perché le reti giganti complicano la storia
Un’onestà intellettuale minima impone di dire che il quadro classico ha delle crepe. Le reti neurali moderne, con miliardi di parametri, dovrebbero essere mostri di varianza — e invece, oltre una certa scala, spesso generalizzano meglio dei modelli più piccoli. Il fenomeno, studiato sotto il nome di double descent, mostra che l’errore di test può scendere di nuovo dopo il picco previsto dalla teoria classica, quando il modello diventa abbastanza grande da interpolare i dati in modo «morbido». La scomposizione bias-varianza resta matematicamente vera; è la mappa intuitiva «più parametri = più varianza» a non essere più affidabile in quel regime. Per i modelli con cui lavora la maggior parte delle persone — regressioni, alberi, gradient boosting, reti di taglia normale — la mappa classica invece funziona ancora benissimo.
Cosa ve ne fate
Se lavorate con modelli, il compromesso bias-varianza è lo strumento diagnostico che userete più spesso in carriera: due numeri, una decisione. Ma la lente serve anche a chi i modelli li usa soltanto. Quando un sistema di AI sbaglia, chiedersi come sbaglia è più utile che chiedersi quanto: sbaglia sempre allo stesso modo, su un’intera categoria di casi? È un problema di bias — di assunzioni o di dati che non rappresentano quella categoria. Sbaglia in modo erratico, dando risposte diverse a domande quasi identiche? È un problema di varianza. I due arcieri dell’inizio hanno entrambi bisogno di un allenatore. Ma non dello stesso.
I commenti sono riservati agli iscritti.
Accedi per commentare