
C’è un’immagine, in un paper del 2015, che vale più di dieci pagine di equazioni: una griglia di quadratini chiari e scuri che mette in corrispondenza le parole di una frase inglese con quelle della sua traduzione francese. Dove la griglia si illumina, il modello sta «guardando» quella parola dell’originale mentre scrive quella della traduzione. E la griglia mostra qualcosa che nessuno ha insegnato esplicitamente alla rete: quando l’ordine delle parole cambia tra le due lingue, le zone illuminate si incrociano, seguendo la grammatica. Il modello ha imparato ad allineare le lingue da solo, guardando milioni di esempi.
Comprimere una frase in un vettore, e la nascita dell’attenzione come rimedio, sono raccontati nel libro.
Il problema ereditato
Per capire da dove viene quell’immagine serve un passo indietro. Le architetture seq2seq del 2014 — ne abbiamo parlato nell’articolo precedente — traducevano comprimendo l’intera frase di partenza in un unico vettore di dimensione fissa, il famigerato collo di bottiglia. Funzionava sulle frasi brevi e degradava su quelle lunghe: troppa informazione, troppo poco spazio.
Eppure l’encoder, mentre legge, produce uno stato nascosto per ogni parola. Il seq2seq classico li scartava tutti tranne l’ultimo. È come se un traduttore leggesse il testo originale, lo riassumesse su un post-it, buttasse via il testo e traducesse dal post-it. Nessun traduttore umano lavora così: tiene l’originale sulla scrivania e ci torna sopra in continuazione, con il dito sulla riga giusta.
L’idea di Bahdanau: tenere l’originale sulla scrivania
Nel 2014 Dzmitry Bahdanau, Kyunghyun Cho e Yoshua Bengio propongono esattamente questo, in un paper dal titolo rivelatore: Neural Machine Translation by Jointly Learning to Align and Translate. Tradurre e allineare, insieme.
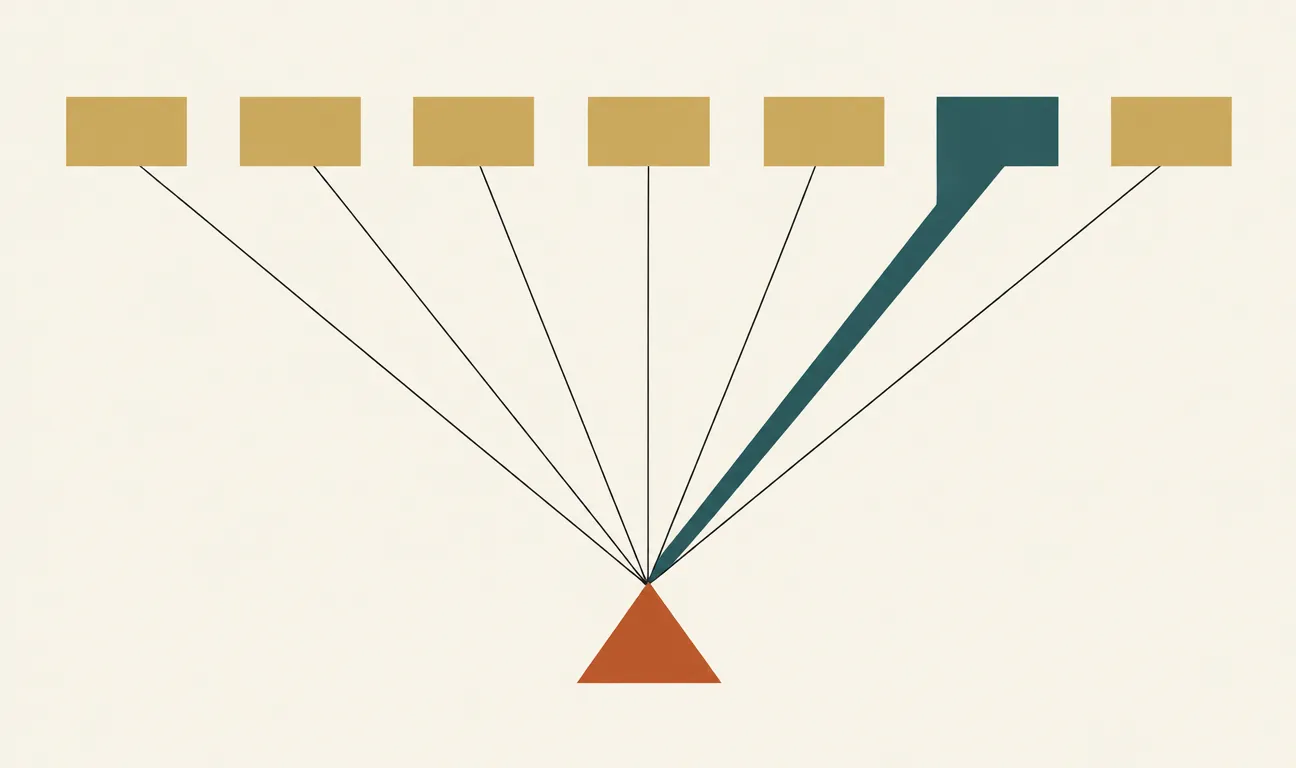
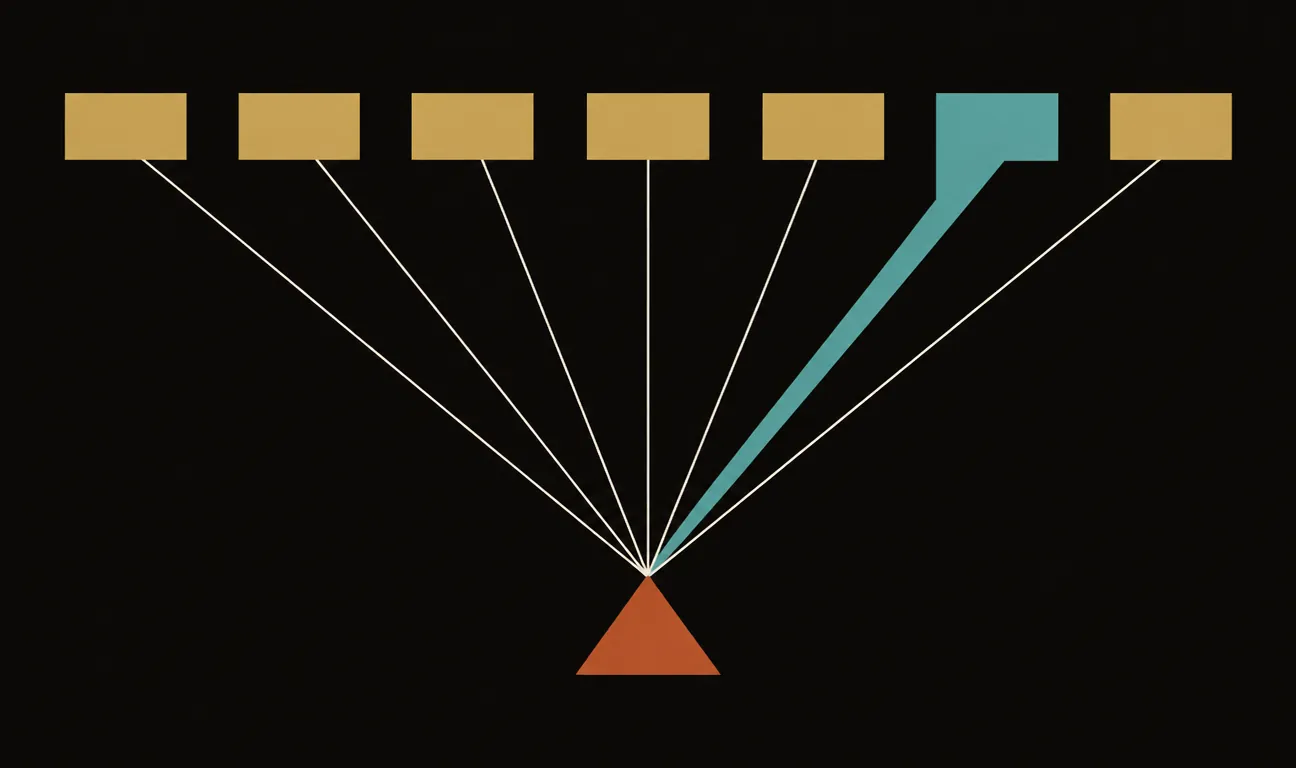
Il meccanismo: invece di consegnare al decoder un solo vettore, si conservano tutti gli stati nascosti dell’encoder, uno per parola. A ogni passo di generazione, il decoder calcola un punteggio di compatibilità tra il proprio stato attuale («che cosa sto per scrivere?») e ciascuno stato dell’encoder («che cosa dice ogni parola dell’originale?»). I punteggi, passati attraverso una softmax, diventano pesi che sommano a uno. Il decoder riceve quindi una media pesata degli stati dell’encoder: un vettore di contesto diverso a ogni passo, cucito su misura per la parola che sta per generare.
Mentre genera «gatto», il modello concentra il peso su «cat»; mentre genera «nero», su «black». Le linee si incrociano perché inglese e italiano ordinano aggettivo e nome in modo opposto: nessuno l’ha programmato, l’allineamento emerge dall’addestramento.
Pesare, non scegliere
Il dettaglio decisivo è che l’allineamento è morbido. Il decoder non sceglie una parola sola dell’originale: distribuisce la propria attenzione su tutte, con pesi diversi. È la differenza tra puntare un dito e orientare una lampada: la luce cade soprattutto su un punto, ma illumina anche i dintorni. Per generare «nero», il grosso del peso va su «black», ma un po’ ne resta su «cat» — utile, perché in italiano l’aggettivo deve accordarsi in genere con il nome.
Questa morbidezza non è una finezza stilistica: è ciò che rende tutto addestrabile. Una scelta secca («guarda solo la parola 3») non è derivabile, e senza derivate la backpropagation si ferma. Una media pesata invece è una funzione continua: l’errore di traduzione può fluire all’indietro attraverso i pesi di attention e correggerli, esempio dopo esempio. L’allineamento non è annotato da linguisti: è un sottoprodotto dell’imparare a tradurre.
L’attention nasce come cerotto per un difetto del seq2seq. Tre anni dopo, il cerotto si è mangiato il paziente.
Le varianti di Luong
Nel 2015 Minh-Thang Luong, Hieu Pham e Christopher Manning ripuliscono e sistematizzano l’idea. Il loro contributo più duraturo è la semplificazione del calcolo dei punteggi: dove Bahdanau usava una piccola rete neurale dedicata, Luong mostra che spesso basta un prodotto scalare tra lo stato del decoder e quelli dell’encoder — più semplice, più veloce, altrettanto efficace. Propongono anche una distinzione tra attention globale (su tutta la frase) e locale (su una finestra ristretta), anticipando un tema che tornerà anni dopo nei modelli a contesto lungo.
Il prodotto scalare come misura di compatibilità è esattamente la forma che ritroveremo nei transformer: la celebre formula con query, key e value è una generalizzazione diretta di questa intuizione.
Il seme dei transformer
Tra il 2015 e il 2017 l’attention è un accessorio: si aggiunge a un’architettura ricorrente per aiutarla. Le RNN restano il motore, l’attention è il servosterzo. Poi, nel 2017, il paper Attention Is All You Need compie il gesto radicale annunciato dal titolo: via le ricorrenze, si tiene solo l’attention. Ogni parola guarda tutte le altre, in parallelo, a più teste contemporaneamente. Ma il meccanismo di base — punteggi di compatibilità, softmax, media pesata — è lo stesso identico congegno montato da Bahdanau su un traduttore inglese-francese.
Vale la pena notarlo, perché la vulgata racconta i transformer come un fulmine a ciel sereno. Non lo furono: furono la promozione a protagonista di un comprimario che recitava da tre anni.
Perché ti riguarda
Ogni volta che un modello linguistico moderno risolve un pronome ambiguo, recupera un nome citato duecento parole prima o segue un’istruzione sepolta a metà del vostro prompt, sta usando i discendenti diretti di questo meccanismo. Capire l’attention nella sua forma originale — un traduttore che tiene il dito sull’originale — è il modo più concreto per capire cosa significa «finestra di contesto», perché i modelli a volte «perdono» informazione a metà di un documento lungo, e perché il costo computazionale cresce col quadrato della lunghezza. La versione del 2015 è abbastanza piccola da stare in testa tutta intera. Ed è il fondamento su cui è costruito, letteralmente, tutto il resto.
Per approfondire
I due paper fondativi sono liberamente accessibili: Bahdanau, Cho, Bengio — Neural Machine Translation by Jointly Learning to Align and Translate (arXiv:1409.0473) e Luong, Pham, Manning — Effective Approaches to Attention-based Neural Machine Translation (arXiv:1508.04025). Il primo contiene le griglie di allineamento da cui siamo partiti: guardarle con i propri occhi vale la lettura.
I commenti sono riservati agli iscritti.
Accedi per commentare