
Prendete una frase di venti parole. Ora immaginate di doverla riassumere in una cartolina con spazio per un solo numero di telefono, e di consegnare quella cartolina a un collega che, senza aver mai visto la frase originale, deve riscriverla in un’altra lingua. Sembra un gioco crudele. Eppure è esattamente il modo in cui, nel 2014, le reti neurali hanno iniziato a tradurre — e per un paio d’anni è stato lo stato dell’arte.
Comprimere una frase in un vettore, e la nascita dell’attenzione come rimedio, sono raccontati nel libro.
Due reti, un compito
L’architettura si chiama sequence-to-sequence, abbreviato seq2seq, ed è stata proposta in due lavori quasi simultanei: quello di Kyunghyun Cho e colleghi e quello di Ilya Sutskever, Oriol Vinyals e Quoc Le, entrambi del 2014. L’idea è di una semplicità disarmante: servono due reti ricorrenti, un encoder e un decoder.
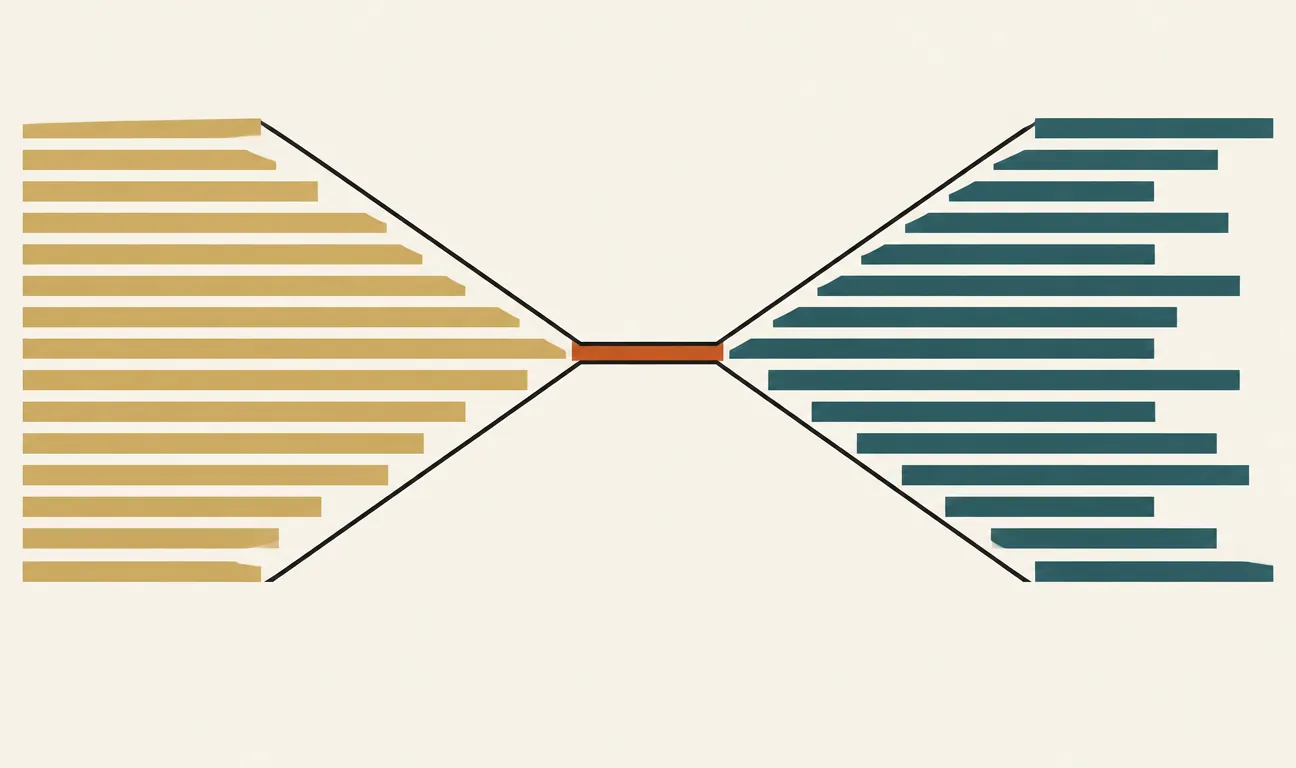
L’encoder legge la frase di partenza una parola alla volta. A ogni passo aggiorna il proprio stato nascosto, un vettore di qualche centinaio o migliaio di numeri che funziona come una memoria di lavoro: dopo aver letto «il gatto dorme», lo stato contiene una rappresentazione compressa di quelle tre parole. Quando la frase finisce, l’ultimo stato nascosto diventa il vettore di contesto: un unico punto in uno spazio ad alta dimensione che dovrebbe contenere tutto il significato della frase.
Il decoder parte da quel vettore e genera la traduzione una parola alla volta, usando a ogni passo la parola appena prodotta e il proprio stato interno. È come un telefono senza fili giocato da due sole persone: la prima ascolta tutto e sussurra un riassunto, la seconda ricostruisce il messaggio dal riassunto.
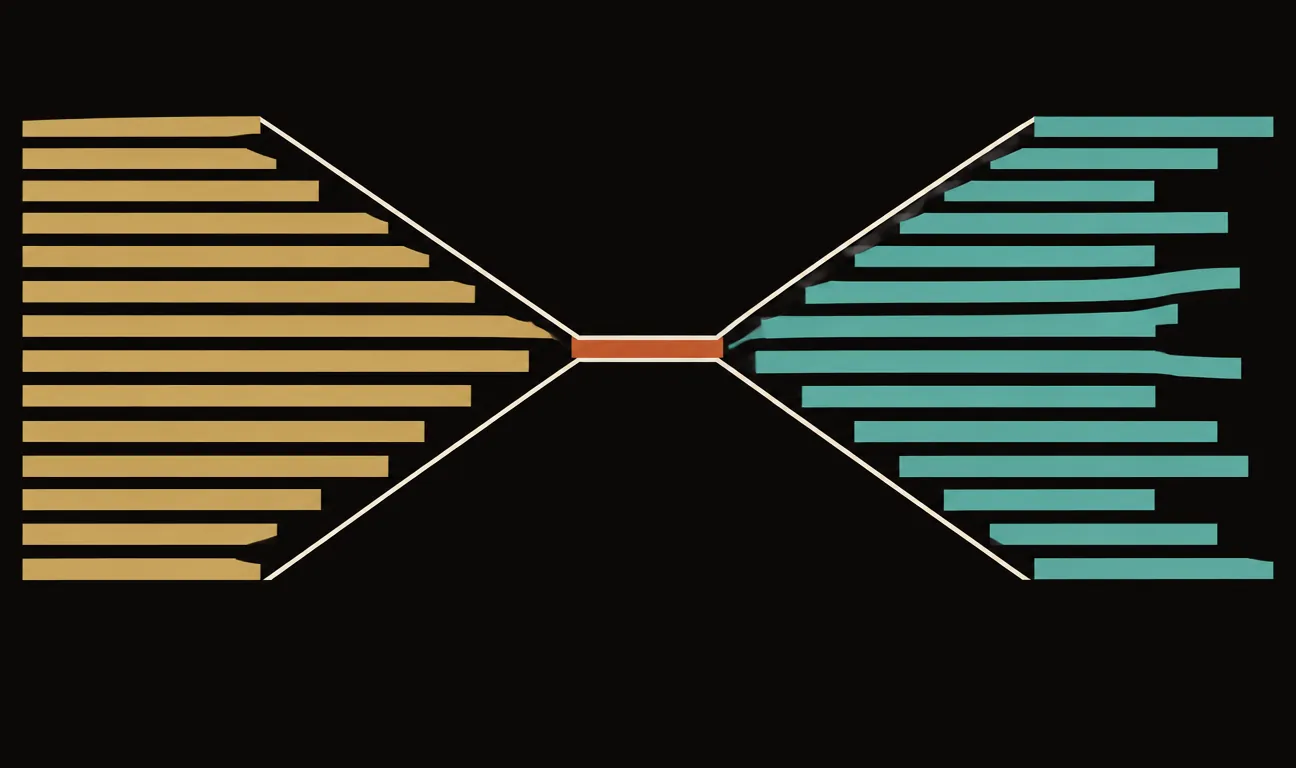
L’architettura seq2seq: qualunque sia la lunghezza della frase in ingresso, tutto deve passare per un singolo vettore di dimensione fissa. È il collo di bottiglia dell’imbuto.
Perché era una buona idea
Prima del seq2seq, la traduzione automatica statistica era un mosaico di componenti separati: tabelle di frasi, modelli di riordino, modelli di linguaggio, ciascuno addestrato per conto suo e poi incollato agli altri. Il seq2seq sostituiva tutto con un unico modello addestrato end-to-end: si mostrano coppie di frasi (originale, traduzione) e la rete impara da sola sia a capire sia a generare.
C’era anche un’eleganza concettuale: il vettore di contesto è una rappresentazione del significato della frase, indipendente dalla lingua. Frasi simili finiscono in punti vicini dello spazio. Sutskever e colleghi mostrarono che il loro modello, un LSTM a più strati, otteneva sulla traduzione inglese-francese risultati competitivi con i sistemi statistici costruiti in anni di ingegneria.
Il collo di bottiglia
Il problema è aritmetico prima che concettuale. Il vettore di contesto ha dimensione fissa: mille numeri, per dire. Una frase di cinque parole e una di cinquanta devono stare nello stesso spazio. È come traslocare: una scatola da imballaggio va benissimo per il contenuto di un cassetto, ma se ci devi far stare un intero soggiorno, qualcosa resta fuori — e non scegli tu cosa.
Gli esperimenti confermarono l’intuizione: la qualità della traduzione degradava man mano che le frasi si allungavano. Cho e colleghi lo documentarono in modo sistematico nello stesso 2014 — oltre una certa lunghezza, il punteggio BLEU (la metrica standard della traduzione automatica) crollava. Le prime parole della frase, lette per prime e «sovrascritte» da tutto ciò che seguiva, erano le più penalizzate: la memoria di lavoro dell’encoder, per quanto sofisticata, si diluiva.
Una frase di cinque parole e una di cinquanta devono stare nello stesso vettore. È la scatola da trasloco che va bene per un cassetto ma deve contenere un soggiorno.
I trucchi che compravano tempo
La comunità reagì con espedienti ingegnosi, alcuni quasi comici nella loro semplicità:
- Invertire la frase di ingresso. Sutskever e colleghi scoprirono che leggere la frase al contrario migliorava sensibilmente i risultati: le prime parole dell’originale finivano vicine alle prime parole da generare, accorciando la distanza che l’informazione doveva percorrere.
- Usare LSTM invece di RNN semplici. Le celle LSTM, con i loro gate, trattengono l’informazione più a lungo. Alleviano il problema, non lo risolvono.
- Beam search in decodifica. Invece di scegliere avidamente la parola più probabile a ogni passo, il decoder tiene aperte più ipotesi in parallelo. Migliora la generazione, ma non aggiunge nulla alla memoria.
Tutti questi trucchi condividono un limite: ottimizzano il passaggio attraverso il collo di bottiglia, ma il collo di bottiglia resta. L’informazione disponibile al decoder è comunque quel singolo punto nello spazio.
La domanda giusta
La soluzione vera arrivò cambiando la domanda. Non «come comprimiamo meglio la frase in un vettore?», ma «perché mai dovremmo comprimerla in un solo vettore?». L’encoder, dopotutto, produce uno stato nascosto per ogni parola letta: buttarli via tutti tranne l’ultimo è uno spreco. E se il decoder potesse consultarli tutti, scegliendo di volta in volta quello più utile?
Questa idea — permettere al decoder di «guardare indietro» alla frase originale mentre traduce — si chiama attention, e la racconteremo nel prossimo articolo. Qui basti dire che nasce come cerotto per il collo di bottiglia del seq2seq e finirà, tre anni dopo, per mangiarsi l’intera architettura.
Perché ti riguarda
Il collo di bottiglia del vettore unico non è un aneddoto di archeologia informatica: è un pattern che ritorna ovunque nell’AI di oggi. Quando un sistema RAG comprime un documento in un embedding per la ricerca semantica, sta facendo la stessa scommessa del seq2seq — e paga lo stesso prezzo sui documenti lunghi e densi. Quando un modello riassume una conversazione per farla stare nel contesto, sta stringendo un soggiorno in una scatola. Riconoscere il pattern aiuta a farsi la domanda giusta al momento giusto: non «come comprimo meglio?», ma «sono sicuro di dover comprimere tutto in un punto solo?». Nel 2014 quella domanda ha cambiato la traiettoria del deep learning. Nei vostri progetti, più modestamente, può evitare qualche architettura sbagliata.
I commenti sono riservati agli iscritti.
Accedi per commentare