
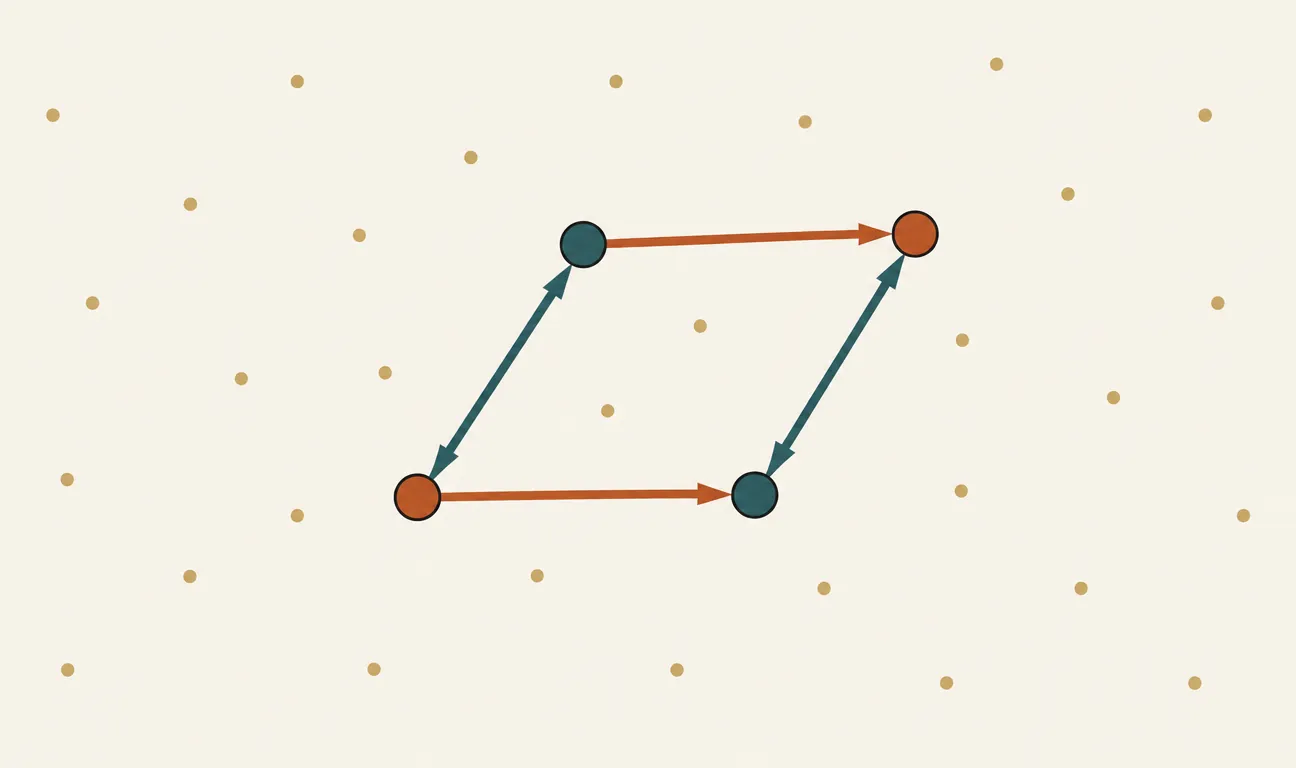
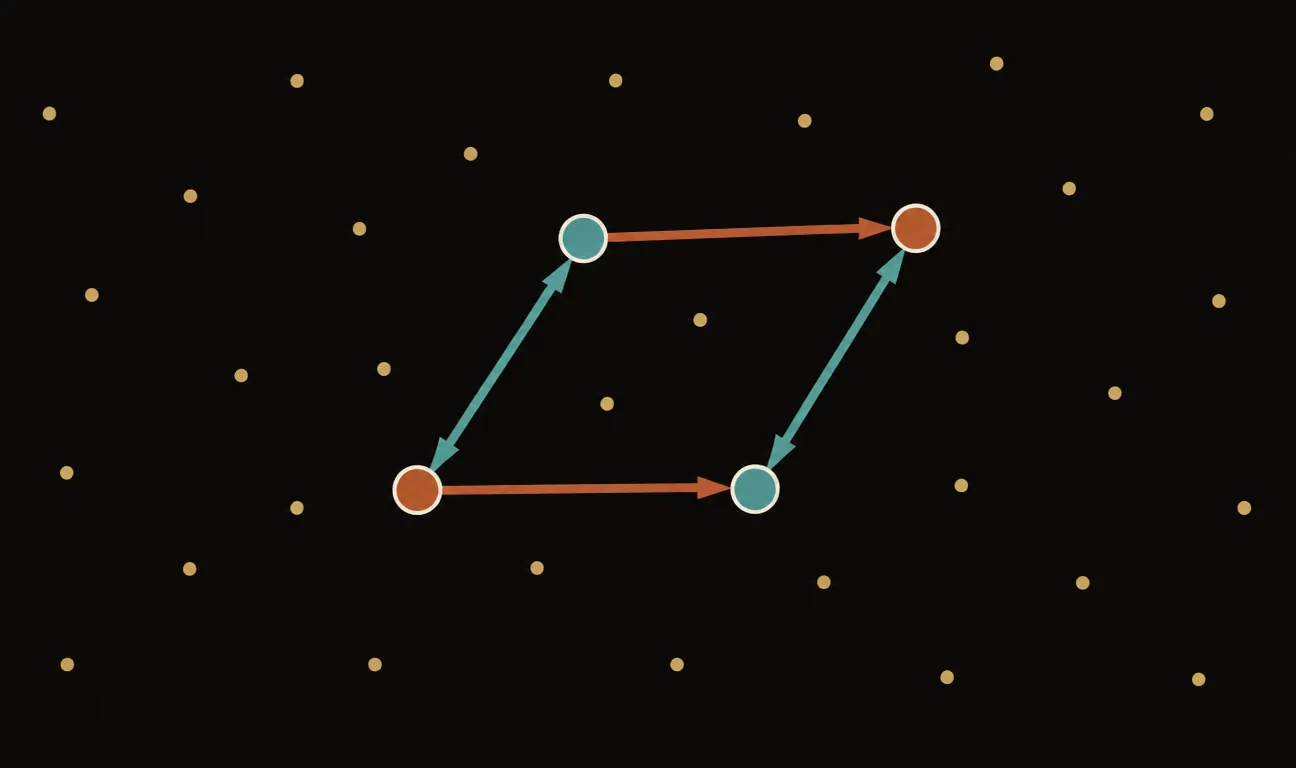
«Re» meno «uomo» più «donna» uguale, più o meno, «regina». Nel 2013 questa equazione fa il giro delle conferenze e dei blog tecnici: un gruppo di ricercatori di Google guidato da Tomas Mikolov mostra che, rappresentando le parole come vettori appresi da grandi quantità di testo, certe relazioni di significato diventano operazioni aritmetiche. Il modello si chiama word2vec, il paper è «Efficient Estimation of Word Representations in Vector Space», e l’idea alla base è così semplice che si può spiegare a cena: una parola è definita dalle parole che le stanno intorno.
Tokenizzazione, one-hot, bag-of-words e TF-IDF, fino ai vettori densi degli embedding: il percorso completo è nel libro.
Leggi «Rappresentare il testo: dai token agli embedding» nel libro →
Dimmi con chi vai
L’intuizione non nasce nel 2013. Il linguista John Rupert Firth la formulò già negli anni Cinquanta: conosci una parola dalle compagnie che frequenta. È la cosiddetta ipotesi distribuzionale: parole che compaiono in contesti simili tendono ad avere significati simili.
Funziona anche per gli umani. Se incontri per la prima volta la parola «ramen» e la vedi comparire in frasi con «brodo», «noodles», «ristorante», «bacchette», dopo qualche esempio hai capito di cosa si tratta senza che nessuno te l’abbia definita. Il contesto ha fatto da dizionario. Word2vec non fa altro che applicare questo principio su scala industriale: miliardi di parole di testo, e per ognuna la domanda «chi ti sta intorno?».
La finestra di contesto
Il meccanismo concreto è una finestra che scorre sul testo. Prendi una frase, punta una parola centrale, guarda le due o cinque parole a sinistra e a destra: quello è il contesto. Il modello viene addestrato in una di due varianti speculari: CBOW (dal contesto indovina la parola centrale) o skip-gram (dalla parola centrale indovina il contesto). In entrambi i casi, il sottoprodotto dell’addestramento — i pesi interni del modello — è ciò che ci interessa davvero: un vettore denso di qualche centinaio di numeri per ogni parola del vocabolario.
La finestra scorre sul testo: da ogni parola centrale e dal suo contesto il modello impara, finestra dopo finestra, un vettore denso che riassume in che compagnie la parola compare.
L’analogia più fedele è quella di un gioco di società: ti mostro una frase con un buco — «il ___ dorme sul divano» — e tu devi indovinare cosa manca. Per vincere spesso, sei costretto a costruirti un’idea di quali parole vanno in quali contesti. Word2vec gioca a questo gioco miliardi di volte, e i vettori sono i suoi appunti di gioco.
Imparare senza etichette
C’è un aspetto del metodo che all’epoca era meno scontato di quanto sembri oggi: word2vec non ha bisogno di dati etichettati. Nessun umano deve annotare frasi, marcare sinonimi, compilare dizionari. Il testo grezzo è già il dataset: ogni finestra di contesto è un piccolo esercizio con la risposta inclusa. Oggi lo chiamiamo apprendimento auto-supervisionato, ed è lo stesso principio con cui si pre-addestrano gli LLM (predire la parola successiva è un cugino stretto di predire la parola nel buco).
Il paper introduce anche accorgimenti per rendere l’addestramento veloce — su tutti il negative sampling: invece di calcolare a ogni passo una probabilità su tutto il vocabolario, il modello impara a distinguere la coppia parola-contesto vera da poche coppie false pescate a caso. È la differenza tra correggere un compito confrontandolo con l’intera enciclopedia e correggerlo confrontandolo con cinque risposte sbagliate: molto più sbrigativo, quasi altrettanto istruttivo. Grazie a questi trucchi, word2vec si addestrava su corpora enormi con l’hardware del 2013, senza GPU esotiche.
La geometria del significato
Il risultato è uno spazio in cui la distanza ha senso. «Gatto» e «cane» finiscono vicini, entrambi lontani da «obbligazione». I sinonimi si avvicinano da soli, perché frequentano gli stessi contesti — esattamente il problema che il bag of words non poteva risolvere. E poi ci sono le direzioni: lo spostamento che porta da «re» a «regina» somiglia a quello che porta da «attore» ad «attrice». Alcune relazioni — genere, plurale, capitale-nazione — diventano frecce approssimativamente coerenti nello spazio.
Nessuno ha insegnato al modello cosa sia il genere grammaticale. È emerso da solo, come direzione nello spazio, dal semplice conteggio delle compagnie che ogni parola frequenta.
Onestà intellettuale d’obbligo: le analogie aritmetiche funzionano bene sugli esempi celebri e molto meno in generale; la letteratura successiva ha ridimensionato l’effetto-vetrina. Ma il punto profondo resta intatto: il significato, o almeno una sua proiezione utile, si può apprendere dalla distribuzione e maneggiare con l’algebra lineare.
I limiti, e cosa è venuto dopo
Word2vec assegna a ogni parola un solo vettore, per sempre. «Calcio» ha lo stesso punto nello spazio sia nella frase sul campionato sia in quella sull’integratore alimentare: il modello fa una media dei suoi usi, e le parole ambigue ne escono sfocate. Inoltre il vettore è statico: una volta addestrato, non guarda più la frase in cui la parola compare davvero.
La generazione successiva — ELMo, poi BERT e i transformer — nasce per superare proprio questo: embedding contestuali, calcolati al volo per ogni occorrenza, dove il «calcio» dello stadio e quello della farmacia ricevono finalmente vettori diversi. Ma il salto concettuale grosso, da simbolo a geometria, lo aveva già fatto word2vec.
Perché ti riguarda
Se oggi usi una ricerca semantica, un sistema RAG, un motore di raccomandazione o un LLM qualsiasi, stai usando discendenti diretti di questa idea: là sotto, testi e concetti sono vettori, e la vicinanza geometrica fa da misura di somiglianza. Quando senti dire «embedding», il modello mentale giusto è ancora quello del 2013: significato come posizione, somiglianza come distanza, relazione come direzione. Word2vec è il posto migliore dove impararlo, perché lì il meccanismo è abbastanza piccolo da vederlo tutto intero — prima che i transformer lo seppelliscano sotto miliardi di parametri.
Per chi vuole andare alla fonte: il paper originale è Tomas Mikolov, Kai Chen, Greg Corrado e Jeffrey Dean, «Efficient Estimation of Word Representations in Vector Space» (2013), disponibile su arXiv come 1301.3781; il negative sampling è approfondito nel successivo 1310.4546.
I commenti sono riservati agli iscritti.
Accedi per commentare