
Francis Galton aveva promesso dei premi a chi gli avesse spedito i registri della propria famiglia, e le famiglie risposero. Da quei quaderni ricavò le stature di 928 figli adulti e dei loro genitori, 205 coppie, e nel 1886 pubblicò quello che ci aveva trovato. I figli dei genitori alti erano alti, ma meno dei genitori. I figli dei genitori bassi erano bassi, ma meno dei genitori. In media, scrisse, lo scarto di un figlio dalla statura comune è due terzi dello scarto medio dei suoi genitori. Lo aveva già visto anni prima con i semi dei piselli odorosi: quelli della generazione successiva tendevano a essere «sempre più mediocri» dei semi da cui venivano.
L’articolo si intitola Regression towards Mediocrity in Hereditary Stature, regressione verso la mediocrità nella statura ereditaria. Da lì viene la parola che usiamo ancora per la retta di regressione, e da lì viene un’idea entrata nel modo di dire: prima o poi si torna alla media. Galton e Darwin erano cugini, nipoti dello stesso nonno, e tre anni prima Galton aveva coniato la parola eugenetica. Cercava la legge con cui il talento passa da una generazione all’altra, e trovò che gli estremi non si ereditano per intero.
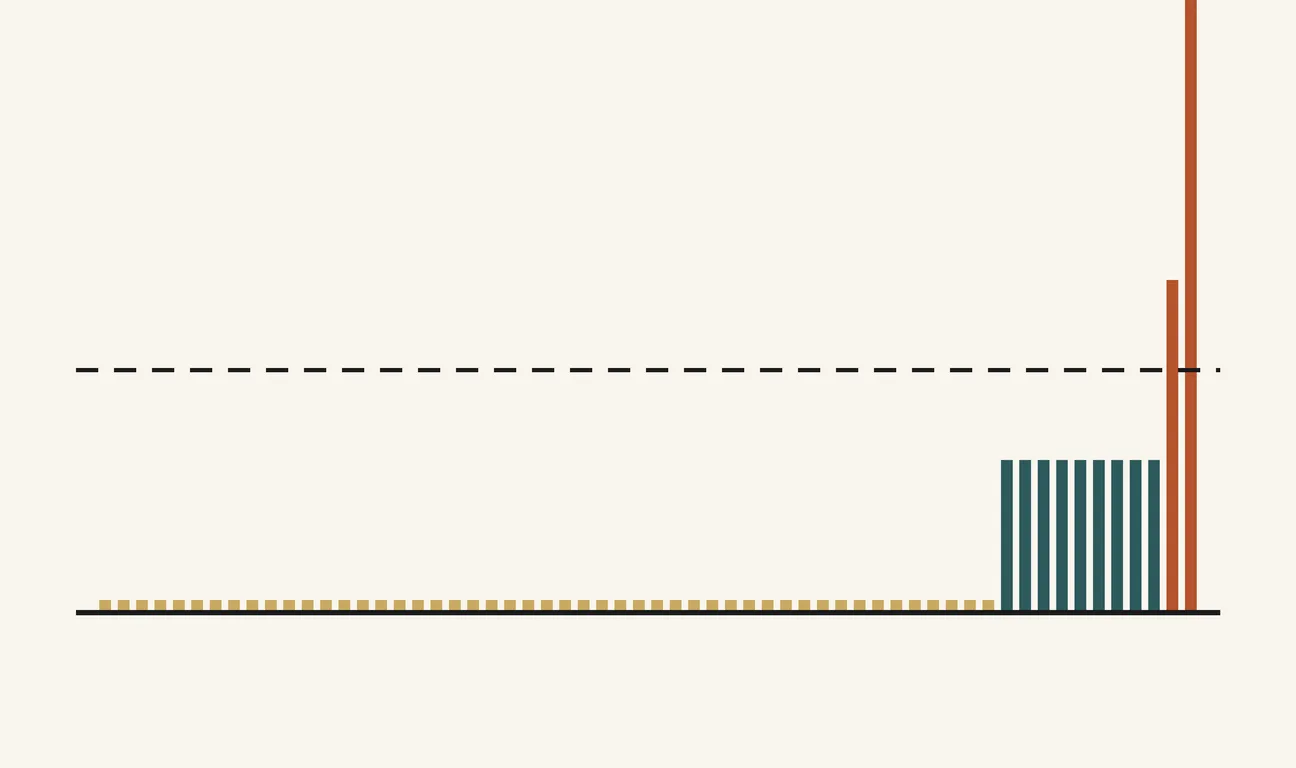
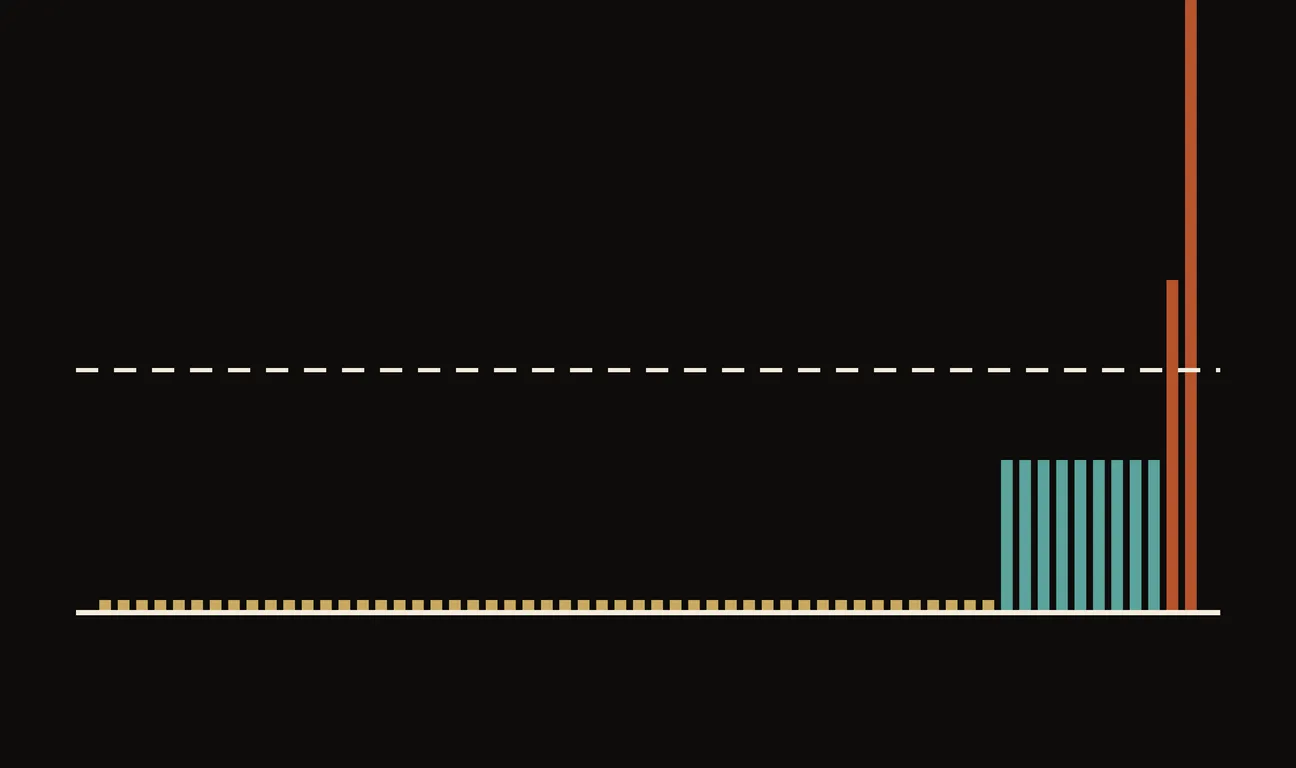
Centoquarant’anni dopo, sull’intelligenza artificiale circola un’idea che sembra la sua rovesciata. La mediocrità si è alzata. Chi scriveva male ora scrive in modo decente, chi non sapeva programmare mette insieme un’applicazione, e il livello che ieri bastava oggi lo dà una macchina a chiunque. Se è così, la media non è più il posto verso cui si torna: è un posto che nessuno ricorda. Questo articolo prende l’idea sul serio, cioè la mette davanti ai dati. Ne esce una figura diversa da quella attesa: quasi tutti a zero, un gradino uguale per chi è salito, pochissimi molto in alto. E una media che non descrive nessuno dei tre.
Mediocre non era un insulto
Conviene partire da che cosa Galton aveva visto davvero, perché la sua scoperta si racconta quasi sempre sbagliata. La regressione verso la media non è una forza. Niente tira verso il basso i figli degli alti. Succede che la statura di una persona dipende in parte da ciò che eredita e in parte dal caso, e che fra i genitori molto alti abbondano quelli a cui il caso è andato bene. Ai figli passa l’eredità, non la fortuna.
La prova che non si tratta di una spinta sta nello stesso articolo. Galton nota che la legge vale anche a ritroso: i genitori di un uomo molto alto sono, in media, meno eccezionali di lui. E osserva che un uomo eccezionale è più spesso il figlio un po’ eccezionale di genitori piuttosto mediocri che il figlio medio di genitori eccezionali, per la semplice ragione che i mediocri sono molti di più. La popolazione, intanto, resta com’era, con la stessa media a ogni generazione. La regressione verso la media descrive che cosa succede quando si misura due volte una cosa che ha dentro del caso, e lascia intatta la forma della folla.
Poi c’è la parola. Mediocrity, per Galton, è il nome di un punto: «il livello della mediocrità», scrive, nella sua popolazione è 68 pollici e un quarto, poco più di un metro e settantatré. Non c’è disprezzo. In una distribuzione a campana la media è il posto più affollato che esista, quello in cui media, mediana e moda cadono insieme. Chi dice «la media» dice «dove sta la gente».
Che cos’è una retta di regressione, come si trova quella che passa meglio fra i punti e perché porta ancora il nome che le diede Galton, lo spiega il libro.
Una folla, però, può prendere anche un’altra forma, e questa porta il nome di un italiano. Alla fine dell’Ottocento Vilfredo Pareto studiò i redditi e ne ricavò una legge che non somiglia a una campana. La distribuzione di Pareto ha un minimo sotto il quale non si scende, moltissime persone addossate a quel minimo e una coda di pochi che si allunga senza un termine visibile. Lì le tre misure che nella campana coincidono si separano: la moda sta sul muro, la mediana poco più in là, la media viene trascinata lontano dai pochi della coda.
Quanto lontano, si calcola. Prendiamo la coda che dà la proporzione più citata, quella per cui un quinto delle persone ha quattro quinti del totale. La media vale circa sette volte il minimo, e nove persone su dieci stanno sotto la media. La media esiste, si calcola, si può scrivere in un rapporto. Solo che lì non c’è quasi nessuno.
Il pavimento che sale
L’idea che l’AI alzi la mediocrità non è un’impressione: viene da esperimenti fatti bene. Lo schema è sempre lo stesso. Si sceglie un compito, si dà l’assistente a una parte dei partecipanti estratti a sorte e si guarda chi migliora di più. Migliorano di più quelli che partivano indietro.
| Studio | Chi partecipa | Che cosa trova |
|---|---|---|
| Noy e Zhang, 2023 | 453 professionisti, compiti di scrittura | tempo −40%, qualità +18%, differenze fra lavoratori ridotte |
| Dell’Acqua e altri, 2023 | 758 consulenti di Boston Consulting Group | metà più debole +43%, metà più forte +17% |
| Cruces e altri, 2026 | 1.174 adulti, un problema aziendale da risolvere | divario fra più e meno istruiti da 0,548 a 0,139 deviazioni standard |
| Bastani e altri, 2025 | quasi mille studenti delle superiori, matematica | con GPT-4 +48% negli esercizi; poi, senza, −17% all’esame |
Il terzo risultato è quello che dà la misura. Nell’esperimento di Guillermo Cruces e colleghi, senza assistente i partecipanti con più istruzione battono gli altri di oltre mezza deviazione standard. Con l’assistente tre quarti del divario spariscono, e i meno istruiti aiutati dalla macchina fanno meglio dei più istruiti lasciati soli. In quel compito il pavimento si è alzato sopra la vecchia media.
Proprio qui Galton torna utile, e non come antenato. Il dato più citato di tutti, il +43% contro +17% dei consulenti, non mette a confronto chi aveva l’assistente con chi non l’aveva. Prende soltanto chi l’aveva, lo divide in due metà secondo il voto di una prova fatta prima dell’esperimento, e misura di quanto ciascuna metà è salita rispetto al proprio voto. È il disegno in cui la regressione verso la media lavora di nascosto. Chi alla prima prova ha avuto una giornata storta finisce nella metà bassa, e alla seconda in media risale, con o senza macchina. Chi ha avuto una giornata fortunata finisce nella metà alta, e in media scende. Una parte di quella forbice ci sarebbe stata comunque.
Nella versione dello studio diffusa nel 2023, che è quella che abbiamo letto (nel 2026 è uscito sulla rivista Organization Science), l’espressione «regressione verso la media» non compare. Il risultato principale non ne dipende: che con l’AI i consulenti lavorino meglio lo dice il confronto con chi non l’aveva. Ma di quanto i deboli migliorino più dei forti, quel numero da solo non lo dice.
C’è poi una distinzione che gli esperimenti fanno e che nel passaparola si perde. Quello che sale è il prodotto, non per forza la persona. Agli studenti seguiti da Hamsa Bastani e colleghi GPT-4 fa prendere voti più alti del 48% durante gli esercizi; tolto lo strumento, all’esame vanno peggio del 17% rispetto a chi non l’aveva mai avuto (una seconda versione dell’assistente, costruita per guidare senza dare la soluzione, il danno lo evita quasi del tutto). Nell’esperimento di Cruces il danno non c’è, ma il divario fra più e meno istruiti, appena la macchina viene tolta, in buona parte ritorna. Si è alzato il livello di ciò che si consegna; il livello di ciò che si sa fare da soli è un’altra misura, e si muove molto meno.
Un’ora di sfilata
Tutti questi esperimenti hanno un limite in comune, che non è un difetto: guardano persone che l’assistente ce l’hanno. Per sapere che forma ha preso la folla bisogna guardare tutti, e per guardare tutti esiste un’invenzione di cinquantacinque anni fa.
Nel 1971 l’economista olandese Jan Pen, in un libro intitolato Income Distribution, propose di far sfilare l’intera popolazione in un’ora esatta, in ordine di reddito, dando a ciascuno una statura proporzionale a quello che guadagna. Chi ha il reddito medio ha la statura media, quella di chi guarda. La sfilata comincia con persone che non si vedono nemmeno. Per molto tempo passano nani. Bisogna aspettare circa tre quarti d’ora perché arrivi qualcuno alto come lo spettatore, e negli ultimi secondi passano giganti che si vedono solo fino alle ginocchia. Galton misurava le stature per capire un’eredità; Pen trasforma in statura una cosa che non si vede.
Proviamo a far sfilare il mondo per uso dell’intelligenza artificiale. Il conto più largo che esista lo pubblica Microsoft ogni trimestre: a giugno 2026 aveva usato un prodotto di AI generativa il 18,8% delle persone fra 15 e 64 anni. Tradotto in sfilata: per quasi 49 minuti passano persone di statura zero, e chi la usa occupa gli ultimi undici. È una stima, e Microsoft per prima avverte che nessuna misura è perfetta: parte dai dati di utilizzo dei suoi prodotti, corretti per quote di mercato, diffusione di internet e popolazione.
Dentro quei 49 minuti c’è chi potrebbe usarla e non lo fa, e c’è chi non può. Secondo l’Unione internazionale delle telecomunicazioni, nel 2025 restavano senza connessione 2,2 miliardi di persone di ogni età, e il 96% vive in paesi a reddito basso o medio.
Il primo pezzo della figura attesa, quindi, c’è, ed è più grande del previsto. La mediocrità si è alzata per una persona su cinque. Per le altre quattro non è successo niente, e la distanza fra i due gruppi cresce: nel nord del mondo usa l’AI il 28,8% delle persone in età da lavoro, nel sud il 16,2%, e da un trimestre all’altro la forbice si è allargata. Negli Emirati Arabi Uniti la usa il 73,3%.
Fra i paesi la coda è più corta del previsto
Fra chi la usa, quanto conta il paese in cui si vive? Qui un dato pubblico c’è, e lo abbiamo usato per fare un conto. Anthropic pubblica con licenza aperta la quota dell’uso di Claude che spetta a ogni paese. Abbiamo messo in fila i paesi da quello che lo usa meno, in rapporto agli abitanti, a quello che lo usa di più, e accanto abbiamo fatto la stessa cosa con il PIL, sugli stessi paesi. Sono due curve di Lorenz: più la curva si allontana dalla diagonale, peggio è divisa la torta. L’indice di Gini, che porta il nome dello statistico italiano Corrado Gini, riassume quella distanza in un numero fra zero (tutti uguali) e uno (tutto a uno solo).
Sui dati di maggio 2026, cioè 120 paesi e 3,7 miliardi di persone in età da lavoro, l’indice di Gini dell’uso di Claude è 0,56. Quello del PIL, sugli stessi paesi, è 0,67. La metà della popolazione che vive dove Claude si usa meno fa il 13,8% dell’uso; la metà che vive nei paesi più poveri ha il 7,6% del prodotto. Il decimo in cima fa il 40,7% dell’uso e ha il 50,1% del prodotto. Ad aprile il Gini dell’uso era 0,57.
Non ce lo aspettavamo. Fra un paese e l’altro l’uso di questa AI è diviso male, ma meno male del denaro. L’India, da sola, fa il 7,1% dell’uso. La sfilata dei paesi somiglia comunque a quella di Pen: tre persone su quattro vivono in un paese sotto la media mondiale, e la media passa fra il minuto 45 e il 46. In testa ci sono Australia e Singapore, che usano Claude circa sei volte più di quanto peserebbe la loro popolazione. Fatta 1 la media mondiale, la Francia è a quasi 4, la Germania a 2,4, l’Italia a 1,7. In fondo, Tanzania e Mozambico stanno sotto un decimo.
Il conto va letto con i suoi limiti, che sono grossi. È un solo prodotto fra tanti. Negli archivi mancano Cina e Russia, e mancano i paesi con troppo poche conversazioni perché il dato venga pubblicato: contando questi ultimi a zero, il Gini sale a 0,57. Soprattutto, dentro ogni paese abbiamo dato a tutti la stessa quota, a chi scrive codice dodici ore al giorno e a chi non ha mai aperto la pagina. La disuguaglianza vera è più alta di così, ma quanto più alta non si può sapere da questi dati.
Dove sta la coda
Se la coda lunga non sta fra le nazioni, sta dentro. Lo si vede appena si guarda il denaro invece delle conversazioni. A ottobre 2026 la società di investimento Andreessen Horowitz ha pubblicato, su dati YipitData, quanto spende in AI un campione di consumatori statunitensi. Ad agosto aveva un abbonamento personale a pagamento a ChatGPT, Gemini o Claude il 4,5% del campione. Fra chi paga, chi sta a metà della fila spende 25 dollari al mese, e l’1% in cima ne spende in media 903. Non è il prezzo di un abbonamento: è quanto esce in un mese dalle carte personali per prodotti di AI di ogni genere, e chi sta in cima compra soprattutto strumenti per automatizzare, per costruire prodotti e per il lavoro creativo. Il rapporto li descrive come persone che comprano software per lavorare, più che come consumatori qualunque. Quell’1% fa il 19,5% di tutta la spesa osservata: più della metà inferiore dei paganti messa insieme, che arriva al 16,6%.
Prendiamo quel 4,5% come misura di chi paga. In una sfilata di un’ora, per 57 minuti passa chi non paga niente. I paganti stanno negli ultimi tre minuti scarsi. Chi fa un quinto della spesa passa nell’ultimo secondo e mezzo. È la figura di Pareto quasi da manuale: la folla intorno ai 25 dollari, pochissimi molto lontano. La spesa non è la capacità, e lo stesso rapporto avverte che i dati vengono da un campione di ricevute, non da un censimento, e riguardano solo gli Stati Uniti. Ma è la prima misura in cui si vede la forma.
Dove invece si misura il risultato, e lo si misura su qualcosa che non ha un tetto, la forbice si apre. È il caso meno citato. In Kenya Nicholas Otis e colleghi hanno dato a sorte un assistente basato su GPT-4 a piccoli imprenditori e hanno guardato ricavi e profitti. In media non è cambiato niente che si possa distinguere dal caso. Ma chi andava già bene potrebbe aver guadagnato oltre il 15%, e chi andava male ha fatto quasi il 10% peggio.
Che cosa hanno fatto di diverso? Non le domande: quelle erano simili, e simili i consigli ricevuti, una ventina a testa. Cambiavano i consigli scelti e messi in pratica. Chi andava male ha seguito soprattutto i consigli buoni per chiunque, come abbassare i prezzi e fare pubblicità. Chi andava bene ha cercato con l’assistente cambiamenti su misura per la propria attività: un modo di avere corrente durante i blackout, un detersivo nuovo e richiesto per un autolavaggio. È un’analisi esplorativa, e gli autori la presentano come la spiegazione più plausibile, non come una prova. Se regge, dice che cosa c’è sopra il gradino: la macchina dà a tutti consigli simili, e la differenza la fa il giudizio con cui si sceglie.
Il confronto con gli esperimenti del pavimento insegna qualcosa su come si misura. Lì il risultato è di solito un voto, e un voto ha un massimo: chi parte da otto non può guadagnare quanto chi parte da quattro. In una scala chiusa una coda lunga non può comparire. Può comparire solo dove il risultato non ha un tetto: i ricavi, la spesa, il numero di cose fatte.
E c’è una coda che in queste misure non entra affatto, quella di chi la tecnologia la possiede. Basta guardare da dove vengono i numeri di questo articolo. La quota di chi usa l’AI la stima Microsoft dai propri prodotti. La mappa dell’uso per paese la pubblica Anthropic dalle proprie conversazioni. I dati sulla sfilata li ha in mano chi sta in cima alla sfilata.
La media che non descrive nessuno
Rimettiamo insieme i pezzi. La folla dell’AI, oggi, non è una campana spostata verso l’alto. Quattro persone su cinque stanno a zero. Chi è salito sta su un gradino che è quasi lo stesso per tutti, perché lo dà la macchina. Pochi, da quel gradino, vanno molto lontano. In una folla fatta così la media si può calcolare, ma non è il posto di nessuno: sta sopra quasi tutti e molto sotto i pochi che la alzano. È questo, detto con precisione, l’oblio della media. La mediocrità non è sparita: è il numero con cui la chiamavamo che ha smesso di indicarla.
Il gradino uguale per tutti ha un costo, e lo misurano gli stessi esperimenti. Nello studio sui consulenti le idee di chi usava GPT-4 erano migliori e tendevano a somigliarsi di più. In un esperimento sulla scrittura di racconti, Anil Doshi e Oliver Hauser trovano la stessa cosa: con i suggerimenti del modello i racconti vengono giudicati più creativi e meglio scritti, soprattutto quelli degli autori meno creativi, e si assomigliano di più fra loro. E quando i modelli vengono addestrati sui testi prodotti da altri modelli, ha mostrato su Nature il gruppo di Ilia Shumailov, spariscono le code della distribuzione, cioè i casi rari. La macchina produce il probabile. Quello che dimentica sono gli estremi.
C’è infine un punto in cui l’oblio della media smette di essere un modo di dire e diventa un prezzo. Anaïs Galdin e Jesse Silbert hanno studiato le candidature su Freelancer.com, una grande piattaforma di lavoro a progetto. Prima dei modelli linguistici chi assumeva era disposto a pagare di più i candidati che scrivevano una proposta su misura: scriverla costava fatica, e la fatica diceva qualcosa di chi la faceva. Dopo, no. Una lettera ben scritta ce l’hanno tutti, quindi non distingue più nessuno.
Nel loro modello, in un mercato in cui lo scritto non segnala più niente, i lavoratori del quinto migliore vengono assunti il 19% di meno e quelli del quinto peggiore il 14% di più. È una simulazione costruita sui dati, non un conteggio, e nella versione che abbiamo letto lo studio è un documento di lavoro. Ma il meccanismo è quello: quando il livello medio è gratis, smette di essere un’informazione.
Che cosa guardare
Galton cercava una legge dell’eredità e trovò una proprietà del caso. La lezione vale ancora, e vale due volte. Vale per leggere gli studi: ogni volta che qualcuno dice che i più deboli sono migliorati di più, la prima domanda è rispetto a che cosa, e se accanto c’era un gruppo di confronto. E vale per la parola. «In media con l’AI si lavora meglio» è una frase che può essere vera e descrivere lo stesso una folla che non esiste, perché in questa folla la media non sta dove sta la gente.
I numeri da guardare sono altri tre. Quanti stanno a zero, e se diminuiscono: oggi sono quattro su cinque, e fra nord e sud del mondo la distanza cresce. Dove sta la mediana, cioè la persona a metà della sfilata, che per ora è a zero anche lei. E quanto è lunga la coda là dove il risultato non ha un tetto, che è la misura che quasi nessuno pubblica.
La regressione verso la mediocrità presupponeva un centro affollato a cui tornare. Nella sfilata dell’intelligenza artificiale, per adesso, a metà dell’ora non passa nessuno di statura media. Passano persone che la macchina non l’hanno mai accesa.
I commenti sono riservati agli iscritti.
Accedi per commentareNon hai un account? Registrati, è gratis.