
Al pronto soccorso ogni paziente riceve un colore prima ancora di vedere un medico: bianco, verde, giallo, rosso. Il triage serve a decidere chi va visitato prima e da chi. Ma lascia anche una traccia preziosa, di cui di solito ci si accorge solo dopo: un registro in cui, accanto a ogni caso, c’è una stima di quanto fosse grave e il racconto di come è andata. Uno specializzando che dovesse imparare il mestiere da quel registro saprebbe già da dove cominciare, dai codici verdi, e quando passare ai rossi.
È l’idea di NeoHorse-1: Towards Recursive Self-Improvement via Agentic Post-Training with Routing Harness, depositato su arXiv l’8 settembre 2026 (2609.08183) e in questi giorni fra i paper in tendenza su Papers with Code. Lo firma il NeoHorse Team: dei 36 autori, 23 sono di TokenRhythm Technologies, gli altri di Infinigence AI, Tsinghua, l’Università di Pechino, la Chinese University of Hong Kong, Alibaba e due società d’investimento (Visionplus Capital, WX Capital); gli autori di riferimento sono Yu Wang (Tsinghua) e Yunhe Wang (TokenRhythm). Il paper rimanda a una collezione su Hugging Face e a un repository GitHub, github.com/TokenRhythm/NeoHorse.
Un registro che esiste già
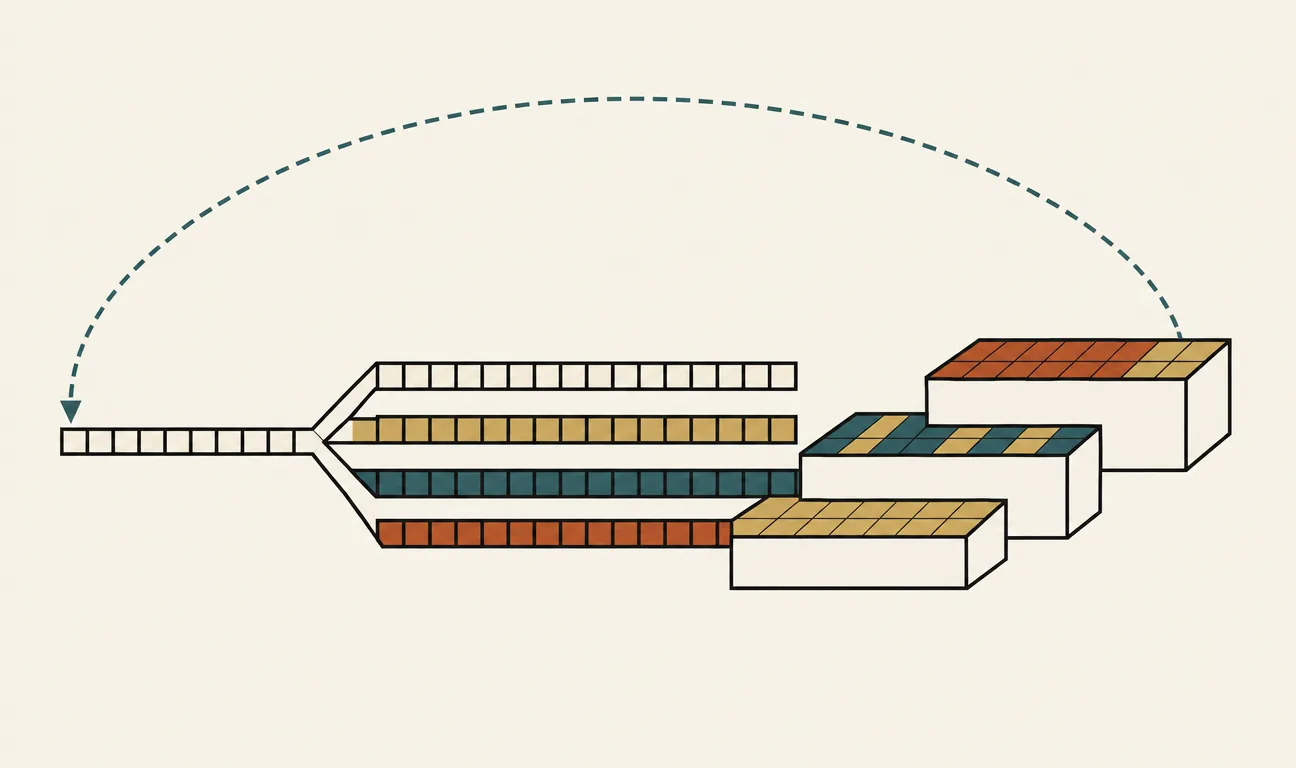
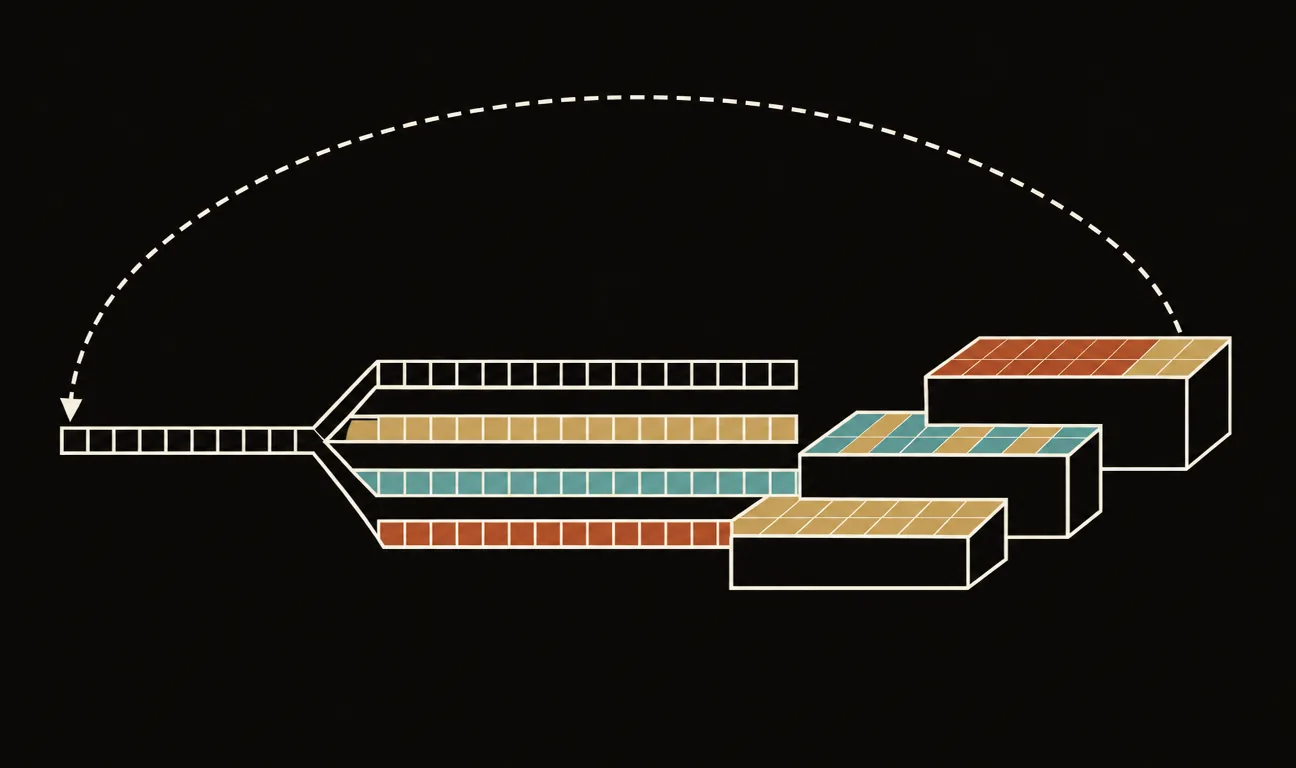
Un agente non è solo il modello. Intorno ci sono gli strumenti, il contesto, il modo in cui interagisce con l’ambiente: è l’harness. Alcuni harness hanno anche un router, che per ogni richiesta sceglie quale modello di un gruppo eterogeneo deve rispondere. Quello di TokenRhythm, descritto in un lavoro precedente dello stesso gruppo (Agentic Routing, 2607.11399), assegna ogni turno a uno di quattro livelli di servizio: C0 per le richieste semplici e a basso rischio, C1 per il caso generale, C2 per il ragionamento e l’esecuzione in più passi, C3 per la massima capacità o affidabilità.
La tesi del paper è che questo apparato produce, come effetto collaterale, proprio ciò che serve a un modello per migliorarsi. Di ogni interazione restano tre cose: la traiettoria completa (richieste, risposte del modello, chiamate agli strumenti, osservazioni dell’ambiente, tentativi di recupero), la previsione del router, turno per turno, su quanta capacità servisse, e l’esito. Il corpus principale è fatto di traiettorie di questo tipo, «dell’ordine di $10^5$–$10^6$», affiancate da dati pubblici per coprire istruzioni, ragionamento, codice, uso di strumenti e preferenze.
Il nome «auto-miglioramento ricorsivo» viene da qui: il modello addestrato su quel registro rientra nel gruppo dietro il router, produce nuove traiettorie, e i punti deboli misurati in valutazione spostano il mix di dati del giro successivo verso le zone in cui rende meno. Quello che il sistema impara a fare, scrivono gli autori, orienta ciò da cui imparerà dopo.
Un curriculum ordinato dal triage
Prima di diventare materiale di studio, le traiettorie passano tre filtri. Il primo è strutturale e fatto con regole riproducibili: ogni chiamata a uno strumento deve avere il suo risultato, gli eventi devono essere in ordine causale, non devono esserci risposte mancanti. Le traiettorie ambigue finiscono in quarantena, quelle recuperabili a metà contribuiscono solo con i pezzi chiusi. Il secondo è semantico: sei dimensioni giudicate separatamente (raggiungimento dell’obiettivo, rispetto delle istruzioni, uso degli strumenti, coerenza con le prove, recupero dagli errori, conclusione), ciascuna con un verdetto fra PASS, WARN, FAIL e «non valutato». Un dettaglio onesto: una chiamata al giudice interrotta non diventa mai un voto positivo. Il terzo filtro etichetta le sottoscene, gruppi di turni che condividono un obiettivo locale, lungo tre assi: che cosa fa l’utente, che cosa si aspetta, che cosa è successo davvero.
Poi viene l’ordine. L’unità di addestramento è il turno dell’utente, con il ragionamento intrecciato alle chiamate agli strumenti e il contesto dell’harness conservato; la perdita si calcola solo sulle risposte dell’assistente nel turno corrente. Per decidere quando presentare ogni esempio, gli autori non usano il modello che ha effettivamente risposto, perché quella scelta risente anche di forzature da parte dell’utente, disponibilità del servizio e politiche di deployment. Riusano invece la stima del router, ricalcolata sul contesto disponibile prima della prima risposta supervisionata. Il router assegna un livello $k_i$ e una distribuzione $\pi_{i,k}$ sui quattro livelli; la versione «morbida» del punteggio è la media pesata:
$$s_i = \sum_{k=0}^{3} k\,\pi_{i,k}$$
che distingue due esempi con lo stesso livello assegnato ma un diverso peso sugli altri livelli. L’addestramento procede in tre tappe di circa un terzo degli esempi ciascuna, verso punteggi più alti, ma una parte degli esempi facili viene tenuta da parte per le tappe finali: così la fine dell’addestramento non è dominata solo dai casi più impegnativi. L’ottimizzatore e il learning rate non ripartono fra una tappa e l’altra.
Qui si dà per scontato che cosa succede a un modello dopo il pre-addestramento: il fine-tuning supervisionato, le preferenze, la ragione per cui un modello base non è ancora un assistente. Il libro lo costruisce passo per passo.
Il fine-tuning supervisionato ha però un difetto noto: impara da risposte registrate, mentre in uso il modello continua le proprie. Per questo lo stesso curriculum viene esteso alla distillazione on-policy: lo studente genera la risposta a partire da contesti ordinati per punteggio, e un insegnante fisso fornisce, token per token, la distribuzione che avrebbe prodotto lui. Lo studente minimizza la divergenza di Kullback-Leibler inversa, $D_{\mathrm{KL}}(\tilde P_\theta \,\|\, \tilde Q)$, calcolata per compattezza sui $K$ token più probabili per lo studente più un contenitore unico per il resto della massa di probabilità.
Perché un modello piccolo impari da uno grande guardandone le probabilità e non solo le risposte, e che cosa si guadagna, è il tema di un capitolo del libro.
I numeri
I modelli sono due, costruiti su Qwen3.5-4B e Qwen3.5-9B, e valutati su dieci benchmark: sei agentici (QwenClawBench, WorkBuddy Bench, PinchBench, VitaBench, BFCL V4, $\tau^2$-Bench), due di codice (HumanEval, LiveCodeBench v6) e due di rispetto delle istruzioni (IFEval, IFBench). La media semplice sui dieci sale per entrambi, e il 4B addestrato arriva così a meno di un punto dal 9B di partenza. Nel confronto con altri modelli aperti della stessa taglia, NeoHorse-1-4B ha la media più alta della sua tabella, e il 9B supera anche Muse-Glimmer-30B, inserito come riferimento.
| Modello | Media |
|---|---|
| Taglia del 4B | |
| Qwen3.5-4B, di partenza | 58,94 |
| NeoHorse-1-4B | 64,87 |
| Nanbeige-4.2-3B | 62,31 |
| Spark-X2.5-4B | 62,22 |
| Taglia del 9B | |
| Qwen3.5-9B, di partenza | 65,60 |
| NeoHorse-1-9B | 69,04 |
| Muse-Glimmer-30B | 67,86 riferimento |
Fra i singoli risultati, HumanEval del 4B passa da 87,20 a 96,95 e LiveCodeBench v6 da 53,71 a 59,43. Sul 9B, però, il guadagno si concentra sui compiti agentici e su HumanEval (da 92,68 a 98,17): LiveCodeBench e IFBench restano identici al modello base, e IFEval scende di poco, da 89,46 a 89,09.
L’esperimento più interessante è un altro. Partendo dallo stesso Qwen3.5-4B, con lo stesso curriculum, lo stesso seme e budget di addestramento «molto simili», gli autori confrontano i dati del loro harness con Toucan, un dataset pubblico di traiettorie sintetiche. I dati dell’harness vincono su tutti e cinque i benchmark confrontabili, con 6,26 punti di media in più; gli scarti maggiori sono su $\tau^2$-Bench (+11,31) e HumanEval (+8,54). Il paper non lo sottolinea, ma i suoi numeri dicono anche un’altra cosa, se si guarda a Qwen3.5-4B così com’è: l’addestramento su Toucan finisce sotto il punto di partenza, quello sui dati dell’harness lo supera di poco più di un punto. Il vantaggio è netto su Toucan, molto meno sul modello base.
| Qwen3.5-4B | Media |
|---|---|
| Così com’è | 69,31 |
| Addestrato su Toucan | 64,32 |
| Addestrato sui dati dell’harness | 70,57 |
Aumentando la quantità di dati dell’harness, in sottoinsiemi annidati fino a circa dieci milioni di token supervisionati unici, la media sui cinque benchmark sale con regolarità da 69,31 a 71,45.
Le tracce commentate nel paper, scelte dagli autori come rappresentative, mostrano che cosa cambia e che cosa no. In un compito di pianificazione, Qwen3.5-4B non apre l’email di un responsabile con un vincolo aggiornato e produce un calendario non valido; NeoHorse-1-4B la legge, ricalcola e verifica. Ma la taglia conta ancora: in un compito di analisi dati, scoperto che pandas non è installato, NeoHorse-1-4B insiste a installarlo, a leggere i CSV a mano, a rattoppare script, e il rapporto non arriva; NeoHorse-1-9B ripiega sui moduli standard di Python e consegna il rapporto, con circa il 71% di richieste al modello in meno e l’84% di token in meno. È il tipo di comportamento, correggere la strategia davanti a un ostacolo, che i numeri aggregati non mostrano.
I limiti
Il giro è stato fatto una volta. Il titolo punta all’auto-miglioramento ricorsivo, ma gli autori stessi scrivono che i risultati vanno letti come «un primo tentativo e non una dimostrazione definitiva»: il ciclo valutazione–selezione–aggiornamento è stato percorso una sola volta. Se i guadagni si accumulino, o si esauriscano, rimettendo il modello nell’harness per più generazioni resta da provare. Per ora NeoHorse-1 è un buon esempio di post-training su dati d’uso reali, più che di un sistema che si migliora da solo.
Manca la scomposizione del merito. Il paper non confronta il curriculum con un addestramento senza ordine, né il solo fine-tuning con la distillazione, e non dice quale combinazione dei due abbia prodotto i modelli finali: il confronto con Toucan isola la fonte dei dati, ma non si sa quanto dei punti in più venga dall’ordinamento del router e quanto dall’insegnante. L’insegnante della distillazione, inoltre, non è nominato, e il numero esatto di token del corpus è rinviato a un «manifesto di addestramento» che nel testo non compare.
Si gioca in parte in casa. QwenClawBench e PinchBench sono valutati con OpenSquilla, l’harness di TokenRhythm, uno di quelli da cui provengono le traiettorie di addestramento. Il rischio di contaminazione è trattato (gli esempi che si sovrappongono ai benchmark vengono rimossi), ma un modello addestrato sulle tracce di un harness può trovarsi avvantaggiato proprio lì, e il paper non misura quanto. PinchBench e VitaBench sono misurati con un’esecuzione sola, e per VitaBench il simulatore d’utente e il giudice sono stati sostituiti con DeepSeek-V4-Flash perché i modelli raccomandati non sono più disponibili.
Dati d’uso, e nessuna parola su chi li ha prodotti. Le traiettorie vengono da harness in servizio su compiti reali. Il paper non dice nulla su consenso, anonimizzazione o conservazione, ed è una domanda che chiunque voglia replicare l’idea in Europa dovrà porsi prima di tutte le altre.
Perché conta adesso
Chi mette in produzione un router fra più modelli lo fa di solito per ragioni di costo: mandare al modello grande solo le richieste che lo meritano. NeoHorse-1 suggerisce che quel registro di decisioni ha un secondo valore, forse maggiore: è una stima di difficoltà già pronta, legata a compiti veri, che nessuno ha dovuto etichettare a mano. Come il registro del triage, serve a chi smista oggi e a chi deve imparare domani. Se poi il giro regga davvero, generazione dopo generazione, è la parte che il paper annuncia e che il prossimo dovrà misurare.
I commenti sono riservati agli iscritti.
Accedi per commentare