
Un medico davanti a una febbre che non passa non prova una cura dopo l’altra sperando nella fortuna. Fa una diagnosi differenziale: scrive l’elenco delle cause possibili, ordina gli esami che ne escludono il maggior numero, e quando un esame torna negativo non lo butta via. Lo annota, perché «non è un’infezione batterica» restringe il campo quanto una risposta positiva. Dopo una settimana, la cartella clinica vale più di qualunque singolo esame: dice che cosa è stato provato, che cosa è stato escluso e perché.
Gli agenti che scrivono codice per ore, oggi, somigliano più al paziente impaziente che al medico. Provano, falliscono, riprovano, e quello che hanno imparato da un tentativo sta in una finestra di contesto che a un certo punto viene compressa o dimenticata. È il problema da cui parte Toward Generalist Autonomous Research via Hypothesis-Tree Refinement, depositato su arXiv il 10 giugno 2026 (2606.11926). Lo firmano diciotto autori della Gaoling School of Artificial Intelligence della Renmin University of China e di Microsoft Research, con Jiajie Jin e Yuyang Hu primi autori a pari merito e Zhicheng Dou come autore di riferimento. Il sistema si chiama Arbor, il codice è pubblico, e gli autori avvertono che si tratta di un rapporto tecnico «vivo», che aggiorneranno.
Migliorare un artefatto, non scrivere un paper
Diversi sistemi di «ricerca automatica», a partire da The AI Scientist nel 2024, portano un’idea fino alla stesura di un articolo. Arbor fa una cosa più circoscritta e più misurabile, che gli autori chiamano Autonomous Optimization (AO): si parte da un artefatto già funzionante, un obiettivo scritto in linguaggio naturale e due valutatori, e l’agente deve migliorare l’artefatto sperimentando, senza che un umano scelga il passo successivo. Formalmente il problema è una quadrupla
$$P = (M_0,\ O,\ E_{\text{dev}},\ E_{\text{test}}),$$
dove $M_0$ è il materiale di partenza (codice e dati), $O$ dice che cosa significa «meglio», $E_{\text{dev}}$ è il valutatore che l’agente può consultare liberamente e $E_{\text{test}}$ quello tenuto da parte. Il risultato cercato è il candidato con il miglior punteggio di test,
$$M^\star = \arg\max_{M’ \in \mathcal{A}} S_{\text{test}}(M’),$$
con il vincolo, dichiarato, che ipotesi e scelte di implementazione non usino il test come oracolo di esplorazione. La distinzione fra le due valutazioni è il cuore metodologico del paper, e ci torneremo, perché è anche il suo punto più delicato.
Perché ottimizzare a lungo su un insieme di valutazione finisce per adattarsi a quell’insieme, e a che cosa serve tenere da parte un test che non si guarda: la divisione fra validazione e test è spiegata nel libro.
Una cartella clinica a forma di albero
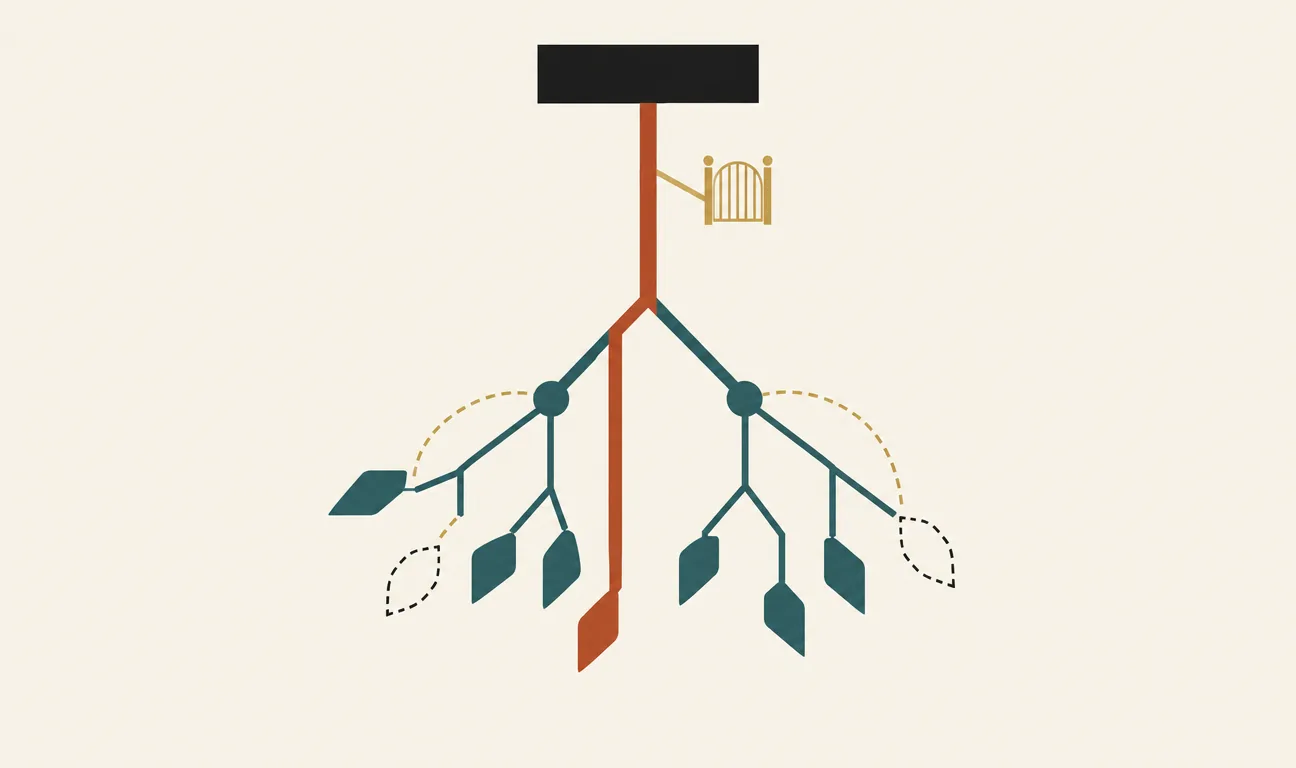
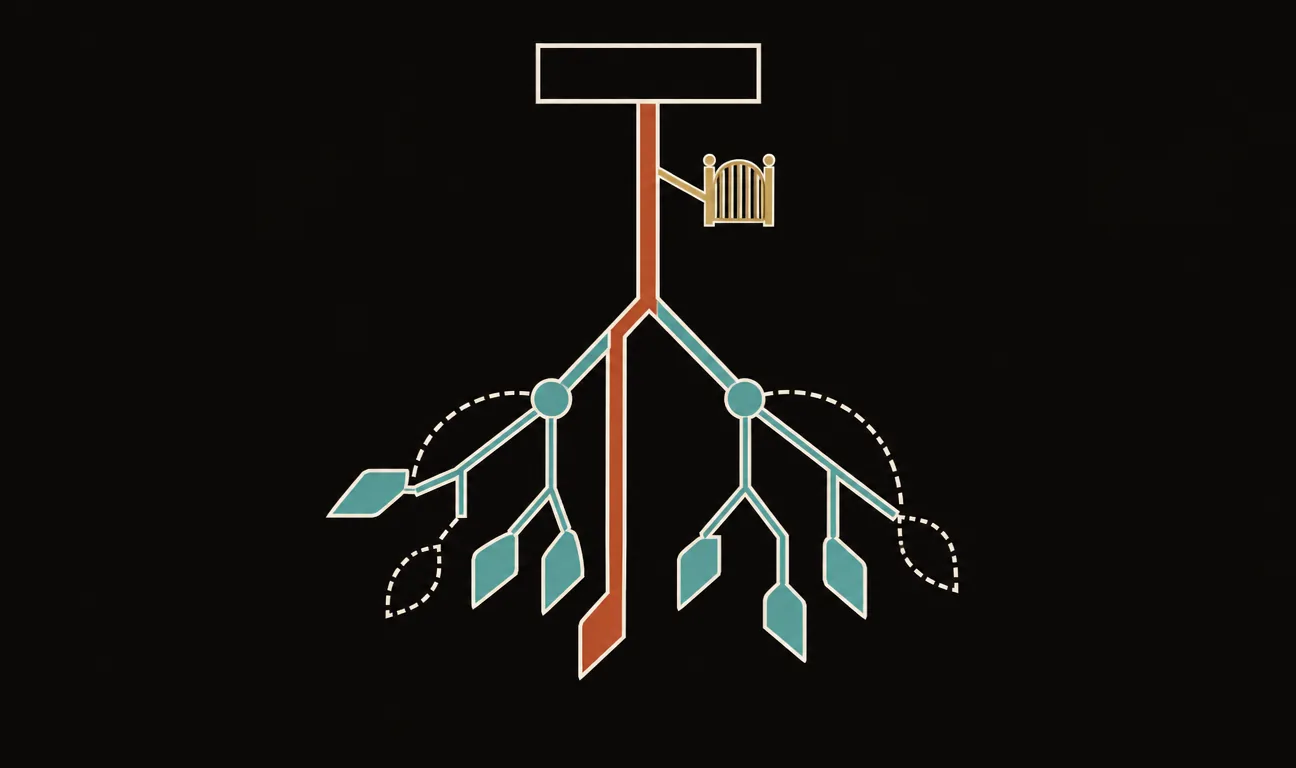
L’idea centrale si chiama Hypothesis Tree Refinement (HTR). Lo stato della ricerca non è la conversazione dell’agente ma un albero che sopravvive a tutta la corsa. Ogni nodo è una terna
$$n = \langle h_n,\ \iota_n,\ \mu_n \rangle:$$
un’ipotesi $h_n$ che si può confermare o falsificare, un’intuizione $\iota_n$ che riassume che cosa si è imparato, e metadati $\mu_n$ con lo stato del nodo, il punteggio di sviluppo e il riferimento al ramo git che realizza l’idea. I nodi vicini alla radice sono direzioni larghe (nel compito di matematica, per esempio, «verifica delle risposte» o «calibrazione della difficoltà»), le foglie sono interventi concreti da implementare. L’albero fa tre mestieri insieme: è la frontiera di ricerca, la memoria di lungo periodo e il registro che permette di risalire da ogni modifica all’ipotesi e alla prova che l’hanno motivata.
Il lavoro è diviso in due. Un coordinatore a vita lunga possiede l’albero e ripete sei passi: osserva lo stato, propone ipotesi figlie sotto un nodo scelto, seleziona le foglie da provare, le spedisce agli esecutori, fa risalire le lezioni, decide. Gli esecutori vivono il tempo di un esperimento: ciascuno riceve un’ipotesi e le intuizioni degli antenati, lavora in un worktree git isolato, corregge i propri errori di implementazione, e restituisce quattro cose: punteggio, risultato fattuale, lezione distillata, riferimento al ramo. Una regola conta più delle altre: l’esecutore può riparare il codice ma non cambiare l’ipotesi quando la metrica ristagna, altrimenti il punteggio non direbbe più niente sul nodo a cui è attaccato.
Il passo decisivo è la risalita. Quando un esperimento torna, la sua lezione non si ferma alla foglia: il coordinatore aggiorna gli antenati, e un’osservazione locale («l’interfaccia dei dati non combacia») può diventare un vincolo su un’intera direzione e poi un presupposto globale. Le ipotesi successive nascono condizionate da questa memoria: le intuizioni confermate diventano punti di partenza, i rami potati diventano divieti.
Come si costruisce il ciclo di un agente, dalla memoria alla pianificazione, e perché valutarlo è difficile: le architetture degli agenti sono raccontate nel libro.
Sei compiti veri, e una gara di Kaggle in miniatura
Gli autori costruiscono sei compiti a partire da lavori di ricerca reali: progettare un ottimizzatore che porti NanoGPT alla loss obiettivo in meno passi (partendo dal Muon già ottimizzato del benchmark), migliorare l’architettura del codebase autoresearch di Karpathy, migliorare l’harness di un agente su Terminal-Bench 2.0 e quello di un agente di ricerca web su BrowseComp, e migliorare due pipeline che generano dati sintetici, domande per agenti di ricerca e problemi di matematica in stile AIME. Gli avversari sono Codex con GPT-5.5 e Claude Code con Claude Opus 4.6, lanciati in modalità /goal con lo stesso materiale, lo stesso budget e un limite di 48 ore. Arbor usa Claude Opus 4.6 sia per il coordinatore sia per gli esecutori, con 20 cicli e profondità massima 2.
Arbor ottiene il miglior punteggio di test su tutti e sei. Le distanze più larghe sono su BrowseComp e sulla sintesi di problemi di matematica, dove la metrica (il divario medio fra pass@4 e pass@1, che premia i problemi non risolti al primo colpo ma risolvibili con qualche tentativo) sale di 19,79 punti contro 5,21 e 7,29. Altrove i margini sono stretti, e sull’ottimizzatore Codex resta fermo.
| Sistema | Risultato |
|---|---|
| BrowseComp · accuratezza, più alta è meglio | |
| Partenza | 45,33 |
| Arbor | 67,67 |
| Codex | 50,00 |
| Claude Code | 53,33 |
| Ottimizzatore per NanoGPT · passi, meno sono meglio | |
| Partenza | 3325 |
| Arbor | 3237,5 −2,63% |
| Claude Code | 3287,5 |
| Architettura di autoresearch · loss, più bassa è meglio | |
| Partenza | 1,098 |
| Arbor | 1,028 |
| Claude Code | 1,033 |
Il caso più istruttivo è Terminal-Bench. Claude Code ha il miglior punteggio di sviluppo (75,00) e sul test scende a 71,70; Arbor ha uno sviluppo più basso (72,22) e il miglior test, 77,36. Per gli autori è il segno che il punteggio di sviluppo serve a guidare la ricerca ma non basta ad ammettere un miglioramento: da qui il cancello sul test.
Su MLE-Bench Lite, una selezione di gare di machine learning in stile Kaggle giudicate con il protocollo ufficiale, Arbor con Gemini-3-Flash arriva all’81,82% di gare con medaglia, lo stesso valore del miglior sistema con quel modello (AI-Scientist), ma con più ori; con GPT-5.5 sale all’86,36%, con il 77,27% di ori. L’ablazione, fatta qui con Claude Opus 4.6, è il dato più interessante: senza albero (esperimenti in una coda piatta) le medaglie scendono dall’81,82 al 63,64%; tenendo l’albero ma spegnendo la risalita delle lezioni scendono ancora di più, al 54,54%. Un albero senza memoria organizza gli esperimenti, ma non insegna niente a quelli dopo.
Due verifiche completano il quadro. L’harness ottimizzato su BrowseComp, congelato e portato su compiti mai visti, migliora anche HLE (da 25,50 a 31,50%) e DeepSearchQA (da 61,00 a 69,00%, con deviazioni standard intorno ai 6,5 punti). E il conto dei token, fra 20 e 43 milioni per corsa, è della stessa scala dei due avversari: il guadagno, sostengono gli autori, viene da come si spende il budget, non da quanto.
Che cosa resta da verificare
Il test entra nel ciclo. Quando una foglia supera sullo sviluppo il migliore corrente di almeno il 5% (la soglia indicata in appendice), il cancello di fusione la valuta su $E_{\text{test}}$ e la ammette solo se lo batte anche lì; il punteggio riportato alla fine è poi quello dello stesso $E_{\text{test}}$. Il test non genera ipotesi, ma seleziona, e selezionare più volte sullo stesso insieme rende ottimista il numero finale: è il fenomeno che il paper mostra sul set di sviluppo. Il testo, poi, non è coerente con sé stesso: l’appendice su Terminal-Bench dice che il test si valuta una volta sola a fine corsa, mentre l’algoritmo lo chiama a ogni candidata alla fusione. E su Terminal-Bench le istruzioni del compito, le stesse per tutti i metodi, consentono di lanciare il test dopo un miglioramento significativo: se e quanto l’abbiano fatto Codex e Claude Code non è riportato. Il trasferimento su HLE e DeepSearchQA è la prova più pulita proprio perché quei dati non sono mai entrati nella corsa.
I test sono piccoli. Su Terminal-Bench il test ha 53 compiti: il vantaggio di Arbor su Claude Code sono tre compiti. MLE-Bench Lite conta 22 gare, e in una corsa singola ogni gara vale 4,5 punti: le due ablazioni restano indietro di quattro e di sei gare. Il protocollo dichiara tre ripetizioni per metodo, ma la tabella principale riporta un solo numero per cella, senza dispersione.
L’idea grande resta umana. Lo ammettono gli autori: Arbor rende quando l’obiettivo si migliora con una sequenza di rifiniture concrete, meno quando serve una riformulazione del problema. Sull’architettura l’albero ha riconosciuto che i ritocchi a una manopola alla volta rendevano sempre meno e che serviva una mossa algoritmica più grande, ma trovarla dipendeva ancora da un giudizio esterno, non da qualcosa che l’albero sapesse generare. Scelta dell’artefatto, della metrica e dei valutatori restano decisioni di chi imposta il compito. Il paper elenca anche i limiti della suite di compiti, degli obiettivi scalari, delle capacità dei modelli e del costo della ricerca.
Perché conta adesso
La corsa sugli agenti si misura sempre più spesso in ore di autonomia: quanto a lungo un sistema lavora senza che nessuno lo guardi. Arbor sposta la domanda su che cosa resta in mano dopo quelle ore. Un albero in cui ogni fusione ha un’ipotesi, un ramo git e un punteggio è, prima ancora che un motore di ottimizzazione, un registro che un umano può rileggere e contestare, come la cartella clinica del medico. Che i numeri reggano con un test davvero intoccato è la verifica che manca; il codice pubblico permette a chiunque di farla.
I commenti sono riservati agli iscritti.
Accedi per commentare