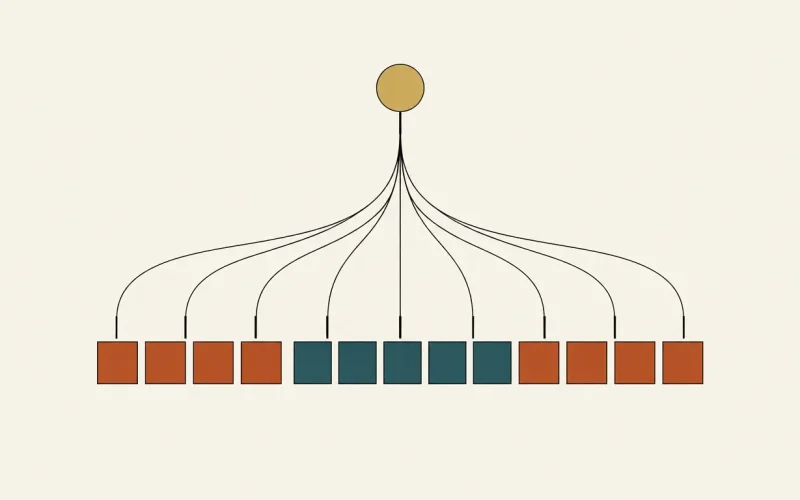
Free Transformer: dare al Transformer una variabile latente per pensare prima di scrivere
François Fleuret aggiunge al decoder Transformer una variabile casuale latente, appresa senza supervisione con un autoencoder variazionale. Un ingranaggio in…
Rilettura accessibile di un paper
François Fleuret aggiunge al decoder Transformer una variabile casuale latente, appresa senza supervisione con un autoencoder variazionale. Un ingranaggio in…
Yann LeCun e due colleghi portano nel linguaggio l'obiettivo di addestramento che ha dato i risultati migliori nella visione: non…
Un commento di quattro pagine sostiene che il "collasso del ragionamento" misurato in uno studio molto discusso sia un artefatto…
Un gruppo di fisici propone di rimpicciolire i modelli linguistici non tagliando neuroni, ma le correlazioni tra i loro pesi,…
Un gruppo di Tsinghua misura i modelli "ragionanti" con pass@k invece che sulla media. La scoperta scomoda: il reinforcement learning…
Comprimere un modello a quattro bit fa risparmiare memoria e calcolo, ma spesso ne intacca l'accuratezza. Un report tecnico di…
Prior Labs pubblica la nuova generazione del suo modello per dati tabellari: una rete che predice da una tabella senza…
Un paper di OpenAI del 2025 sostiene che le allucinazioni non sono un mistero: nascono come normali errori statistici durante…
Nell'ottobre 2024 Anthropic ha dato a Claude un mouse e una tastiera: guarda lo schermo con uno screenshot, decide dove…
Un modello linguistico non vede nulla: legge numeri. LLaVA mostra che per dargli la vista basta un pezzo sorprendentemente semplice:…