
Chiedi a un modello linguistico in che anno è uscito il primo film di un regista poco noto. Se lo lasci ragionare da solo, spesso costruisce un discorso impeccabile — «ha esordito a metà degli anni Novanta, probabilmente nel 1995» — e ti consegna con la stessa sicurezza sia le date vere sia quelle che ha inventato lungo la strada. Il ragionamento fila, la conclusione è falsa. È il problema classico del chain-of-thought: una catena di pensieri coerente può portare dritta a un errore, perché non tocca mai la realtà.
Il ciclo dell’agente, il tool use, ReAct e la riflessione — con un agente giocattolo in Python — stanno nel libro.
Nell’ottobre 2022 un gruppo di ricercatori di Princeton e Google — Shunyu Yao e colleghi — pubblica un paper che propone una correzione semplice da enunciare e feconda nelle conseguenze: e se, tra un pensiero e l’altro, il modello potesse anche fare qualcosa? Cercare una parola su Wikipedia, aprire un cassetto in un ambiente simulato, cliccare un prodotto su un sito. Il metodo si chiama ReAct, crasi di Reasoning e Acting, e sta alla radice di quasi tutto ciò che oggi chiamiamo «agente».
Due bravure tenute in stanze separate
Fino a quel momento la letteratura aveva coltivato le due capacità in isolamento. Da un lato il ragionamento: prompt come «ragiona passo dopo passo» che spingono il modello a esplicitare i passaggi intermedi prima di rispondere. Dall’altro l’azione: sistemi che generano piani da eseguire in un ambiente, ma senza un vero pensiero a monte. Erano due filoni di ricerca che si citavano poco e non si parlavano.
La tesi di Yao e colleghi è che questa separazione sia il difetto, non un dettaglio. Il ragionamento puro non ha modo di verificarsi: allucina un fatto e ci costruisce sopra, propagando l’errore fino in fondo. L’azione pura non ha modo di adattarsi: se un passo fallisce, non c’è un pensiero che riconosca l’eccezione e cambi piano. Ognuna delle due ha esattamente la medicina di cui l’altra ha bisogno.
Il ragionamento senza azione si convince delle proprie invenzioni; l’azione senza ragionamento si perde al primo imprevisto. ReAct li costringe a controllarsi a vicenda.
L’intreccio: pensa, agisci, osserva, ripensa
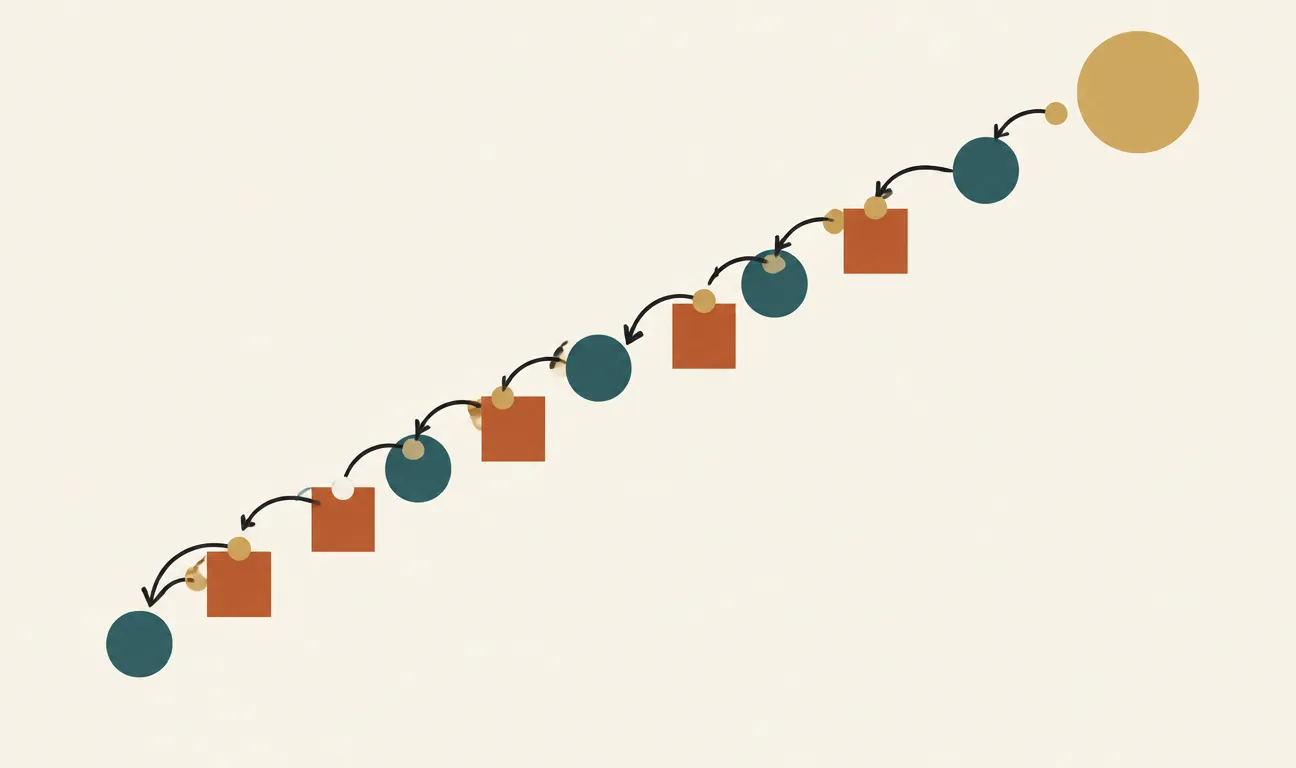
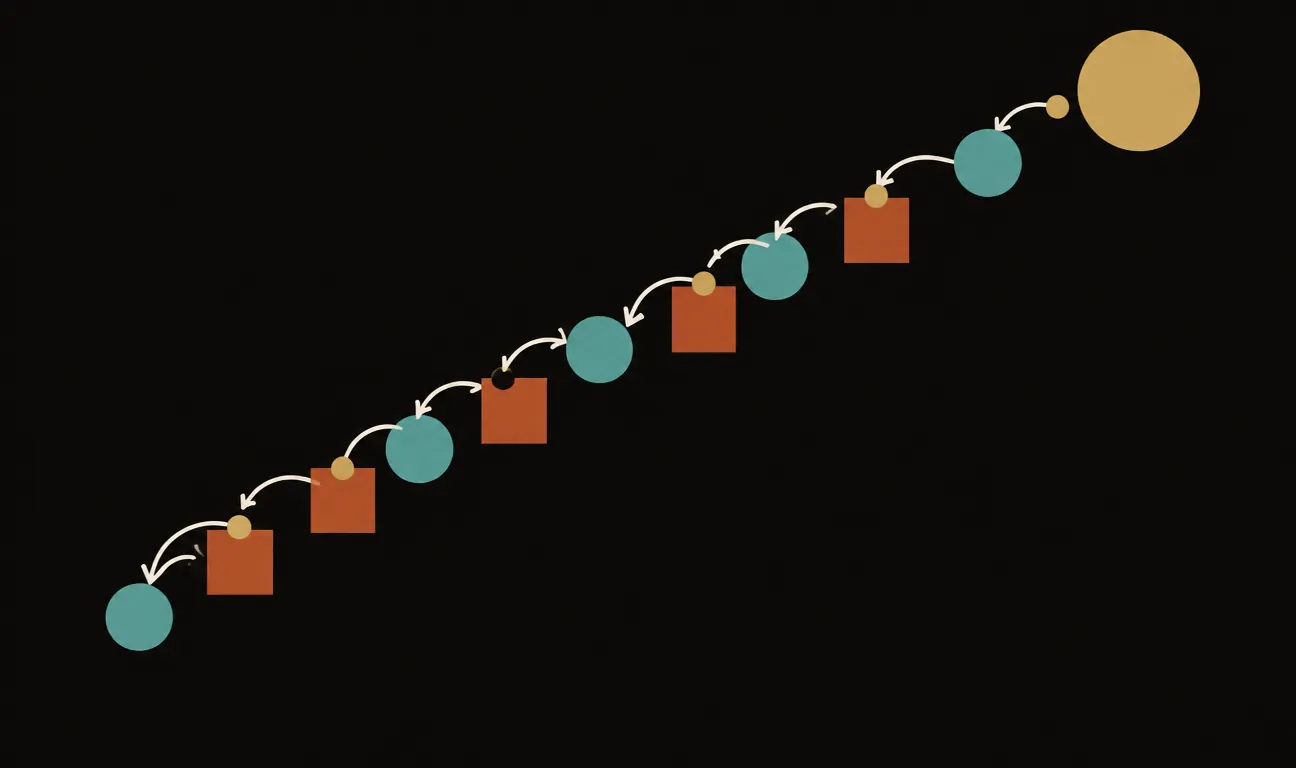
Il meccanismo è un ciclo. Il modello produce un pensiero in linguaggio naturale («mi serve sapere con quale film ha esordito questo regista»), poi un’azione in un piccolo vocabolario di comandi («cerca[nome regista]»), e riceve dall’ambiente un’osservazione (il testo restituito da Wikipedia). Quell’osservazione alimenta il pensiero successivo, che decide la prossima azione. E così via, finché il pensiero conclude che ha abbastanza per rispondere.
L’analogia più fedele è il modo in cui un archeologo lavora sul campo, non in poltrona. Non ricostruisce un’intera civiltà a mente e poi la dichiara: formula un’ipotesi, scava in un punto preciso, guarda cosa emerge, e la scoperta gli riscrive l’ipotesi successiva. Pensiero e gesto si correggono a turno. Un ragionamento fatto tutto in una volta, prima di toccare terra, sarebbe soltanto una bella storia. ReAct porta il modello a scavare tra un pensiero e l’altro.
La cosa notevole è quanto poco serva per innescarlo. Nel paper il comportamento non è addestrato: è ottenuto con appena uno o due esempi inseriti nel prompt, che mostrano al modello come si alternano pensieri e azioni. Il resto lo fa la sua capacità di imitare lo schema.
Ogni iterazione alterna un pensiero (terracotta), un’azione verso l’esterno (teal) e l’osservazione che ne torna (ocra). L’osservazione nutre il pensiero seguente: il modello non ragiona a vuoto, ma corregge la rotta a ogni contatto con la realtà, finché ne sa abbastanza per rispondere.
Cosa hanno misurato
Gli autori mettono ReAct alla prova su quattro banchi molto diversi tra loro, ed è questa varietà a rendere il risultato interessante. Due sono compiti di conoscenza: HotpotQA, domande che richiedono di incrociare più fonti, e Fever, verifica di affermazioni vere o false. Qui l’azione consiste nell’interrogare una semplice API di Wikipedia. L’effetto principale non è tanto un salto in classifica quanto la cura dell’allucinazione: agganciando ogni passaggio a un testo reale, il modello smette di inventare i fatti su cui poi ragiona.
Gli altri due sono ambienti di decisione interattiva: ALFWorld, dove si impartiscono comandi per portare a termine faccende in una casa simulata, e WebShop, un finto negozio online in cui bisogna trovare e comprare il prodotto richiesto. Qui i numeri sono netti. Rispetto ai metodi basati su imitazione e apprendimento per rinforzo, ReAct migliora il tasso di successo assoluto del 34% su ALFWorld e del 10% su WebShop — e lo fa, ancora una volta, con appena uno o due esempi nel prompt, contro sistemi addestrati su migliaia di dimostrazioni.
Perché conta più della classifica
Il contributo che è invecchiato meglio non è un punteggio, è una forma. ReAct mostra che le tracce di ragionamento non servono solo a far arrivare il modello alla risposta giusta: rendono il suo percorso leggibile. Quando un agente ReAct sbaglia, puoi rileggere la sequenza di pensieri e azioni e vedere esattamente dove ha deragliato — quale osservazione ha frainteso, quale ipotesi ha tenuto troppo a lungo. È una trasparenza che i metodi solo-azione, opachi per costruzione, non offrono.
Sarebbe disonesto vendere il paper come una soluzione chiusa. ReAct resta prigioniero della qualità del modello che lo esegue: un pensiero sbagliato produce un’azione sbagliata, e nessun ciclo lo salva se il modello di base non è abbastanza capace. Dipende dagli esempi messi nel prompt, e sui compiti di sola conoscenza il vantaggio sui metodi di ragionamento puro è più sfumato di quanto il nome lasci sperare — tanto che nel paper i risultati migliori arrivano combinando ReAct con il chain-of-thought, non sostituendolo.
Eppure lo schema pensiero–azione–osservazione è diventato il vocabolario di fondo della generazione successiva di strumenti: i framework che orchestrano gli LLM, il tool use e il function calling integrati oggi nelle API, gli agenti che navigano, cercano ed eseguono codice. Se lavori con qualunque sistema che «pensa e poi chiama uno strumento», stai usando la discendenza diretta di questo paper. Conoscerne l’origine ti dà l’occhio per capire dove quei sistemi eccellono — e dove, per gli stessi limiti di allora, continuano a inciampare.
Il paper originale
Shunyu Yao, Jeffrey Zhao, Dian Yu, Nan Du, Izhak Shafran, Karthik Narasimhan, Yuan Cao, ReAct: Synergizing Reasoning and Acting in Language Models, 2022, presentato a ICLR 2023. Disponibile su arXiv: arxiv.org/abs/2210.03629.
I commenti sono riservati agli iscritti.
Accedi per commentare