
Chiedete a un modello linguistico quanto fa il 12% di 3,85 miliardi e c’è una buona probabilità che risponda con sicurezza un numero sbagliato. Non perché sia stupido: perché sta prevedendo la cifra più plausibile un carattere alla volta, non calcolandola. È come chiedere a un lettore vorace di fare a mente una divisione lunga: conosce mille libri ma non ha mai imparato a fermarsi e prendere la calcolatrice.
Il ciclo dell’agente, il tool use, ReAct e la riflessione — con un agente giocattolo in Python — stanno nel libro.
Il paper Toolformer: Language Models Can Teach Themselves to Use Tools, pubblicato da un gruppo di Meta AI guidato da Timo Schick nel febbraio 2023, affronta esattamente questa lacuna. La proposta è netta: insegnare a un modello a interrompersi da solo quando serve, chiamare uno strumento esterno — una calcolatrice, un motore di ricerca, un traduttore — leggerne il risultato e riprendere a scrivere come se niente fosse. La parte elegante è che il modello impara a farlo da sé, quasi senza esempi umani.
La cosa che i modelli non sanno fare
Un modello linguistico di grandi dimensioni ha due debolezze note e simmetriche. Da un lato è pessimo in compiti che uno strumento banale svolge alla perfezione: l’aritmetica esatta, le date («che giorno è oggi?»), i fatti puntuali e aggiornati. Dall’altro, tutto ciò che «sa» è congelato al momento dell’addestramento: non può sapere una notizia di ieri, né consultare una fonte.
La soluzione ovvia è dargli accesso a degli strumenti. Il problema è insegnargli quando usarli e come formulare la chiamata: quali parametri passare, dove inserire il risultato nel discorso. Fino a Toolformer, l’approccio tipico era o addestrare con grandi quantità di annotazioni umane, o affidarsi a istruzioni infilate nel prompt. La domanda del paper è più ambiziosa: e se il modello potesse imparare da solo, con pochissima supervisione, quando gli conviene chiamare un tool?
Le chiamate come pezzi di testo
Il primo passo è una scelta di rappresentazione. Una chiamata a uno strumento non è un meccanismo speciale fuori dal linguaggio: è testo, esattamente come tutto il resto. Toolformer la scrive con una notazione del tipo [Calculator(400/1400) → 0.29] inserita nel bel mezzo di una frase. Il modello, che sa solo predire testo, può quindi imparare a generare quel frammento come genererebbe qualsiasi altra parola, nel punto in cui gli serve.
L’analogia è la nota a piè di pagina di uno studioso onesto: mentre scrivi, ti fermi, apri una parentesi per verificare un dato, riporti quello che hai trovato e prosegui. La chiamata al tool è quella parentesi, e il modello impara dove metterla.
Come impara da solo: campiona, esegue, filtra
Qui sta il contributo centrale, ed è più furbo di quanto sembri. Il modello si costruisce da solo i propri dati di addestramento, in tre mosse.
Primo, campiona: dato un testo normale, il modello propone dei punti in cui potrebbe avere senso inserire una chiamata a uno strumento, e formula la chiamata. Bastano pochissimi esempi scritti a mano per ciascuno strumento per innescare il meccanismo. Secondo, esegue: ogni chiamata proposta viene effettivamente lanciata, e se ne raccoglie il risultato. Terzo — ed è il passaggio chiave — filtra: si tiene una chiamata solo se il suo risultato aiuta a prevedere meglio le parole che seguono nel testo originale.
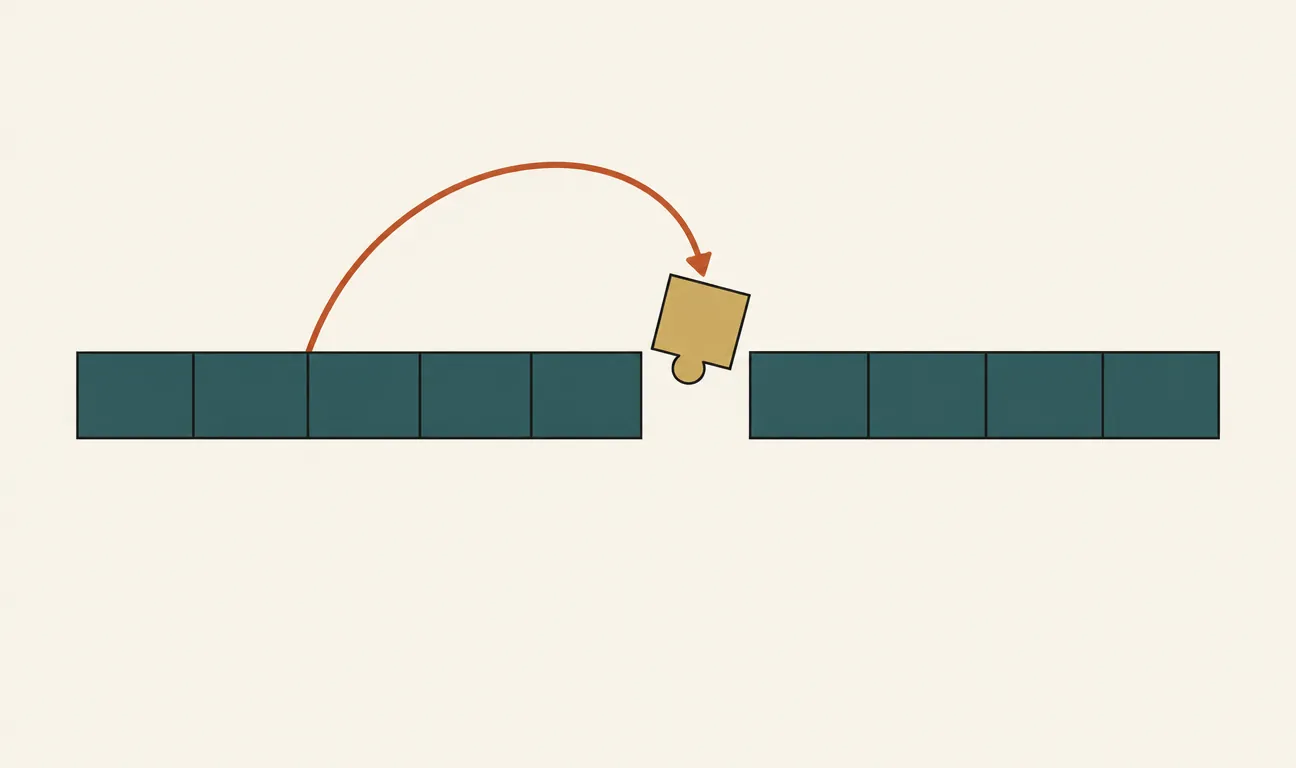
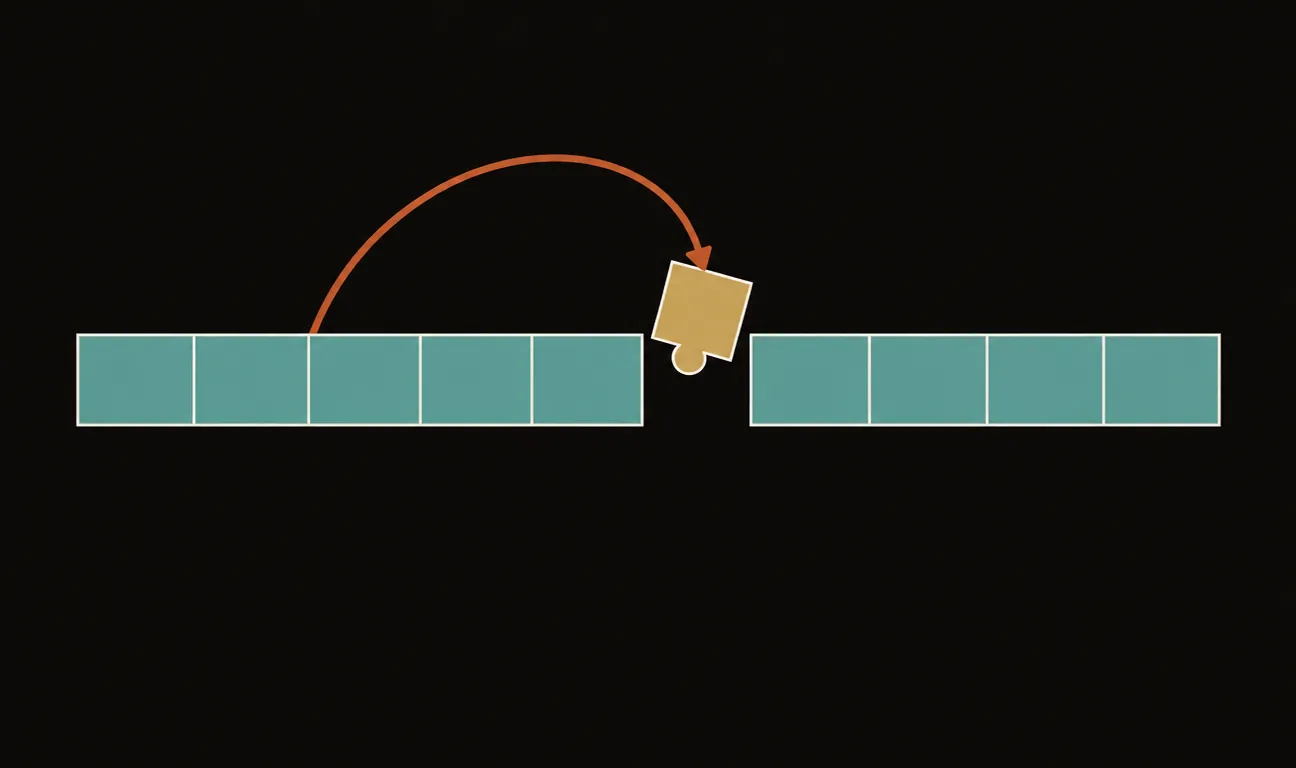
Mentre genera, il modello arriva a un punto di decisione: la cifra dopo «cioè il» è difficile da indovinare. Sceglie allora di emettere una chiamata alla calcolatrice, ne inserisce il risultato nella frase e prosegue. La decisione di chiamare o no lo strumento è presa dal modello stesso, un token alla volta.
Questo filtro è la vera intuizione. Non serve un umano a dire «qui una calcolatrice sarebbe stata utile»: lo dice la matematica stessa dell’addestramento. Se sapere che 400 diviso 1400 fa 0,29 rende molto più facile prevedere che la parola dopo sarà «29%», allora quella chiamata era utile e si conserva. Se non cambia niente, si butta. Il criterio è lo stesso — la riduzione della perdita di predizione — con cui il modello è stato addestrato fin dall’inizio; viene solo riutilizzato per selezionare buone chiamate a strumenti. Il modello si annota così un dataset di esempi utili e ci si riaddestra sopra.
Gli strumenti e i risultati
Nel paper Toolformer impara a usare cinque strumenti: una calcolatrice, un sistema di domande e risposte, un motore di ricerca su Wikipedia, un sistema di traduzione automatica e un calendario. Il modello di base è GPT-J, da 6,7 miliardi di parametri: piccolo per gli standard dell’epoca.
Non serve un umano a segnalare dove una calcolatrice sarebbe utile: lo dice la stessa funzione di perdita con cui il modello è stato addestrato.
Il risultato dichiarato è la parte che ha fatto discutere: dotato di strumenti, questo modello da 6,7 miliardi di parametri arriva a superare, in una serie di compiti affrontati «a freddo» senza esempi, GPT-3 da 175 miliardi di parametri — quasi trenta volte più grande. E lo fa senza perdere le sue capacità linguistiche di partenza. La lezione è che, per certi compiti, dare a un modello piccolo l’accesso allo strumento giusto vale più che gonfiarne le dimensioni.
Dove si ferma
Gli autori sono espliciti sui limiti, e vale la pena riportarli. Toolformer non sa incatenare gli strumenti: non può usare il risultato di una chiamata come input di un’altra in sequenza. Non sa usarli in modo interattivo — per esempio scorrere e affinare i risultati di una ricerca invece di prendere il primo. E la decisione di chiamare o meno un tool resta sensibile a come è formulata esattamente la frase. Sono limiti importanti perché delimitano con precisione cosa questo lavoro è: non un agente completo, ma il primo mattone pulito di una capacità che oggi diamo per scontata.
Perché vi riguarda
Se avete usato un assistente che esegue codice, interroga un database o cerca sul web, avete visto i discendenti diretti di questa idea. Quello che oggi si chiama «function calling» o «tool use» — il meccanismo con cui i modelli moderni si collegano a strumenti esterni e sta alla base di ogni agente AI — ha in Toolformer uno dei suoi antenati concettuali più chiari. Il paper è utile perché isola il problema alla sua forma più pura: prima di orchestrare dieci strumenti, un modello deve imparare a fare una cosa sola, decidere da sé quando smettere di indovinare e andare a controllare. È una lezione che vale anche fuori dal machine learning.
Il paper originale
Timo Schick et al., Toolformer: Language Models Can Teach Themselves to Use Tools, Meta AI, febbraio 2023. Disponibile su arXiv: arxiv.org/abs/2302.04761. Da leggere in particolare la sezione sul filtraggio delle chiamate basato sulla riduzione della perdita, che è il cuore del metodo.
I commenti sono riservati agli iscritti.
Accedi per commentare