Il modo più rapido per smettere di considerare un modello linguistico una specie di oracolo è scriverne uno. Non un modello di frontiera: quello richiede mesi di GPU e una biblioteca. Ma la forma è la stessa, e sta in poco codice — la struttura di GPT-2 nella sua taglia piccola è un blocco ripetuto dodici volte, e il blocco è cinque righe di algebra lineare intervallate da tre normalizzazioni.
In questo tutorial lo costruiamo per intero in PyTorch: tokenizzazione, dataset, blocco causale, ciclo di addestramento, generazione. Su un testo piccolo e su una CPU normale il risultato sarà un modello che produce italiano approssimativo — ed è esattamente il punto: vedere dove finisce l’architettura e dove comincia la scala.
La catena completa. In addestramento si percorre da sinistra a destra una volta per batch; in generazione si aggiunge il cappio tratteggiato, che rimette in ingresso il token appena prodotto.
Il tokenizer: non si scrive, si prende
Un modello non vede lettere: vede interi. La conversione la fa un tokenizer, e per un esercizio come questo non conviene addestrarne uno: si usa quello di GPT-2, disponibile nel pacchetto tiktoken. Il suo vocabolario ha 50 257 voci e lavora a livello di byte, il che significa che qualunque stringa — accenti italiani compresi — è rappresentabile senza token sconosciuti.
pip install torch tiktokenimport tiktoken
tok = tiktoken.get_encoding("gpt2")
ids = tok.encode("Nel mezzo del cammin di nostra vita")
print(ids) # una lista di interi
print(tok.decode(ids)) # torna la stringa di partenzaVale la pena stampare len(ids) su un paragrafo italiano: il tokenizer di GPT-2 è stato costruito su testo prevalentemente inglese, e l’italiano gli costa più token a parità di caratteri. È una tassa che si paga a ogni chiamata di API, ed è la ragione per cui i modelli più recenti hanno vocabolari più grandi e più multilingui.
Il dataset: una finestra che scorre
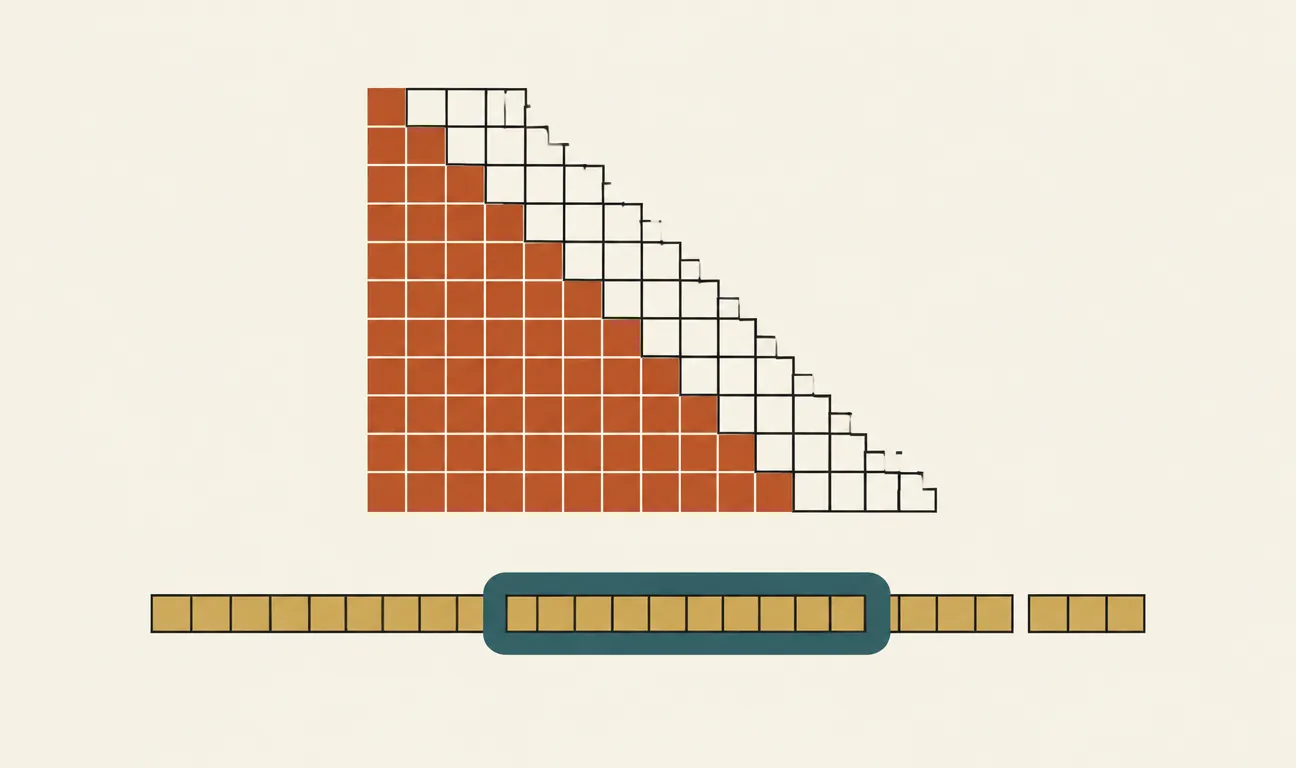
L’addestramento di un modello autoregressivo è un compito di autocompletamento su scala industriale: data una sequenza di token, prevedi il successivo. Il dataset non ha bisogno di etichette, perché l’etichetta è il testo stesso spostato di una posizione. Da un testo lungo si ricavano coppie (ingresso, bersaglio) facendo scorrere una finestra:
import torch
from torch.utils.data import Dataset, DataLoader

class FinestreDiTesto(Dataset):
    def __init__(self, testo, tok, lunghezza, passo):
        self.ids = tok.encode(testo)
        self.lunghezza = lunghezza
        self.passo = passo

    def __len__(self):
        return max(0, (len(self.ids) - self.lunghezza - 1) // self.passo + 1)

    def __getitem__(self, i):
        inizio = i * self.passo
        x = self.ids[inizio : inizio + self.lunghezza]
        y = self.ids[inizio + 1 : inizio + self.lunghezza + 1]
        return torch.tensor(x), torch.tensor(y)

testo = open("corpus.txt", encoding="utf-8").read()
dati = FinestreDiTesto(testo, tok, lunghezza=128, passo=128)
loader = DataLoader(dati, batch_size=8, shuffle=True, drop_last=True)
Due scelte meritano una riga di spiegazione. passo uguale a lunghezza significa finestre non sovrapposte: ogni token compare in un solo esempio. Dimezzando il passo si raddoppiano gli esempi, ma si rivedono gli stessi token più volte per epoca — utile su corpora piccoli, un modo per sprecare calcolo su corpora grandi. E il bersaglio è l’ingresso sfalsato di una posizione, non una sequenza a parte: è tutta qui la supervisione.
Qui montiamo i pezzi; perché l’attenzione funzioni — che cosa sono query, chiave e valore, e perché la maschera causale è ciò che rende il modello capace di generare — è materia del libro.
Il blocco: attenzione causale e rete densa
Il cuore del modello è un blocco che si ripete identico. Contiene due sotto-strati — l’attenzione multi-testa mascherata e una piccola rete densa — ciascuno preceduto da una normalizzazione e seguito da una connessione residua. In PyTorch, la parte di attenzione può appoggiarsi a scaled_dot_product_attention, che implementa il calcolo in modo efficiente e accetta il flag is_causal:
import torch.nn as nn
import torch.nn.functional as F

class AttenzioneCausale(nn.Module):
    def __init__(self, d, teste):
        super().__init__()
        self.teste = teste
        self.d_testa = d // teste
        self.qkv = nn.Linear(d, 3 * d)
        self.uscita = nn.Linear(d, d)

    def forward(self, x):
        B, T, D = x.shape
        q, k, v = self.qkv(x).split(D, dim=2)
        # (B, teste, T, d_testa): ogni testa guarda la sequenza per conto suo
        forma = (B, T, self.teste, self.d_testa)
        q = q.view(forma).transpose(1, 2)
        k = k.view(forma).transpose(1, 2)
        v = v.view(forma).transpose(1, 2)
        y = F.scaled_dot_product_attention(q, k, v, is_causal=True)
        y = y.transpose(1, 2).contiguous().view(B, T, D)
        return self.uscita(y)

class Blocco(nn.Module):
    def __init__(self, d, teste):
        super().__init__()
        self.norm1 = nn.LayerNorm(d)
        self.attn = AttenzioneCausale(d, teste)
        self.norm2 = nn.LayerNorm(d)
        self.densa = nn.Sequential(
            nn.Linear(d, 4 * d), nn.GELU(approximate="tanh"), nn.Linear(4 * d, d)
        )

    def forward(self, x):
        x = x + self.attn(self.norm1(x))
        x = x + self.densa(self.norm2(x))
        return x
is_causal=True è la riga che impedisce a ogni posizione di guardare quelle che vengono dopo. Senza, il modello imparerebbe a copiare il bersaglio dall’ingresso e la loss crollerebbe a zero in poche centinaia di passi: un risultato splendido e completamente inutile. È l’errore più comune di chi scrive un transformer da zero, e si riconosce proprio da quello — una loss troppo bella.
La rete densa allarga a quattro volte la dimensione e poi torna indietro. Il fattore quattro non ha nulla di sacro: è la scelta di GPT-2, ereditata dal paper originale del transformer, e da allora ripetuta quasi ovunque.
Il modello intero
Attorno alla pila di blocchi servono tre cose: una tabella di embedding che trasforma ogni id in un vettore, una tabella posizionale che dice a che punto della finestra ci si trova, e una testa lineare finale che riporta dal vettore a un punteggio per ciascuno dei 50 257 token del vocabolario.
class GPT(nn.Module):
    def __init__(self, vocab, contesto, d, teste, strati):
        super().__init__()
        self.emb_token = nn.Embedding(vocab, d)
        self.emb_pos = nn.Embedding(contesto, d)
        self.blocchi = nn.ModuleList([Blocco(d, teste) for _ in range(strati)])
        self.norm = nn.LayerNorm(d)
        self.testa = nn.Linear(d, vocab, bias=False)
        # embedding e testa condividono i pesi, come in GPT-2
        self.testa.weight = self.emb_token.weight
        self.apply(self._init_pesi)

    @staticmethod
    def _init_pesi(m):
        if isinstance(m, (nn.Linear, nn.Embedding)):
            nn.init.normal_(m.weight, mean=0.0, std=0.02)
            if isinstance(m, nn.Linear) and m.bias is not None:
                nn.init.zeros_(m.bias)

    def forward(self, idx):
        B, T = idx.shape
        pos = torch.arange(T, device=idx.device)
        x = self.emb_token(idx) + self.emb_pos(pos)
        for blocco in self.blocchi:
            x = blocco(x)
        return self.testa(self.norm(x))

modello = GPT(vocab=50257, contesto=1024, d=768, teste=12, strati=12)
Quei quattro numeri sono la configurazione della taglia piccola di GPT-2: dodici strati, dodici teste, vettori da 768 dimensioni, finestra da 1024 token. Contando i parametri di questo modello si ottengono 124,4 milioni — il «124M» che si legge nelle schede del modello. Su una CPU sono troppi: per provare, riduci a d=256, teste=4, strati=4, contesto=128 e il ciclo diventa questione di minuti invece che di giorni.
L’inizializzazione a deviazione standard 0,02 non è un dettaglio estetico. PyTorch, lasciato a sé, inizializza le tabelle di embedding con una normale standard: i logit partono enormi e la perdita al primo passo vale una quarantina invece di dieci. Il modello poi si riprende, ma sprecando i primi passi a rimpicciolire i pesi invece che a imparare.
Addestrare
Il ciclo è quello standard, con un solo dettaglio: la funzione di perdita confronta un punteggio per ogni posizione della sequenza, quindi logit e bersagli vanno appiattiti prima di darli a cross_entropy.
from torch.optim import AdamW

ott = AdamW(modello.parameters(), lr=3e-4, weight_decay=0.1)

modello.train()
for epoca in range(3):
    for x, y in loader:
        logit = modello(x)                       # (B, T, vocab)
        perdita = F.cross_entropy(
            logit.flatten(0, 1), y.flatten()     # (B*T, vocab) contro (B*T,)
        )
        ott.zero_grad(set_to_none=True)
        perdita.backward()
        torch.nn.utils.clip_grad_norm_(modello.parameters(), 1.0)
        ott.step()
    print(f"epoca {epoca}: perdita {perdita.item():.3f}")
Il clip_grad_norm_ non è ornamentale. Nei transformer capita che un batch produca gradienti enormi e mandi i pesi fuori scala in un colpo solo; tagliare la norma a 1 è la protezione più economica che esista. Un buon segno di salute, all’inizio: la perdita al primo passo dovrebbe aggirarsi attorno a 10,8, che è il logaritmo naturale di 50 257 — cioè un modello che tira a indovinare uniformemente fra tutti i token. Se parte molto più in basso, qualcosa nella maschera causale sta lasciando passare il futuro.
Generare
La generazione è un ciclo: si passa la sequenza al modello, si guardano i logit dell’ultima posizione, si campiona un token, lo si aggiunge in coda e si ricomincia.
@torch.no_grad()
def genera(modello, tok, avvio, quanti, contesto, temperatura=0.8, top_k=50):
    modello.eval()
    idx = torch.tensor([tok.encode(avvio)])
    for _ in range(quanti):
        finestra = idx[:, -contesto:]            # non superare mai il contesto
        logit = modello(finestra)[:, -1, :] / temperatura
        if top_k:
            soglia = torch.topk(logit, top_k).values[:, -1:]
            logit = logit.masked_fill(logit < soglia, float("-inf"))
        prossimo = torch.multinomial(torch.softmax(logit, dim=-1), 1)
        idx = torch.cat([idx, prossimo], dim=1)
    return tok.decode(idx[0].tolist())

print(genera(modello, tok, "Nel mezzo del cammin", quanti=60, contesto=128))
I due parametri di campionamento fanno cose diverse e vengono spesso confusi. La temperatura divide i logit prima della softmax: sotto 1 accentua le differenze e rende il testo più prevedibile, sopra 1 le appiattisce e lo rende più strano. Il top-k taglia via tutto ciò che non sta fra i k candidati migliori: serve a impedire che la lunghissima coda di token improbabili, sommata, catturi ogni tanto il campionamento e produca una parola assurda in mezzo a una frase sensata.
Cosa portarti a casa
Con un corpus da qualche megabyte e un modellino ridotto, dopo pochi minuti otterrai testo che ha la forma dell’italiano — spaziatura, punteggiatura, parole vere, ogni tanto una sintassi plausibile — e nessun contenuto. È il risultato giusto, e dice due cose.
La prima: l’architettura non è il segreto. Le righe qui sopra sono, nella sostanza, quelle di un modello di frontiera; ciò che le separa è il numero di parametri, i miliardi di token visti e i mesi di calcolo. Quando si legge che un laboratorio ha «un’architettura proprietaria», di solito si parla di dettagli di efficienza, non di una macchina diversa.
La seconda: fra questo modellino e un assistente che risponde alle domande c’è un secondo pezzo di strada, che non è pre-addestramento. Il modello che hai appena scritto sa solo continuare un testo; per farlo diventare qualcosa a cui si parla servono l’instruction tuning e l’allineamento, che sono fasi separate e su corpora diversi.
Un GPT non è difficile da scrivere. È difficile da addestrare: la complessità è quasi tutta nei dati e nel calcolo, non nel codice.
Vale la pena tenere il file. È il banco di prova più onesto che ci sia per capire un articolo su un nuovo meccanismo di attenzione o su una variante del positional encoding: se una modifica proposta si riesce a scrivere dentro queste centoventi righe, la si è capita davvero.
I commenti sono riservati agli iscritti.
Accedi per commentare