
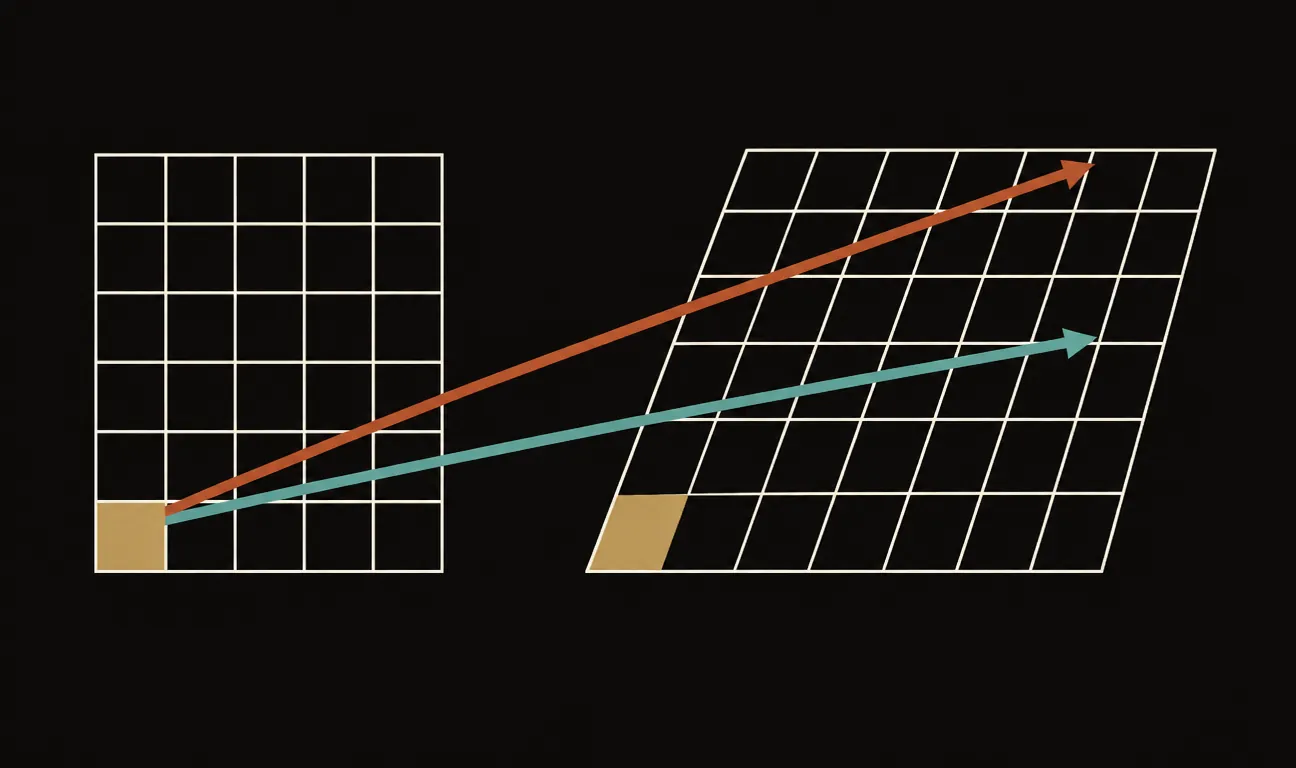
Aprite il task manager di un computer che sta eseguendo un modello linguistico e guardate cosa fa la GPU: per la quasi totalità del tempo esegue una sola operazione, ripetuta miliardi di volte al secondo. Non è una ricerca intelligente, non è un ragionamento simbolico: è una moltiplicazione tra matrici. Tutta l’intelligenza artificiale contemporanea — dai chatbot al riconoscimento di immagini — poggia su due oggetti matematici che si studiano al primo anno di università e che troppi corsi riescono a rendere ostili: i vettori e le matrici. Vale la pena fare pace con loro, perché la parte che serve davvero è molto più piccola, e molto più concreta, di quanto i libri di testo lascino intendere.
Vettori, prodotto scalare, matrici come trasformazioni, autovalori e autovettori: la trattazione completa, con la notazione, sta nel libro.
Leggi «Algebra lineare: vettori, matrici, prodotti» nel libro →
Un vettore è una lista che ha una direzione
Un vettore, nella pratica dell’AI, è semplicemente una lista ordinata di numeri: [3, 2], oppure [0.12, -1.4, 0.007, …] con qualche migliaio di elementi. Niente di più. La lista della spesa con le quantità accanto a ogni voce è già, tecnicamente, un vettore.
Quello che rende l’oggetto interessante è la seconda lettura, quella geometrica: una lista di due numeri può essere vista come una freccia nel piano, che parte dall’origine e arriva al punto di coordinate corrispondenti. [3, 2] è la freccia che va tre passi a destra e due in alto. Con tre numeri, la freccia vive nello spazio tridimensionale. Con mille numeri, vive in uno spazio a mille dimensioni che nessuno riesce a visualizzare — ma le regole del gioco restano identiche, e questa è la vera potenza dell’algebra lineare: l’intuizione costruita in due dimensioni continua a funzionare in diecimila.
Le due letture convivono sempre. Per il programmatore un vettore è un array; per il geometra è una freccia con una lunghezza e una direzione. Nell’AI si passa continuamente dall’una all’altra: un embedding è un array di numeri quando lo salvate su disco, ed è un punto in uno spazio semantico quando misurate quanto due frasi si somigliano.
Sommare frecce, allungare frecce
Con i vettori si fanno essenzialmente due cose, entrambe più semplici del previsto. La somma: si sommano le liste elemento per elemento, e geometricamente equivale a mettere le frecce in fila, una dopo l’altra — come due tratti consecutivi di un viaggio. Camminare 3 km verso est e poi 1 km verso nord-est vi porta esattamente dove vi porterebbe la freccia somma.
La seconda operazione è la moltiplicazione per un numero: 2 × [3, 2] = [6, 4] è la stessa freccia, lunga il doppio. Un numero negativo la ribalta. Tutto qui: allungare, accorciare, invertire.
Sembra poco, ed è il punto. Combinando solo queste due operazioni — somme e riscalamenti — si ottiene tutto ciò che l’algebra lineare sa fare. Le «combinazioni lineari» dal nome solenne sono questo: un po’ di questa freccia più un po’ di quell’altra. Quando una rete neurale mescola i segnali in ingresso pesandoli, sta facendo una combinazione lineare. Quando un modello di raccomandazione descrive i vostri gusti come «70% jazz, 30% elettronica», sta collocando il vostro profilo come combinazione di frecce prototipo.
Una matrice è una macchina che trasforma frecce
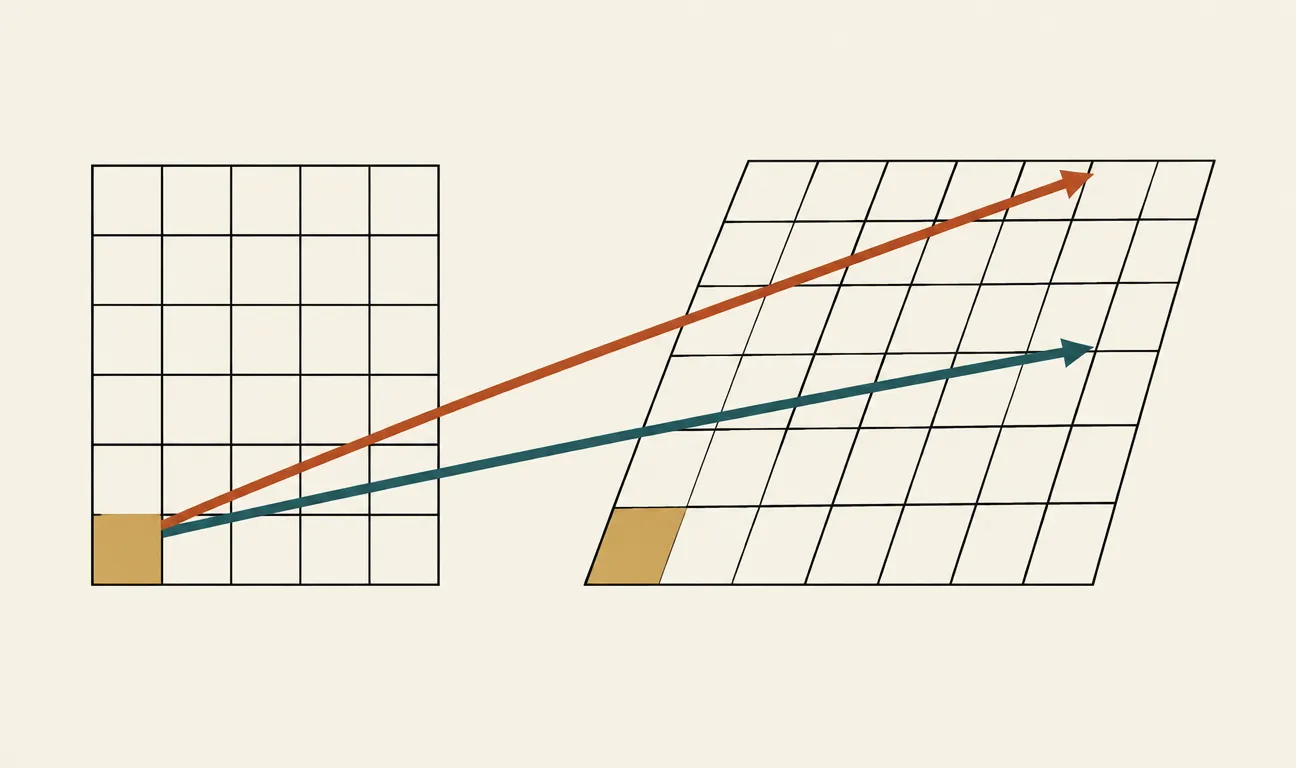
Ed eccoci all’oggetto che intimidisce di più. Una matrice è una tabella di numeri, righe per colonne. La lettura da programmatore: un array bidimensionale. Ma la lettura utile è un’altra: una matrice è una macchina che prende in ingresso un vettore e restituisce un altro vettore. Si scrive «moltiplicare la matrice per il vettore», ma l’immagine giusta è quella di una trasformazione: la freccia entra, la macchina la ruota, la stira, la schiaccia o la proietta, e una freccia nuova esce.
Alcune macchine celebri: la matrice di rotazione gira ogni freccia dello stesso angolo, come un piatto girevole. Una matrice diagonale stira lo spazio lungo gli assi, come una fotografia allargata solo in orizzontale. Una matrice di proiezione schiaccia tutto su una linea, come l’ombra che il sole proietta sul terreno. Il vincolo comune, che dà il nome «lineare» a tutta la disciplina, è che queste macchine trattano tutti i punti dello spazio con la stessa regola: niente strappi, niente pieghe, l’origine resta ferma e le linee rette restano rette.
Una rete neurale non è che una catena di macchine lineari, intervallate da piccole non-linearità che impediscono alla catena di collassare in una macchina sola.
Questa immagine spiega anche perché moltiplicare due matrici tra loro abbia senso: significa costruire la macchina composta. Prima ruota, poi stira: la matrice prodotto è la macchina unica che fa entrambe le cose in un colpo. E spiega perché l’ordine conta — ruotare e poi stirare non dà lo stesso risultato che stirare e poi ruotare, esattamente come mettersi i calzini e poi le scarpe non equivale al contrario.
Dove tutto questo diventa intelligenza artificiale
Ora il collegamento con l’AI, che è sorprendentemente diretto. Uno strato di rete neurale è, quasi per intero, una moltiplicazione matrice-vettore: il vettore in ingresso rappresenta i dati (i pixel di un’immagine, l’embedding di una parola), la matrice contiene i pesi — i numeri che la rete ha imparato durante l’addestramento — e il vettore in uscita è la rappresentazione trasformata, un gradino più vicina alla risposta.
«Addestrare un modello» significa quindi, alla lettera, trovare i numeri giusti da mettere dentro queste matrici. Quando leggete che un modello ha 70 miliardi di parametri, quei parametri sono in larghissima parte gli elementi delle sue matrici di pesi. E quando leggete che le GPU sono indispensabili per l’AI, il motivo è che una GPU è un processore progettato per fare moltissime moltiplicazioni e somme in parallelo — cioè esattamente ciò di cui è fatta una moltiplicazione tra matrici.
Anche il meccanismo di attenzione dei transformer, il cuore dei modelli linguistici attuali, è costruito con questi mattoni: matrici che trasformano gli embedding in query e chiavi, prodotti tra vettori per misurare quanto ogni parola è rilevante per le altre. I nomi cambiano, l’aritmetica no.
Le due letture di un vettore: a sinistra le frecce nel piano, con la somma v + w costruita mettendo le frecce in fila (regola del parallelogramma); a destra le stesse operazioni fatte sulle liste di numeri, elemento per elemento.
Cosa studiare, cosa saltare
Se il vostro obiettivo è capire e usare l’AI, non serve tutta l’algebra lineare del corso universitario. Serve un sottoinsieme preciso:
- Vettori come frecce e come liste, con somma e riscalamento — è la lingua in cui sono scritti dati ed embedding.
- Il prodotto scalare — la singola operazione più importante, quella che misura la somiglianza (merita un articolo a parte, ed è il prossimo di questa serie).
- Matrici come trasformazioni e la moltiplicazione matrice-vettore — è un layer di rete neurale.
- Le dimensioni e la loro compatibilità — metà degli errori di chi inizia con PyTorch sono matrici che non combaciano.
Si può invece rimandare senza sensi di colpa: determinanti calcolati a mano, inversione di matrici con i cofattori, dimostrazioni sugli spazi astratti. Autovalori e decomposizioni torneranno utili più avanti (per capire PCA o la stabilità dell’addestramento), ma non sono il biglietto d’ingresso.
Perché vi riguarda
Se lavorate con l’AI anche solo come utenti avanzati, questa grammatica minima vi cambia la lettura di tutto il resto. «Embedding» smette di essere una parola magica e diventa una freccia in uno spazio; «70 miliardi di parametri» diventa il contenuto di tabelle di numeri; «serve una GPU» diventa un’affermazione sull’aritmetica, non un feticcio hardware. E se scrivete codice, l’immagine mentale delle matrici come macchine che trasformano frecce è quella che vi farà capire al volo perché le dimensioni devono combaciare e cosa sta davvero succedendo dentro model(x). L’algebra lineare non è il prerequisito noioso dell’AI: è l’AI, vista da vicino.
I commenti sono riservati agli iscritti.
Accedi per commentare