
Prendi la parola «re», trasformala in una lista di numeri. Fai lo stesso con «uomo», «donna», «regina». Ora sottrai i numeri di «uomo» da quelli di «re», aggiungi quelli di «donna», e guarda quale parola ha i numeri più vicini al risultato. La risposta è «regina». Non perché qualcuno abbia insegnato alla macchina cos’è una regina, né cosa significhi il genere o la nobiltà: quei numeri sono stati ricavati leggendo testo, e basta. Questo piccolo trucco aritmetico è il cuore di Efficient Estimation of Word Representations in Vector Space, il paper pubblicato nel gennaio 2013 da Tomas Mikolov, Kai Chen, Greg Corrado e Jeffrey Dean — il lavoro con cui l’idea di «embedding» è diventata un pezzo di infrastruttura del linguaggio computazionale.
Tokenizzazione, one-hot, bag-of-words e TF-IDF, fino ai vettori densi degli embedding: il percorso completo è nel libro.
Leggi «Rappresentare il testo: dai token agli embedding» nel libro →
Il problema: un computer non sa cos’è una parola
Per un modello statistico, «gatto» e «gattopardo» e «tavolo» sono all’origine soltanto simboli distinti, senza alcuna relazione tra loro. Il modo tradizionale di darli in pasto a un algoritmo era la codifica «one-hot»: ogni parola è un vettore lungo quanto l’intero vocabolario, tutto zeri tranne un uno nella posizione che le compete. Con questa rappresentazione «gatto» e «felino» sono lontani esattamente quanto «gatto» e «burocrazia»: ogni parola è un’isola, equidistante da tutte le altre. Nessuna nozione di significato, nessuna somiglianza.
L’alternativa è rappresentare ogni parola non con un interruttore acceso in un mare di zeri, ma con una manciata di numeri reali — nel paper, tipicamente qualche centinaio. Puoi immaginarli come coordinate su una mappa: parole con significato affine finiscono vicine, parole scollegate finiscono lontane. La domanda è: come si trovano quelle coordinate senza scriverle a mano per centinaia di migliaia di parole?
L’intuizione: dimmi con chi vai
La risposta poggia su un’idea vecchia di linguistica, spesso riassunta nella frase del linguista John Firth: «conosci una parola dalla compagnia che frequenta». Le parole che compaiono negli stessi contesti tendono ad avere significati simili. «Caffè» e «tè» appaiono entrambe accanto a «bere», «caldo», «tazza», «mattina»; per questo, pur essendo simboli diversi, occupano ruoli intercambiabili in molte frasi. È come dedurre il mestiere di uno sconosciuto dalle persone che frequenta: non serve chiederglielo, basta osservare la sua compagnia abituale.
word2vec trasforma questa intuizione in una procedura meccanica. Fa scorrere una finestra lungo miliardi di parole di testo e, per ogni posizione, gioca a indovinare: dato un contesto, quale parola sta al centro? Oppure: data una parola, quali stanno intorno? Ogni volta che sbaglia, aggiusta di poco i numeri delle parole coinvolte. Ripetuto su un corpus enorme, questo aggiustamento continuo spinge le parole a disporsi in modo che il vicinato nello spazio dei numeri rispecchi il vicinato nel testo reale.
Due modi di indovinare: CBOW e Skip-gram
Il paper propone due architetture, entrambe volutamente semplici — è questo il senso di «efficient» nel titolo: modelli leggeri che si addestrano su quantità enormi di testo senza costi proibitivi. La prima, Continuous Bag-of-Words (CBOW), fa il gioco del riempimento: nascondi una parola in una frase e chiedi al modello di indovinarla a partire da quelle attorno. La seconda, Skip-gram, capovolge la mossa: data una parola, chiede di prevedere quali parole le stanno tipicamente intorno.
La differenza pratica conta. CBOW è più rapida e tende a comportarsi bene sulle parole frequenti; Skip-gram è più lenta ma cattura meglio le parole rare e le sfumature. Ciò che colpì all’epoca fu l’ordine di grandezza: gli autori riportano di aver addestrato vettori di buona qualità su un corpus da 1,6 miliardi di parole in meno di un giorno, un risultato che rendeva la tecnica improvvisamente accessibile a chiunque avesse un po’ di dati e una macchina normale.
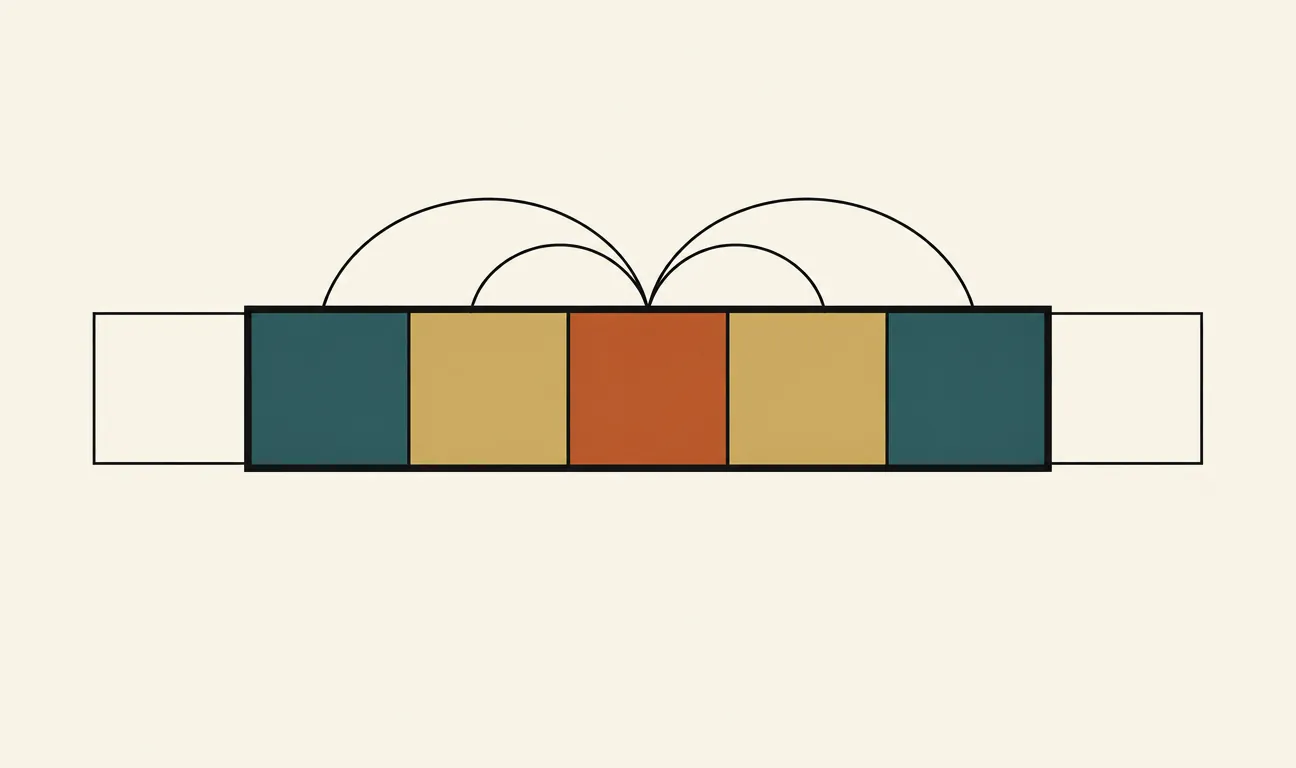
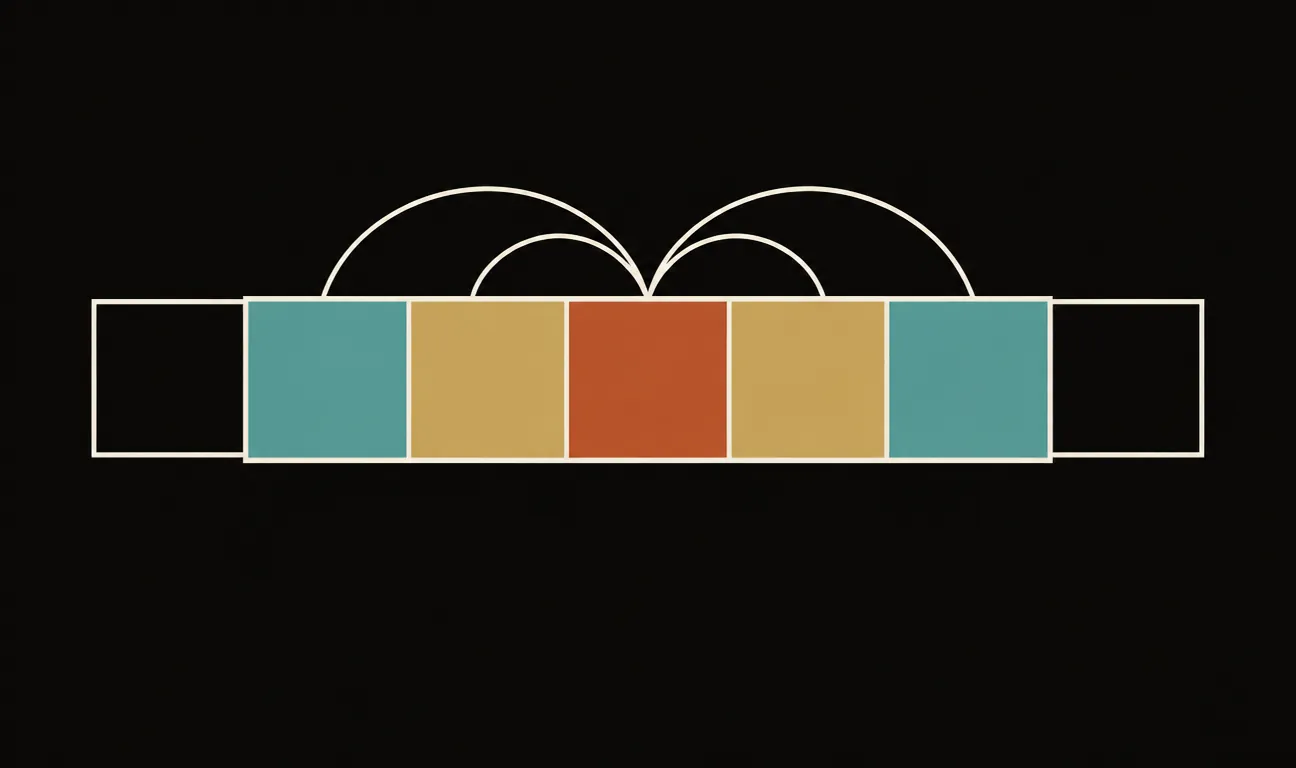
Le quattro parole occupano i vertici di un parallelogramma: lo stesso spostamento che porta da «uomo» a «re» (la direzione «regalità», in terracotta) porta anche da «donna» a «regina». Sommare quello spostamento al vettore di «donna» fa cadere il risultato proprio dove sta «regina». La struttura non è stata programmata: emerge dai numeri appresi sul testo.
L’aritmetica dei significati
La scoperta che ha reso il paper celebre è questa regolarità geometrica. Nello spazio dei vettori, certe relazioni tra parole diventano direzioni costanti. Lo spostamento che separa «uomo» da «donna» è quasi lo stesso che separa «re» da «regina», o «attore» da «attrice»: una direzione che, in modo grossolano, codifica il genere. Analogamente esistono direzioni che catturano il plurale («mela» → «mele»), i tempi verbali («cammina» → «camminava»), o la relazione capitale-nazione («Roma» → «Italia», «Parigi» → «Francia»). Da qui l’aritmetica: sottrarre e sommare vettori equivale a comporre queste relazioni.
Nessuno ha insegnato al modello cosa sia una regina: quella conoscenza si è depositata nella geometria dei numeri, un contesto alla volta.
Per misurarlo in modo serio, gli autori costruiscono una batteria di quasi ventimila domande di analogia — nella forma «A sta a B come C sta a…?» — divise in 8.869 quesiti semantici (capitali, valute, relazioni familiari) e 10.675 sintattici (plurali, comparativi, coniugazioni). Le configurazioni migliori del modello ne risolvevano correttamente attorno alla metà: un risultato che oggi può sembrare modesto, ma che rappresentava un salto netto rispetto agli approcci precedenti, ottenuto per giunta a una frazione del costo di calcolo. Il punto non era la percentuale in sé, ma il fatto stesso che una struttura semantica così pulita emergesse da un metodo tanto semplice.
Cosa cattura davvero (e cosa no)
Vale la pena essere onesti sui limiti, perché la stessa proprietà che rende word2vec elegante ne segna anche il confine. La prima cosa da chiarire è che l’esempio «re − uomo + donna» è meno pulito di come lo si racconta: il calcolo funziona a patto di escludere dai candidati le parole di partenza, e non tutte le analogie riescono altrettanto bene. È una regolarità reale e sorprendente, non una legge esatta.
Il limite più profondo è che ogni parola ha un solo vettore. «Calcio» lo sport, «calcio» il minerale e «calcio» il gesto del piede condividono la stessa rappresentazione: word2vec fonde i sensi diversi in un unico punto, incapace di distinguerli in base alla frase. È proprio questo il problema che i modelli successivi — quelli «contestuali», fino ai transformer che alimentano gli assistenti di oggi — hanno risolto, producendo un vettore diverso per la stessa parola a seconda del contesto in cui appare.
C’è infine una lezione scomoda. Se i vettori assorbono le regolarità del testo, assorbono anche i suoi pregiudizi: gli embedding addestrati su grandi corpora tendono a riprodurre associazioni stereotipate, per esempio tra certe professioni e un genere. Non è un difetto del metodo, è uno specchio del linguaggio con cui è stato nutrito — un promemoria, valido ancora oggi, che un modello non impara «la verità» ma la statistica del materiale che gli diamo.
Perché ti riguarda
word2vec è il punto in cui il significato smette di essere qualcosa che si programma a mano e diventa qualcosa che si misura come distanza tra numeri. Se lavori con l’AI, ogni volta che usi una ricerca semantica, un sistema di raccomandazione o la ricerca per similarità dentro un’applicazione RAG stai usando i discendenti diretti di questa idea: rappresentare oggetti come vettori e confrontarli per vicinanza. Se l’AI la usi e basta, tieni presente che i modelli linguistici di oggi, per quanto più sofisticati, poggiano ancora sullo stesso atto fondativo — trasformare le parole in geometria — mostrato in modo così nitido in queste poche pagine del 2013. L’aritmetica dei significati non è un aneddoto curioso: è il primo mattone su cui è costruito quasi tutto il resto.
Il paper originale
Tomas Mikolov, Kai Chen, Greg Corrado, Jeffrey Dean, Efficient Estimation of Word Representations in Vector Space, arXiv:1301.3781 (2013). Testo integrale: arxiv.org/abs/1301.3781.
I commenti sono riservati agli iscritti.
Accedi per commentare