LocateAnything, il riquadro in un colpo solo: NVIDIA insegna ai modelli visione-linguaggio a localizzare in parallelo
I modelli visione-linguaggio indicano un oggetto dettando le coordinate del suo riquadro una alla volta, come si detta un numero…
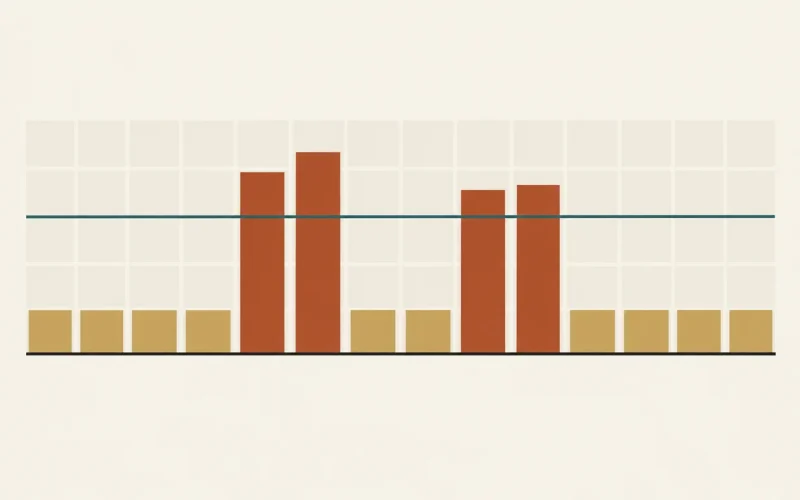
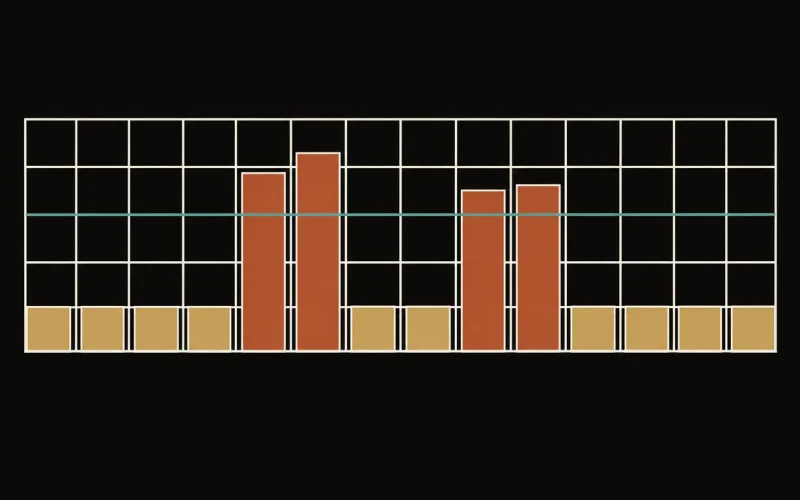
Nei modelli che generano video l'attenzione è la voce di spesa più grande, e i metodi per sfoltirla pagano due…
Molti modelli che leggono documenti guardano la pagina con un occhio addestrato su foto di strade, gatti e automobili. Un…
Il team Robbyant rilascia la seconda versione del suo world model interattivo: un modello causale da 14 miliardi di parametri,…
Il team MiniCPM-o di OpenBMB pubblica un modello aperto da 9 miliardi di parametri che non alterna più ascolto e…
Gli AI scientist scrivono proposte plausibili e codice che gira, ma spesso il codice non verifica più l'idea da cui…
Gli agenti imparano da ambienti costruiti a mano e sempre uguali, che non sanno nulla dei loro punti deboli. Un…
Per chi fa video un world model è un generatore di fotogrammi, per chi fa reinforcement learning è un simulatore…
Un world model per la manipolazione robotica riceve una fotografia della scena e la traiettoria prescritta per due bracci, e…
I sistemi di memoria per agenti chiamano un modello linguistico dopo ogni scambio per decidere che cosa ricordare, e il…