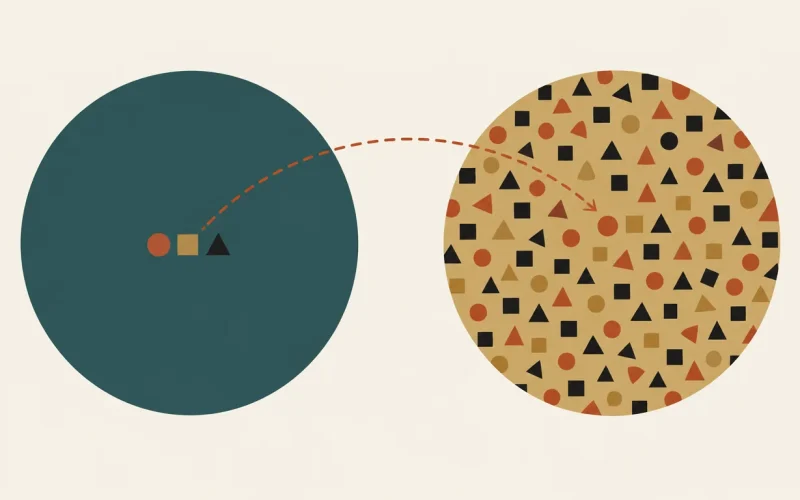
RoboDojo, l’esame comune per i robot generalisti: il migliore, in simulazione, riesce in meno di una prova su dieci
Un gruppo di 44 ricercatori, coordinato da MMLab dell'Università di Hong Kong e dall'Università di Pechino, propone un banco di…
Rilettura accessibile di un paper
Un gruppo di 44 ricercatori, coordinato da MMLab dell'Università di Hong Kong e dall'Università di Pechino, propone un banco di…
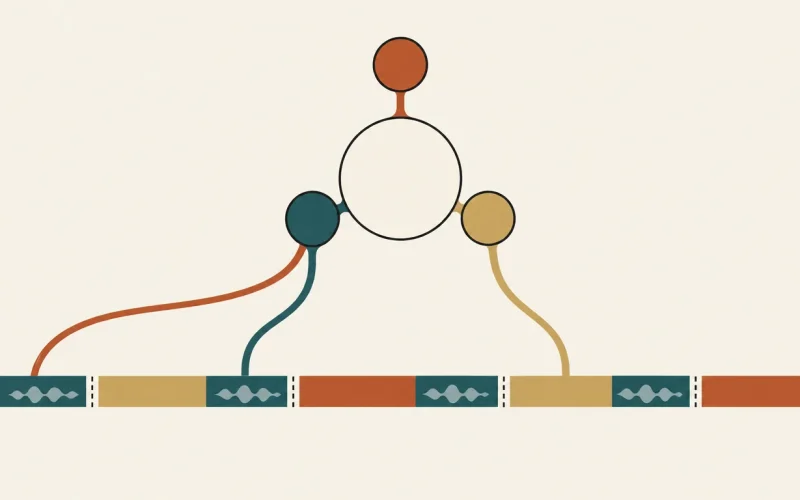
Microsoft Research porta in diretta il suo trascrittore che distingue le voci: un solo modello linguistico ascolta l'audio a pezzi…
Un gruppo della Huazhong University of Science and Technology propone di togliere il grande modello linguistico dal percorso che porta…
Un gruppo di NVIDIA, con lo stesso primo autore di OpenRLHF, propone un'infrastruttura per addestrare agenti con il reinforcement learning…
Invece di ricostruire i movimenti da video trovati in rete, dove camera, scala e forma degli oggetti vanno indovinate, NVIDIA…
Il gruppo OpenMOSS dell'Università Fudan pubblica una famiglia di modelli visione-linguaggio a pesi aperti costruita attorno a una capacità precisa:…
Un gruppo della HKUST e una comunità open source mettono in un solo codice i modi principali di costruire un…
Un gruppo della University of Texas at Dallas toglie al modello linguistico il lavoro di archivista: le decisioni piccole e…
Shengshu Technology, Tsinghua e Jiao Tong di Shanghai descrivono come servire a molti utenti insieme i modelli che generano video…
Un rapporto tecnico di oltre cento pagine propone un world model da 4 miliardi di parametri che impara prima dai…