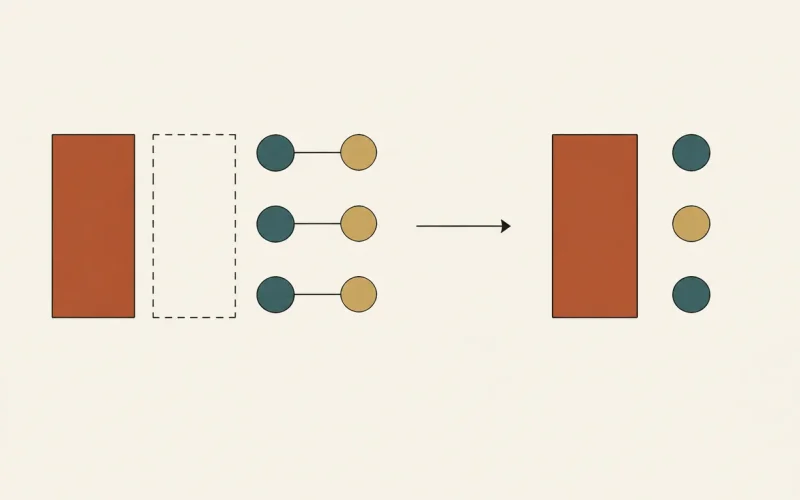
Oltre DPO: SimPO e KTO, allineare preferenze con meno ingredienti
DPO ha semplificato l'allineamento dei modelli linguistici, ma porta ancora con sé due pesi: un modello di riferimento da tenere…
LLM, RAG, Agents, MCP
DPO ha semplificato l'allineamento dei modelli linguistici, ma porta ancora con sé due pesi: un modello di riferimento da tenere…
Per decidere quale LLM risponde "meglio" non basta un compito con la risposta giusta. Il progetto nato a Berkeley ha…
Rispondere a un problema di matematica è una cosa. Prendere una segnalazione di bug da un progetto open source e…
Molti problemi di geometria delle olimpiadi si sbloccano con un'unica idea, tracciare il punto o la linea giusta. AlphaGeometry unisce…
Un lavoro di Google DeepMind del 2024 mostra che lasciar "ragionare" più a lungo un modello piccolo davanti a una…
Per anni abbiamo istruito i modelli con due o tre esempi nel prompt. Un lavoro di Google DeepMind del 2024…
Nel 2023 un gruppo di ricercatori della Fudan University prova a mettere ordine nella parola più abusata dell'anno: "agente". Rileggiamo…
Un modello linguistico non vede nulla: legge numeri. LLaVA mostra che per dargli la vista basta un pezzo sorprendentemente semplice:…
Nell'ottobre 2024 Anthropic ha dato a Claude un mouse e una tastiera: guarda lo schermo con uno screenshot, decide dove…
David Silver e Richard Sutton sostengono che l'AI addestrata sui dati umani stia toccando un tetto, e che il prossimo…