Mixture of Experts: il modello che non si accende tutto
I modelli Mixture of Experts hanno centinaia di miliardi di parametri ma ne attivano solo una frazione per ogni token.…
Un modello bravo ma troppo pesante da servire può insegnare a uno più piccolo. La distillazione non copia le risposte…
Specializzare un modello da miliardi di parametri sembra richiedere di riaddestrarlo tutto, con GPU da datacenter e una copia intera…
Un modello da 7 miliardi di parametri che gira su un portatile senza GPU dedicata non è magia: è quantizzazione.…
Ogni token generato da un LLM dovrebbe, in teoria, richiedere di rileggere tutto il testo precedente. Non succede, grazie a…
I modelli promettono finestre di contesto da centinaia di migliaia di token, ma quello spazio non è tutto vostro: system…
Un modello linguistico appena addestrato non risponde alle domande: le continua. L'instruction tuning è il passaggio che trasforma un completatore…
La Direct Preference Optimization elimina due dei tre pezzi della pipeline RLHF — il reward model e il reinforcement learning…
Un modello linguistico pre-addestrato sa completare qualsiasi testo, ma non sa cosa significhi essere utile. Il Reinforcement Learning from Human…
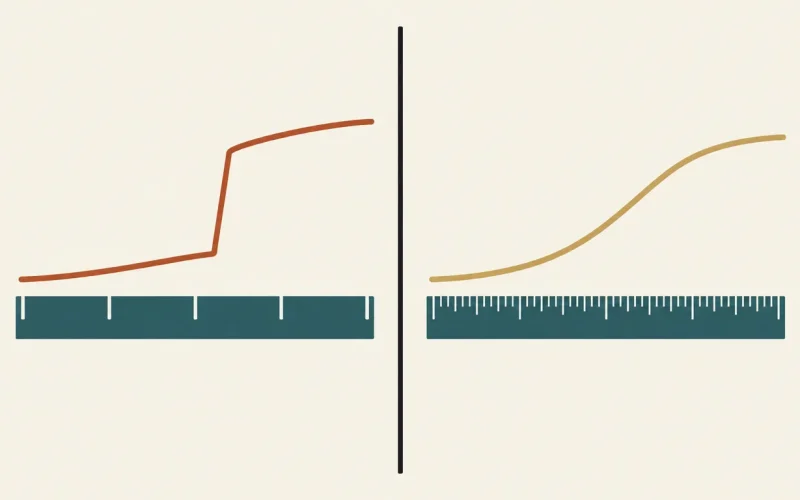
I modelli linguistici sembrano acquisire capacità "di colpo" superata una certa scala. Ma il salto è nel modello o nel…