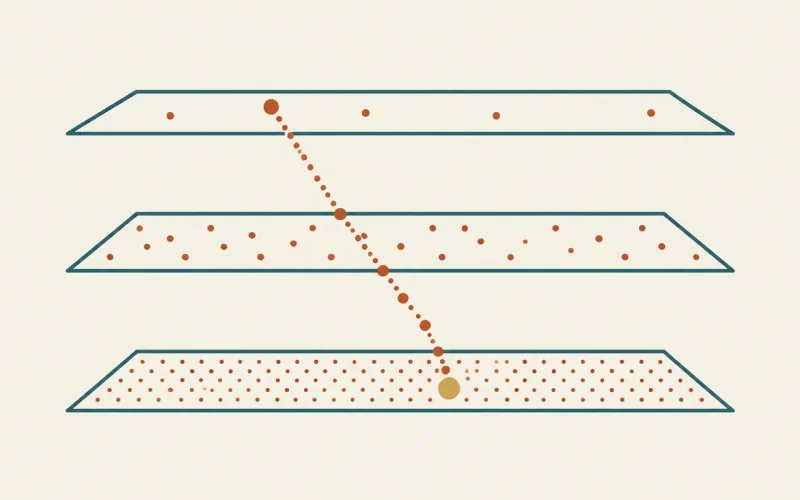
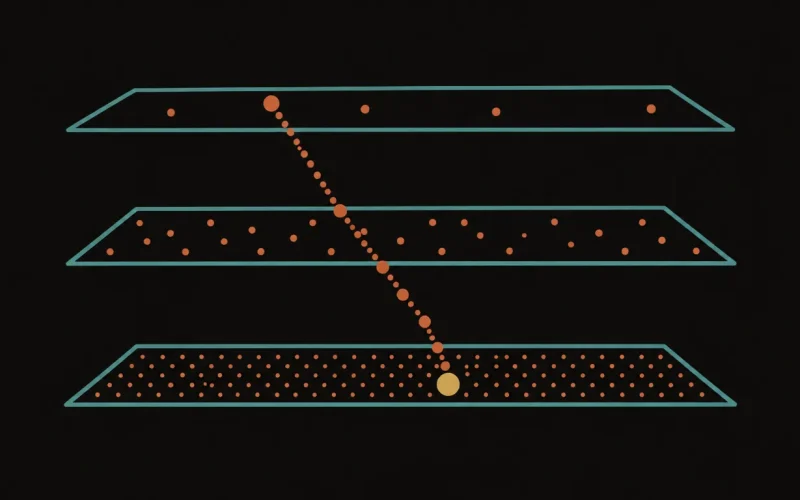
Vector database: come trovano l’ago nel pagliaio
Confrontare una domanda con dieci milioni di vettori, uno per uno, richiederebbe secondi. I database vettoriali rispondono in millisecondi rinunciando…
Analisi long-form 3000+ parole
Confrontare una domanda con dieci milioni di vettori, uno per uno, richiederebbe secondi. I database vettoriali rispondono in millisecondi rinunciando…
Il RAG "da manuale" — trasforma la domanda in un vettore, pesca i pezzi più vicini, incollali nel prompt —…
Offrigli una mancia", "digli che è un esperto mondiale", "minaccialo": il web trabocca di trucchi per parlare ai modelli. Alcuni…
Aggiungere tre parole a un prompt — "ragiona passo per passo" — può trasformare una risposta sbagliata in una giusta.…
I reasoning model non rispondono subito: generano una catena di ragionamento prima della risposta, e più tempo "pensano" più diventano…
I modelli Mixture of Experts hanno centinaia di miliardi di parametri ma ne attivano solo una frazione per ogni token.…
Un modello bravo ma troppo pesante da servire può insegnare a uno più piccolo. La distillazione non copia le risposte…
Specializzare un modello da miliardi di parametri sembra richiedere di riaddestrarlo tutto, con GPU da datacenter e una copia intera…
Un modello da 7 miliardi di parametri che gira su un portatile senza GPU dedicata non è magia: è quantizzazione.…
Ogni token generato da un LLM dovrebbe, in teoria, richiedere di rileggere tutto il testo precedente. Non succede, grazie a…