Precision, recall, F1: la matrice di confusione spiegata
L'accuracy è la metrica più citata e la meno affidabile. Precision, recall e F1 — leggibili tutte da una tabella…
I modelli si somigliano tutti, i dati no. Il feature engineering — trasformare dati grezzi in variabili che parlano al…
Quando i dati vivono in centinaia di dimensioni su superfici curve, la PCA non basta più. t-SNE e UMAP costruiscono…
Un dataset con 30 colonne è illeggibile, ma spesso l'informazione vera vive in due o tre direzioni. La PCA le…
K-means fallisce su cluster a forma irregolare e non conosce il concetto di rumore. DBSCAN e il clustering gerarchico risolvono…
K-means trova gruppi nei dati senza che nessuno gli dica quali cercare. In questo tutorial lo implementiamo da zero in…
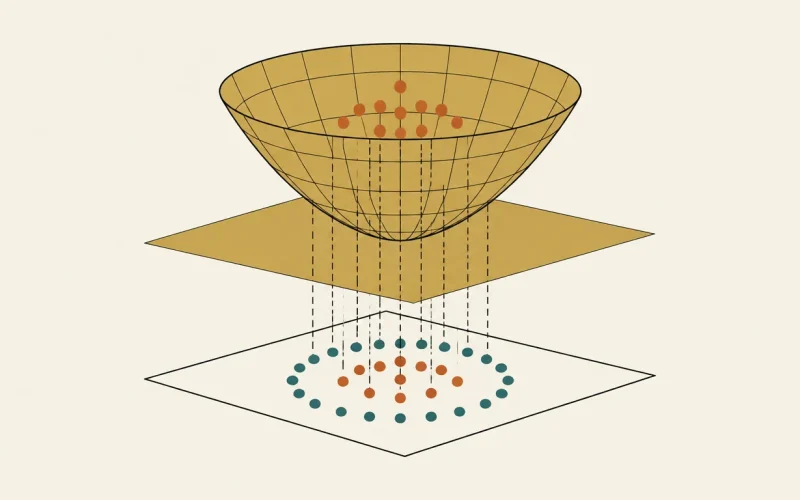
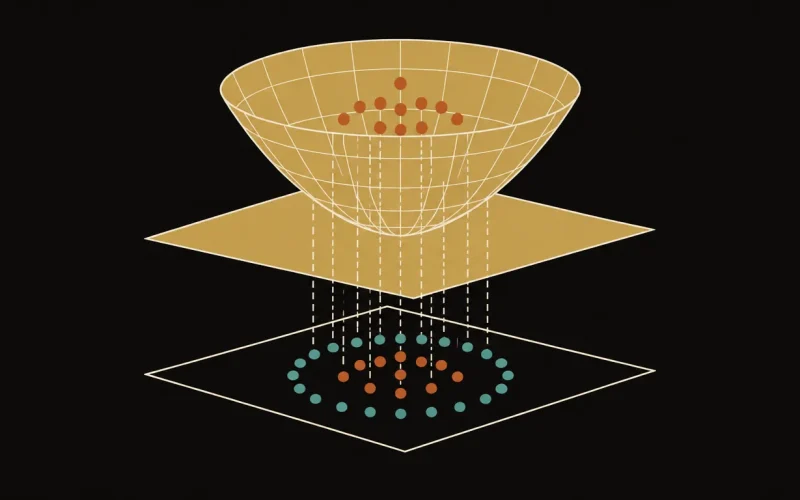
Alcuni dati non si possono dividere con una linea retta, per quanto la si giri. Le support vector machine risolvono…
Un albero debole sbaglia. Un secondo albero impara dagli errori del primo, un terzo da quelli del secondo. Il gradient…
Un albero di decisione singolo è leggibile ma instabile. La random forest ne addestra centinaia, ognuno volutamente diverso, e li…
Come funziona un albero di decisione, perché è il modello più leggibile del machine learning e come addestrarne uno in…