La discesa del gradiente da zero
L'algoritmo che addestra praticamente ogni rete neurale sta in dieci righe di Python. Lo costruiamo da zero, senza librerie di…
Due variabili che si muovono insieme non si stanno necessariamente influenzando. Capire la differenza tra correlazione e causalità — e…
La media di tante osservazioni si avvicina al valore vero, ma lentamente: per dimezzare l'errore servono quattro volte i dati.…
Un modello che memorizza i dati di addestramento invece di coglierne la struttura sembra perfetto, finché non incontra il mondo…
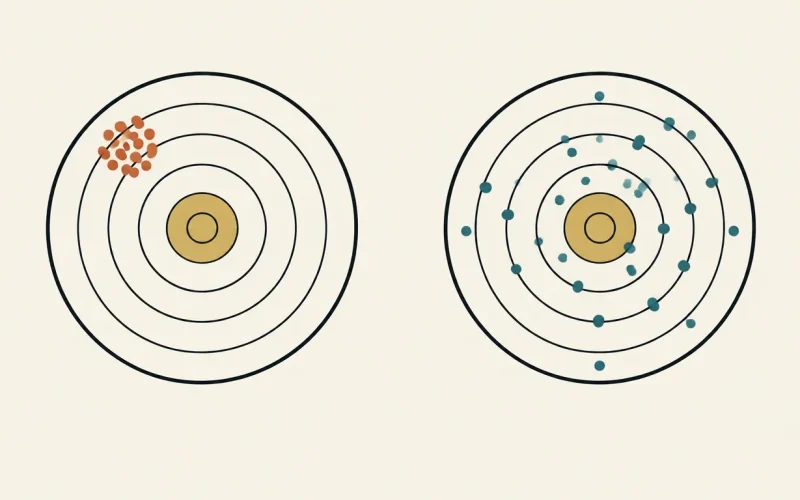
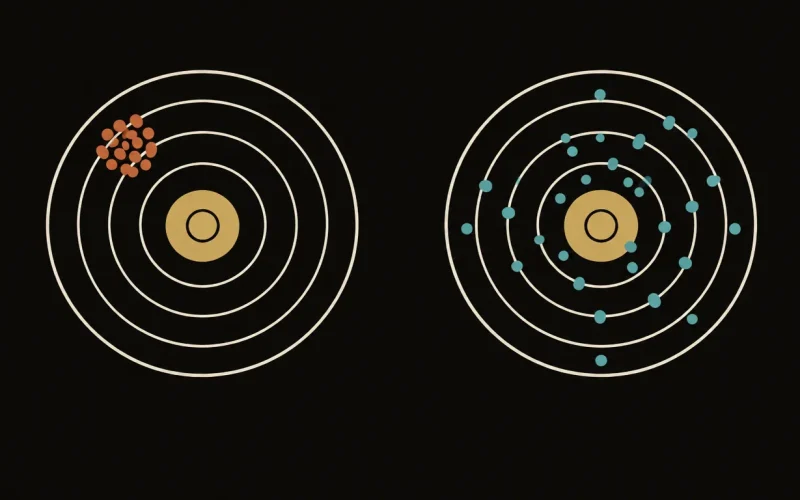
Un modello può sbagliare perché mira male o perché ha la mano che trema — e le due cose richiedono…
Ogni modello linguistico viene addestrato minimizzando un solo numero: la cross-entropy. Capire cosa misura — e cosa misura la sua…
Nel 1948 Claude Shannon trovò il modo di misurare l'informazione con un numero. Quel numero — l'entropia — oggi decide…
Dietro l'addestramento di quasi ogni modello — dalla regressione lineare ai grandi modelli linguistici — c'è un unico principio: tra…
Altezze, errori di misura, rumore nei diffusion model: la curva a campana spunta dappertutto, e non per caso. Da dove…
Un test medico affidabile al 99% ti dice che sei positivo. Quanto devi preoccuparti? Molto meno di quanto pensi. Il…