Random forest: la saggezza della folla di alberi
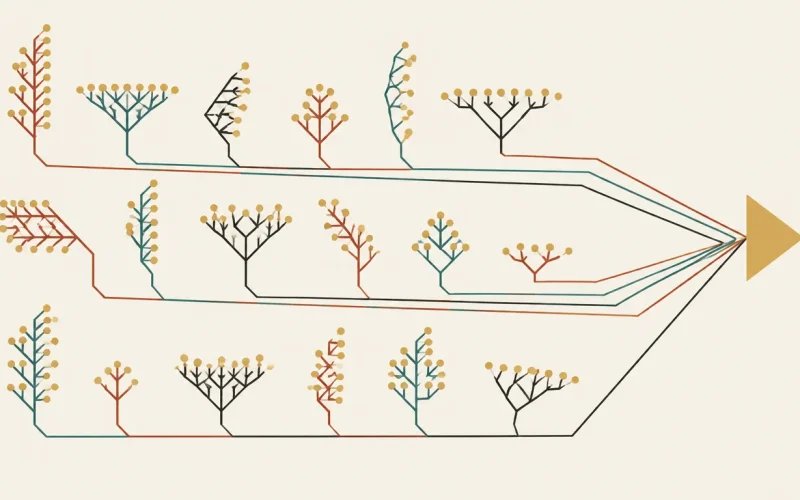
Un albero di decisione singolo è leggibile ma instabile. La random forest ne addestra centinaia, ognuno volutamente diverso, e li…
Analisi long-form 3000+ parole
Un albero di decisione singolo è leggibile ma instabile. La random forest ne addestra centinaia, ognuno volutamente diverso, e li…
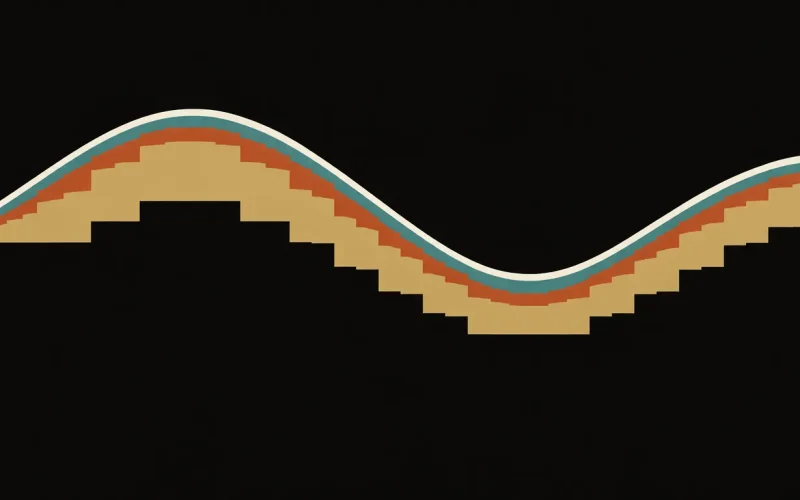
Un albero debole sbaglia. Un secondo albero impara dagli errori del primo, un terzo da quelli del secondo. Il gradient…
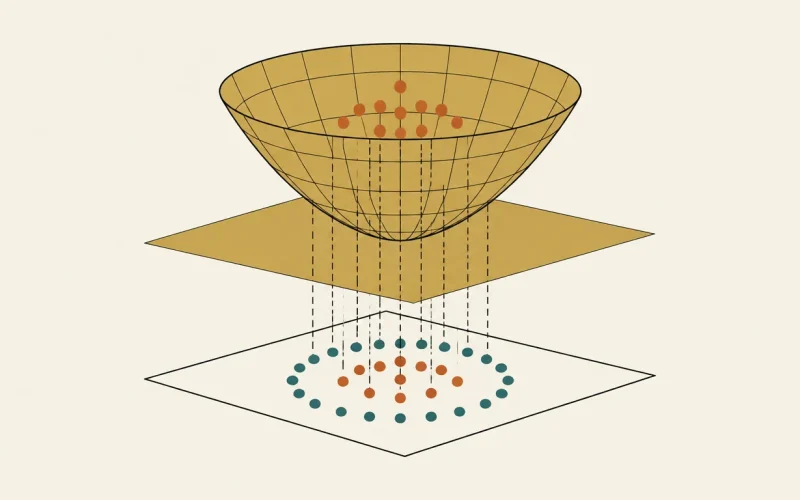
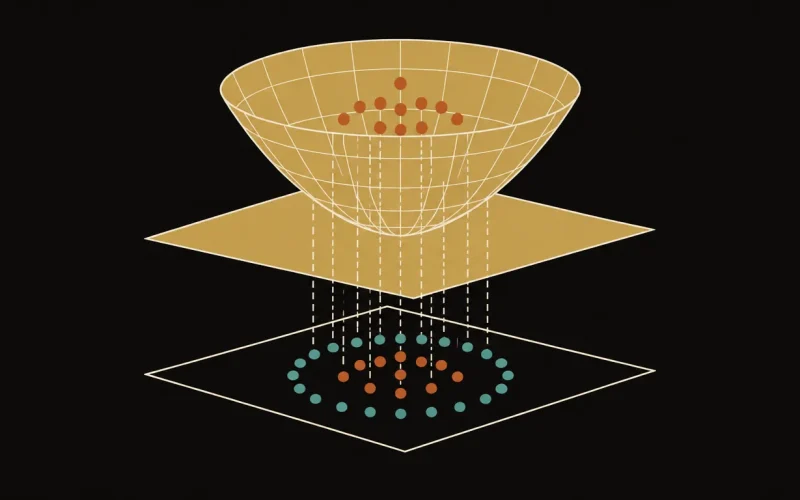
Alcuni dati non si possono dividere con una linea retta, per quanto la si giri. Le support vector machine risolvono…
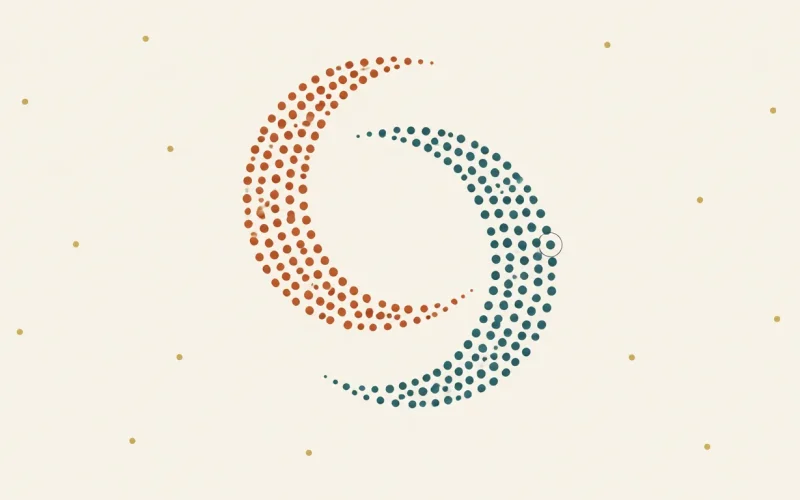
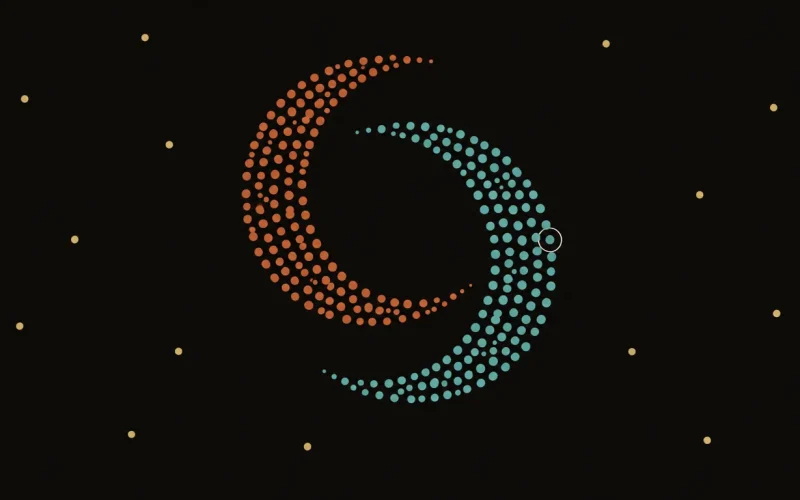
K-means fallisce su cluster a forma irregolare e non conosce il concetto di rumore. DBSCAN e il clustering gerarchico risolvono…
Quando i dati vivono in centinaia di dimensioni su superfici curve, la PCA non basta più. t-SNE e UMAP costruiscono…
I modelli si somigliano tutti, i dati no. Il feature engineering — trasformare dati grezzi in variabili che parlano al…
L'accuracy è la metrica più citata e la meno affidabile. Precision, recall e F1 — leggibili tutte da una tabella…
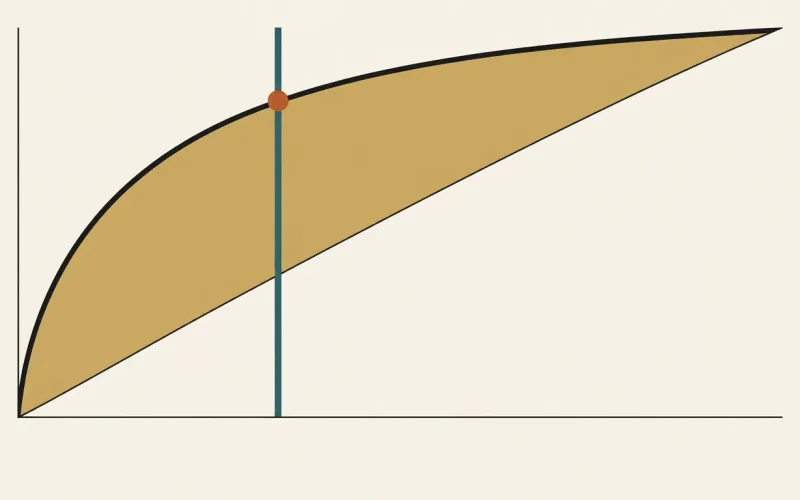
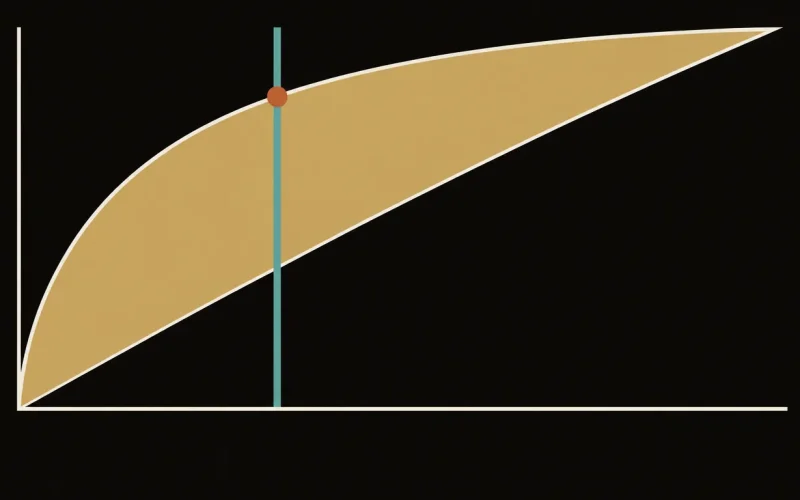
Un classificatore non risponde "sì" o "no": produce un punteggio, e sei tu a decidere dove tagliare. La curva ROC…
Valutare un modello sui dati con cui l'hai addestrato è come correggersi il compito da soli. La cross-validation fa ruotare…
Un modello che impara troppo bene i dati di addestramento smette di funzionare su quelli nuovi. La regolarizzazione L1 e…