Batch normalization: perché stabilizza il training
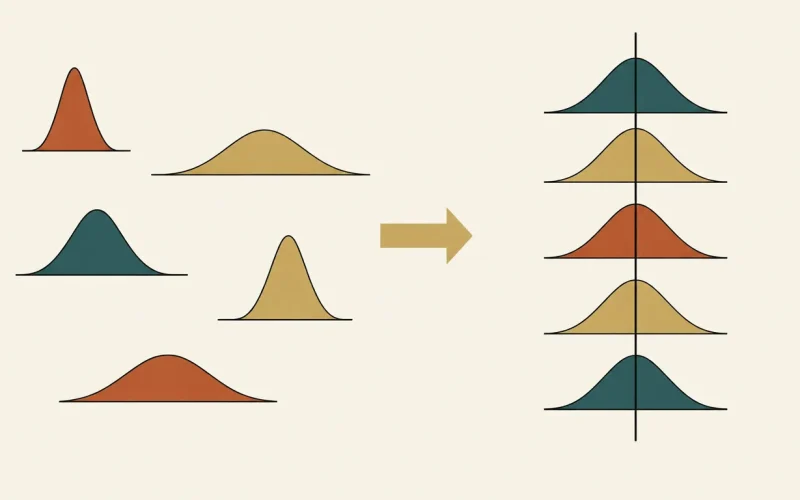
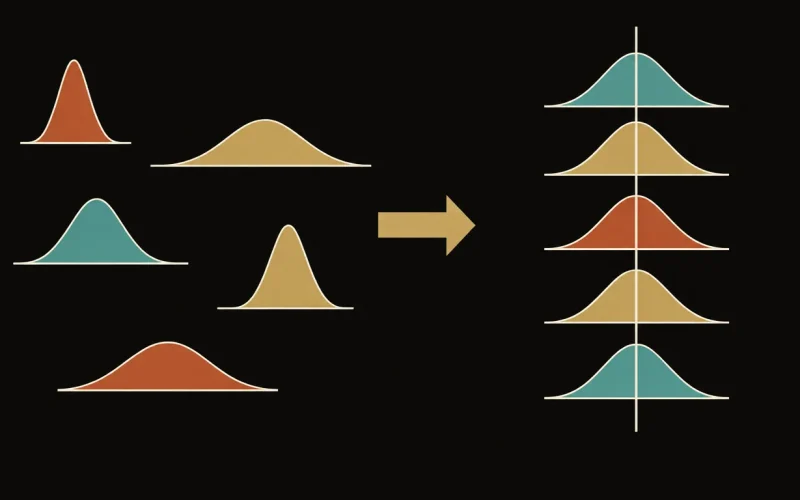
Nel 2015 un'operazione di due righe — sottrai la media, dividi per la deviazione standard — ha reso allenabili reti…
Analisi long-form 3000+ parole
Nel 2015 un'operazione di due righe — sottrai la media, dividi per la deviazione standard — ha reso allenabili reti…
Spegnere a caso una parte dei neuroni durante l'addestramento sembra un modo di sabotare una rete neurale. È invece una…
Prima ancora del primo esempio di training, una rete neurale ha già preso una decisione cruciale: i valori iniziali dei…
Perché le reti neurali profonde per anni non imparavano nulla: il gradiente che si spegne strato dopo strato, il suo…
Una convoluzione è una finestrella di numeri che scorre su un'immagine e risponde a una sola domanda: "qui c'è il…
Per riconoscere un gatto, una rete deve prima dimenticare milioni di pixel. Il pooling è l'arte di buttare via i…
Nel 2015 le reti profonde più di venti strati funzionavano peggio di quelle corte, e nessuno capiva perché. Una connessione…
Le reti ricorrenti sono state la prima idea seria per far leggere a una macchina una sequenza tenendo conto di…
Le reti ricorrenti semplici dimenticano tutto nel giro di poche parole. LSTM e GRU risolvono il problema con un'idea quasi…
Un autoencoder impara a ricostruire i propri input dopo averli fatti passare per una strettoia. Sembra un esercizio inutile, ma…