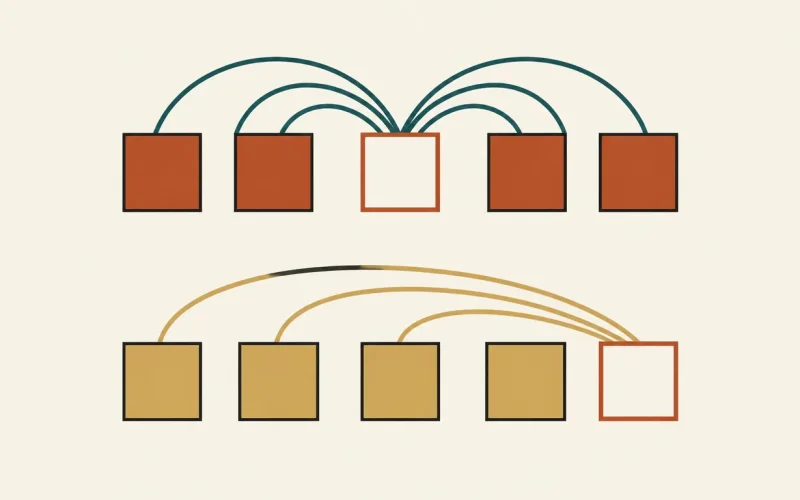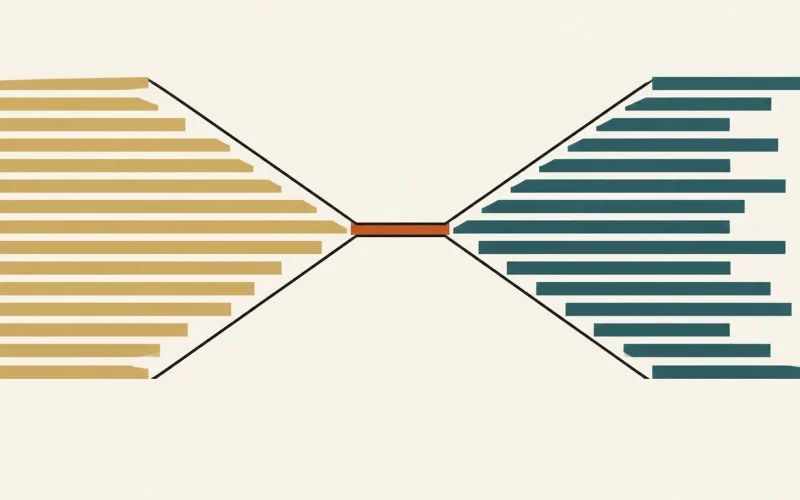
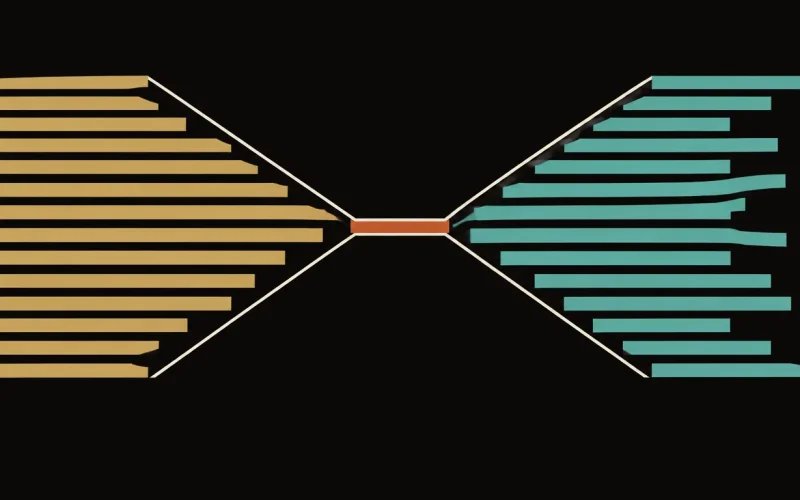
Seq2seq e il collo di bottiglia del vettore unico
Nel 2014 le reti neurali imparano a tradurre comprimendo un'intera frase in un solo vettore di numeri. Funziona sorprendentemente bene,…
Analisi long-form 3000+ parole
Nel 2014 le reti neurali imparano a tradurre comprimendo un'intera frase in un solo vettore di numeri. Funziona sorprendentemente bene,…
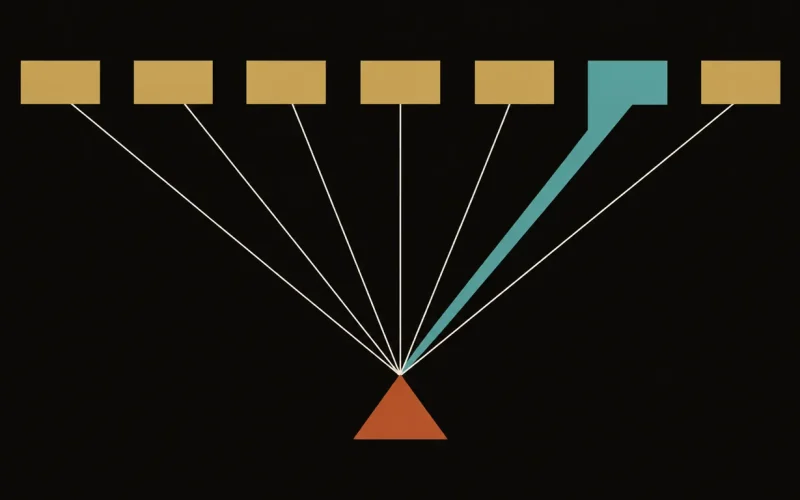
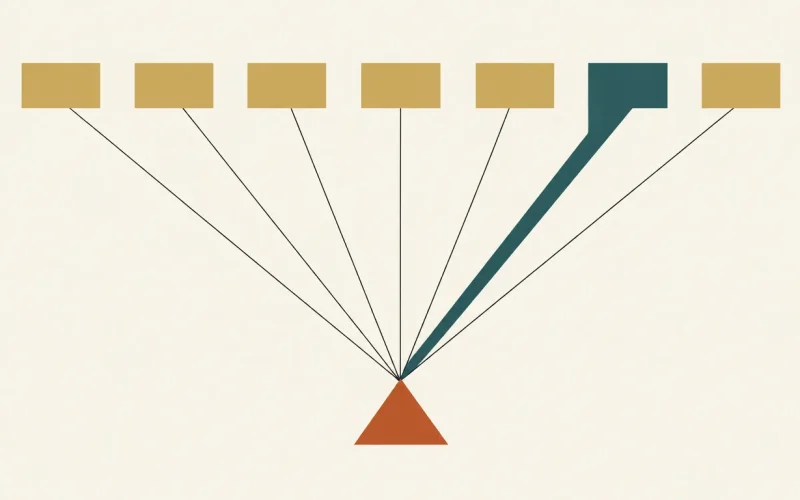
Nel 2015 un meccanismo nato come cerotto per la traduzione automatica insegna alle reti neurali a "puntare il dito" sulla…
Il transformer non è un blocco monolitico ma una pila di componenti semplici — attention, feed-forward, connessioni residue, normalizzazione —…
Il transformer elabora tutti i token in parallelo e, senza correttivi, non distingue "il cane morde l'uomo" da "l'uomo morde…
Due modelli nati dallo stesso Transformer hanno preso strade opposte: BERT legge in entrambe le direzioni per capire, GPT scrive…
Prima si impara la lingua su miliardi di parole, poi si impara il mestiere su pochi esempi mirati. La pipeline…
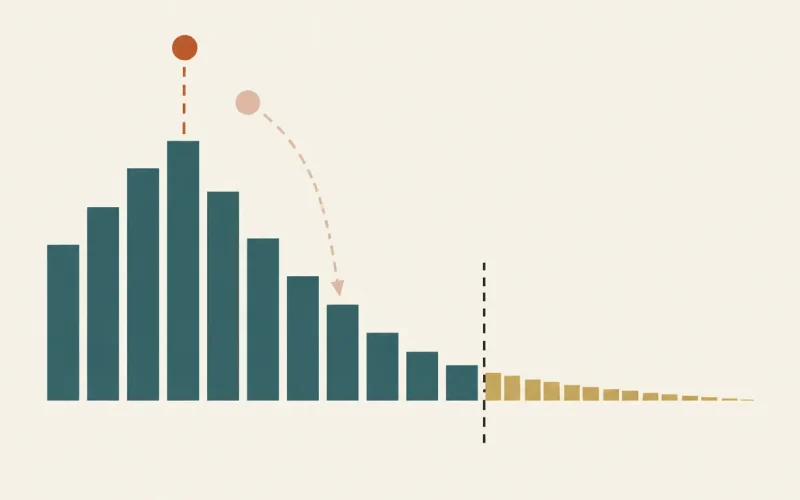
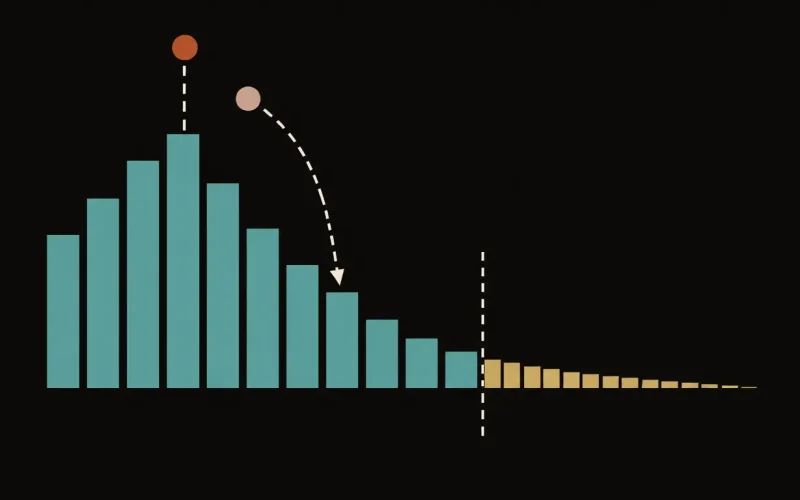
La perplexity è la metrica più citata e meno capita del mondo dei modelli linguistici. Misura una cosa semplice: quanto…
Un LLM non "decide" il prossimo token: pesca da una distribuzione di probabilità. Temperature, top-p e beam search sono i…
La stessa frase, tradotta in italiano, può costare fino al 40-50% di token in più rispetto all'inglese. Non è un…
Estrarre nomi, capire il tono, smistare testi: per vent'anni sono stati problemi da modelli specializzati. Oggi un prompt ben scritto…