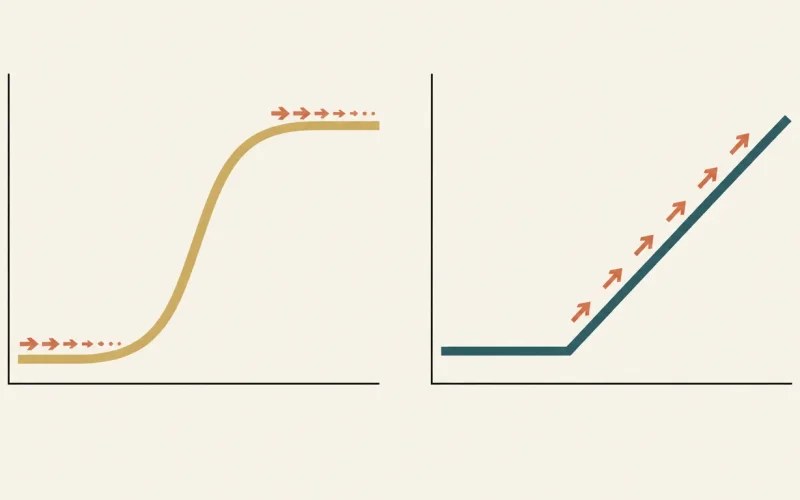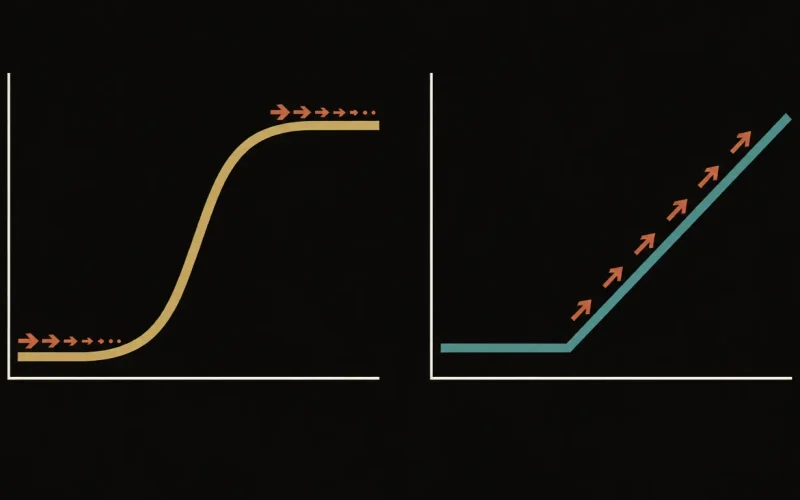
Vanishing e exploding gradients
Perché le reti neurali profonde per anni non imparavano nulla: il gradiente che si spegne strato dopo strato, il suo…
Reti neurali, ottimizzazione, architetture
Perché le reti neurali profonde per anni non imparavano nulla: il gradiente che si spegne strato dopo strato, il suo…
Prima ancora del primo esempio di training, una rete neurale ha già preso una decisione cruciale: i valori iniziali dei…
Spegnere a caso una parte dei neuroni durante l'addestramento sembra un modo di sabotare una rete neurale. È invece una…
Nel 2015 un'operazione di due righe — sottrai la media, dividi per la deviazione standard — ha reso allenabili reti…
Se puoi regolare un solo iperparametro, regola il learning rate. Perché un numero solo può far fallire o riuscire un…
Adam è l'ottimizzatore che quasi tutti usano senza pensarci. Come funziona davvero, perché adatta il learning rate peso per peso,…
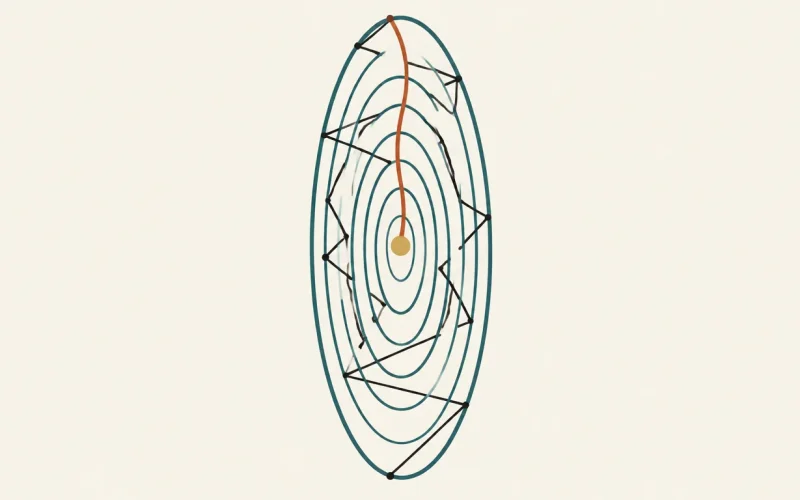
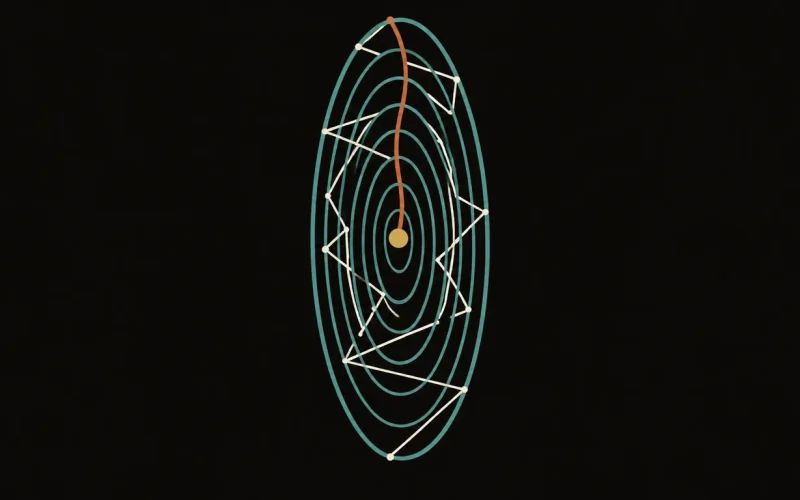
La discesa del gradiente stocastica zigzaga, esita, oscilla. Basta darle un po' di inerzia — una media mobile dei gradienti…
Ogni modello impara solo ciò che la sua loss function punisce. MSE, cross-entropy e il motivo per cui scegliere come…
Per decenni le reti neurali hanno usato curve morbide e matematicamente eleganti. Poi una funzione che si scrive in tre…
Un neurone solo traccia una retta, e con una retta non si risolve nemmeno un interruttore a deviatore. La storia…