Naive Bayes: il filtro antispam che ha 60 anni
Prima dei transformer, a leggere le nostre email c'era un teorema del Settecento e un'ipotesi palesemente falsa. Naive Bayes classifica…
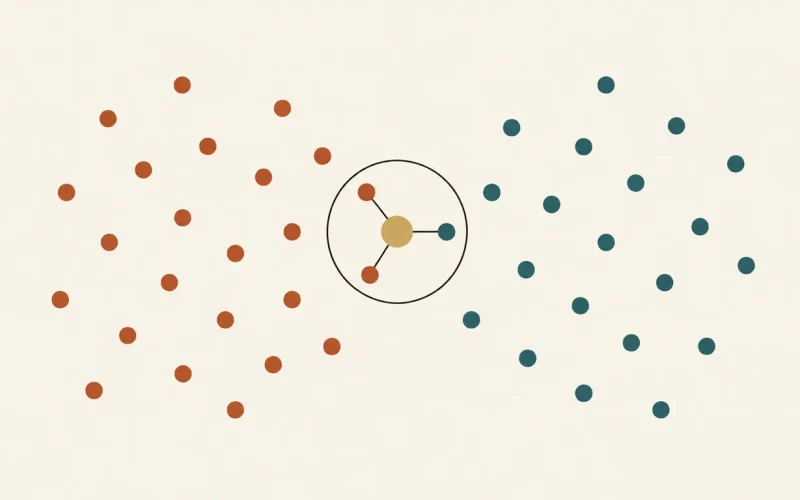
k-NN non impara nulla durante il training: memorizza i dati e classifica ogni nuovo punto guardando i suoi vicini. In…
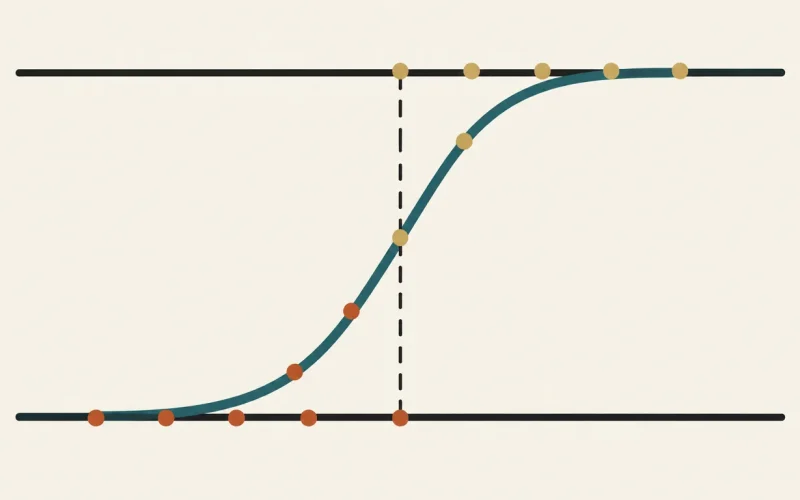
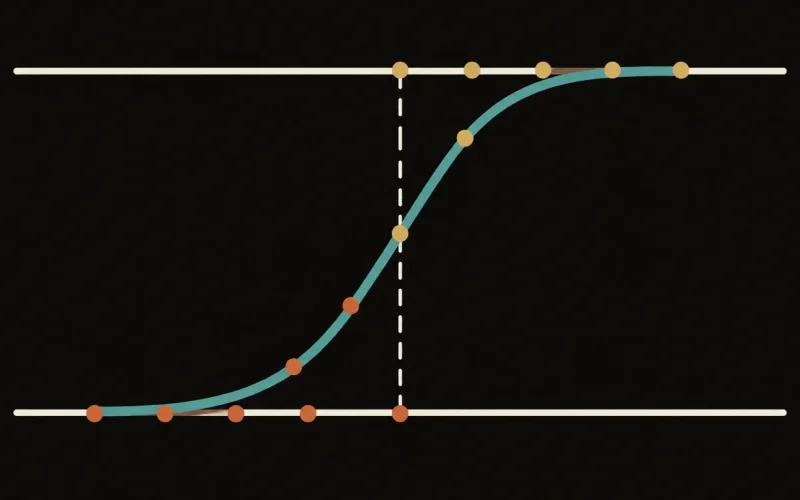
Quando la risposta è sì o no — spam o legittima, promosso o bocciato — la retta non basta più:…
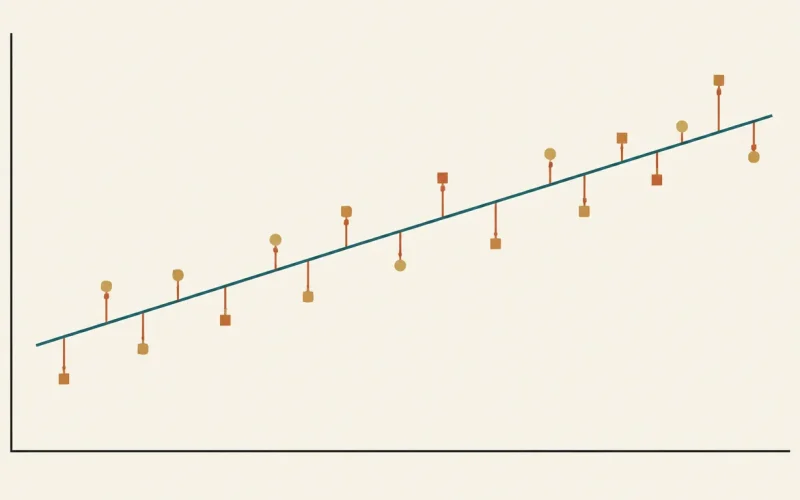
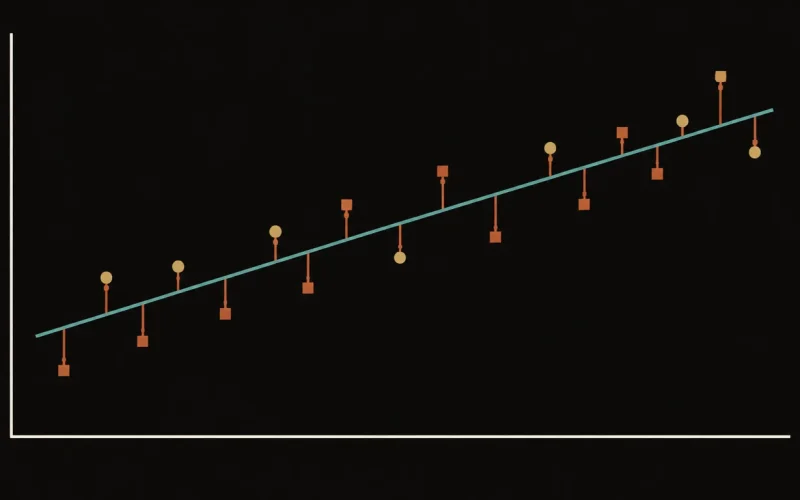
Ha più di due secoli, si risolve con una formula chiusa e resta il primo modello che un data scientist…
Dimezzare i bit di un numero dimezza memoria e costi, ma può far esplodere un training in una cascata di…
In deep learning un tensore non è l'oggetto misterioso della fisica: è una griglia di numeri con più assi. Dalla…
In alta dimensione il volume scappa verso gli angoli, le distanze si appiattiscono e i dati diventano rarefatti. Perché aggiungere…
Un'accuratezza dell'87,2% contro una dell'86,8%: il nuovo modello è migliore o avete misurato il rumore? Senza intervalli di confidenza e…
Il training di una rete neurale è una discesa al buio in un paesaggio con miliardi di dimensioni. I minimi…
L'algoritmo che addestra praticamente ogni rete neurale sta in dieci righe di Python. Lo costruiamo da zero, senza librerie di…